
qwen3-8-27b-nvfp4
от 237,18 ₽/час
Выберите модель и получите ссылку на выделенный масштабируемый эндпоинт для использования в своих сервисах без деплоя сложной инфраструктуры.
от 237,18 ₽/час
от 474,36 ₽/час
от 474,36 ₽/час
от 253,20 ₽/час
от 237,18 ₽/час
от 253,20 ₽/час
от 948,72 ₽/час
от 71,20 ₽/час
от 63,30 ₽/час
от 355,84 ₽/час
от 126,60 ₽/час
от 311,74 ₽/час
от 1 228,20 ₽/час
от 886,80 ₽/час
от 273,74 ₽/час
от 355,84 ₽/час
от 614,10 ₽/час
от 253,20 ₽/час
от 237,18 ₽/час
от 63,30 ₽/час
от 237,18 ₽/час
от 311,74 ₽/час
от 63,30 ₽/час
от 614,10 ₽/час
от 126,60 ₽/час
от 126,60 ₽/час
от 623,48 ₽/час
от 273,74 ₽/час
от 73,83 ₽/час
от 355,84 ₽/час
от 73,83 ₽/час
от 44,66 ₽/час
от 88,96 ₽/час
от 88,96 ₽/час
от 88,96 ₽/час
от 88,96 ₽/час
от 88,96 ₽/час
от 44,66 ₽/час
от 44,66 ₽/час
от 88,96 ₽/час
от 237,18 ₽/час
от 474,36 ₽/час
от 474,36 ₽/час
от 253,20 ₽/час
от 237,18 ₽/час
от 253,20 ₽/час
от 948,72 ₽/час
от 71,20 ₽/час
от 63,30 ₽/час
от 355,84 ₽/час
от 126,60 ₽/час
от 311,74 ₽/час
от 1 228,20 ₽/час
от 886,80 ₽/час
от 273,74 ₽/час
от 355,84 ₽/час
от 614,10 ₽/час
от 253,20 ₽/час
от 237,18 ₽/час
от 63,30 ₽/час
от 237,18 ₽/час
от 311,74 ₽/час
от 63,30 ₽/час
от 614,10 ₽/час
от 126,60 ₽/час
от 126,60 ₽/час
от 623,48 ₽/час
от 273,74 ₽/час
от 73,83 ₽/час
от 355,84 ₽/час
от 73,83 ₽/час


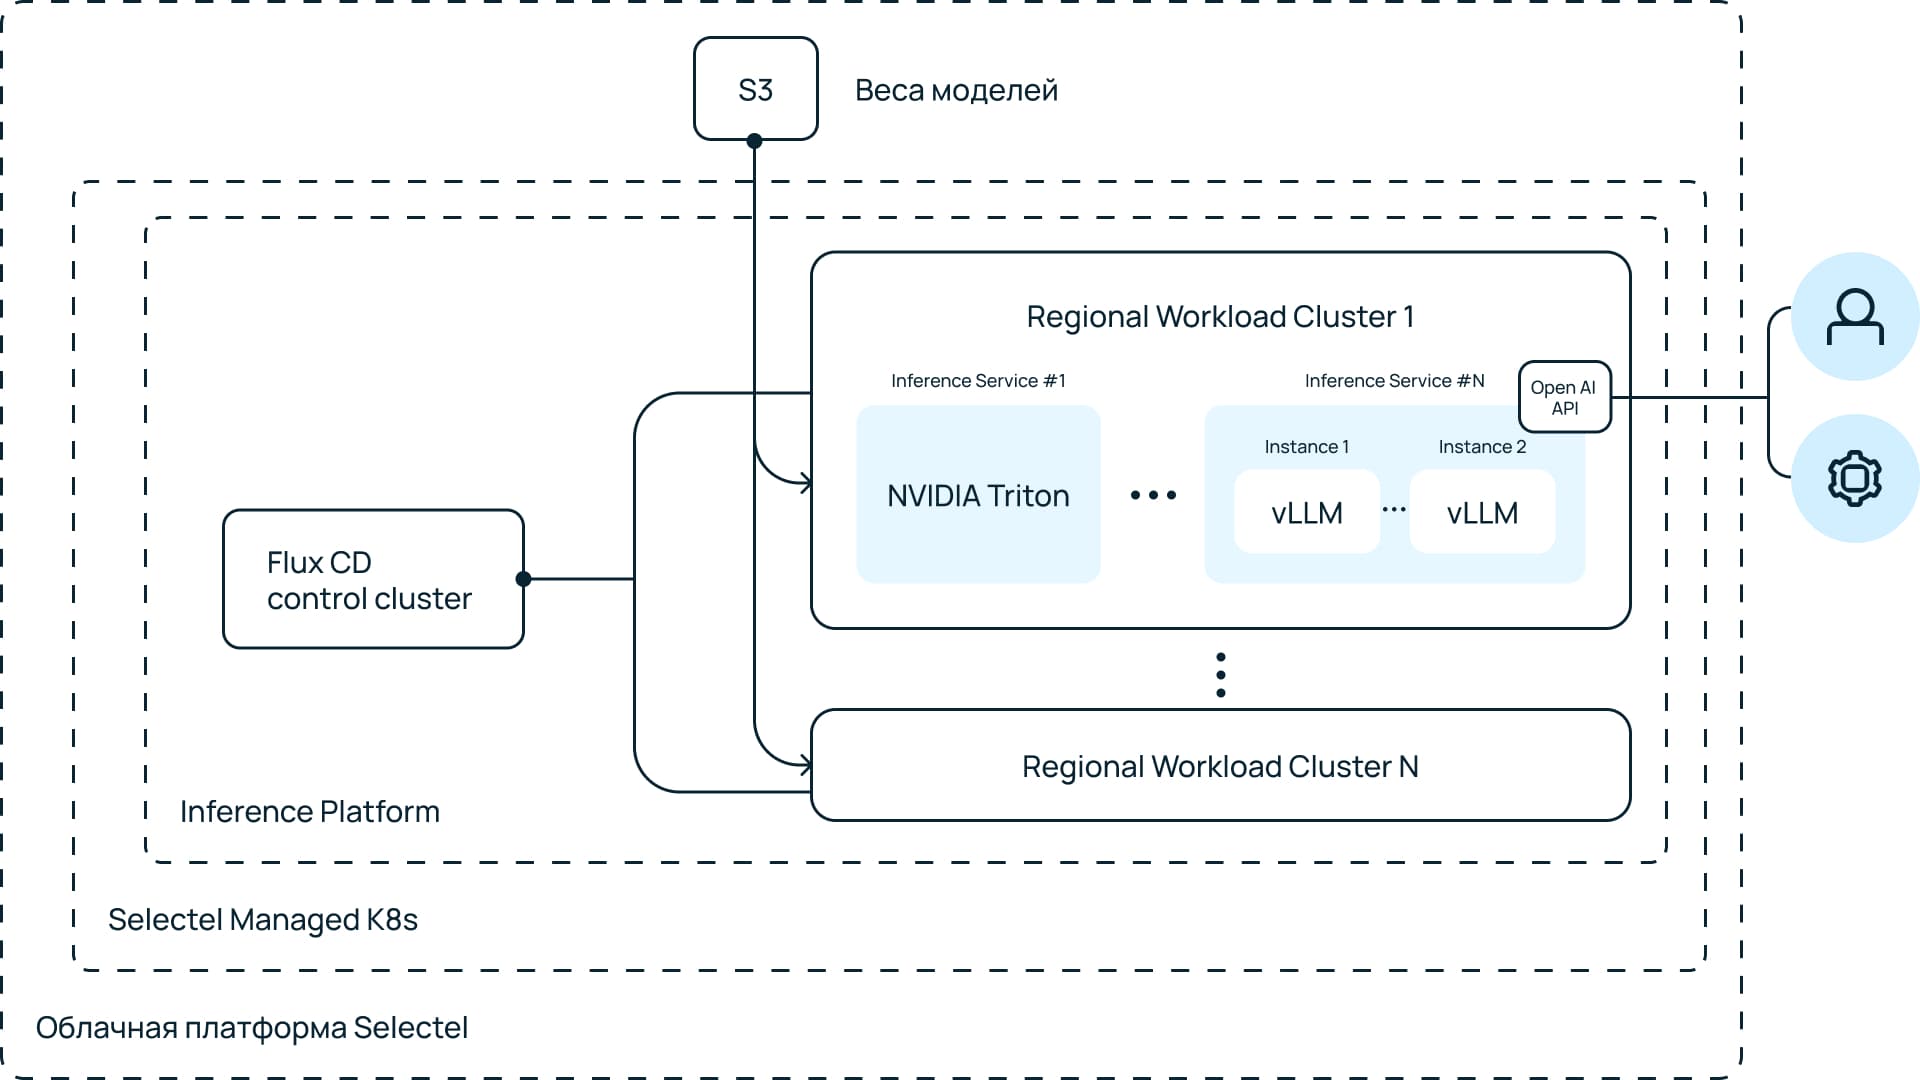
Selectel Dedicated Inference позволяет быстро подключать крупные языковые и мультимодальные модели через готовый API. Вы выбираете подходящую модель из каталога, а платформа сама разворачивает ее на подходящей инфраструктуре и выдает endpoint с токеном доступа. Интеграция и бизнес-логика остаются на вашей стороне.
Доступ по приватному IP-адресу внутри вашей виртуальной сети (VPC). Запросы не выходят в публичный интернет — только по защищенным каналам или локальной сети. Персональные данные обрабатываются в соответствии с 152-ФЗ.
Модели легко интегрировать в ваши проекты и сервисы. Используйте готовые эндпоинты и API-ключи для безопасного доступа, подключайте модели через привычные методы, автоматизируйте работу через CI/CD и бэкенд.
Десятки моделей готовы к использованию. Мы оперативно пополняем каталог, а по индивидуальному запросу готовы внедрить любую модель с ограничением видимости — она будет доступна только вам.
Стоимость рассчитывается, исходя из фактического времени потребления ресурсов (CPU, GPU, RAM, объем дисков). Бюджет проекта не зависит от потребления токенов.
Инференс-сервис сам подстраивается под изменения нагрузки: при росте запросов добавляются новые ресурсы, при снижении — отключаются лишние.
Мы заранее протестировали модели на разных конфигурациях и зафиксировали бенчмарки. Вам остается только выбрать подходящий вариант и сразу начать работу. В наличии — NVIDIA® HGX B300, H200, RTX 6000 PRO, L4, RTX 4090 и другие.


Инфраструктура соответствует требованиям Центрального банка России
Работаем в соответствии с регламентами ISO/IEC 27001, ISO/IEC 27017, ISO/IEC 27018
Используйте на проектах, где собираются и обрабатываются персональные данные
Можем хранить банковские данные без ограничений со стороны регуляторов
Разграничивайте доступ к ресурсам и данным, определяйте роли
О Dedicated Inference
Быстрый старт
Создание inference-сервиса
Масштабирование
Dedicated Inference — это каталог преднастроенных ML-моделей с готовым API. Модели развертываются в виде изолированных inference-сервисов с выделенными ресурсами (GPU, vCPU, RAM, диск).
Работать с моделью можно через выделенный масштабируемый эндпоинт. Эндпоинт совместим с OpenAI API.
Inference-сервис — базовая единица развертывания в Dedicated Inference. Это изолированный сервис с выделенными ресурсами (GPU, vCPU, RAM, диск), который предоставляет API для взаимодействия с предварительно обученной моделью.
Конфигурации inference-сервисов подбираются автоматически в зависимости от выбранной модели и ее параметров. При выборе конфигурации вы можете посмотреть ожидаемые метрики производительности модели.
Inference-инстанс — это развернутый экземпляр модели в inference-сервисе. Вы можете изменять количество inference-инстансов, чтобы оптимально использовать ресурсы inference-сервиса. Подробнее в инструкции Масштабировать inference-сервис.
Inference-сервер — это программный компонент, который организует работу модели. Он принимает запросы от клиентов, подготавливает данные, запускает модель для выполнения вычислений и возвращает результат.
В Dedicated Inference используются разные типы inference-серверов. Тип сервера зависит от выбранной модели. Например, для больших языковых моделей (LLM) используется inference-сервер vLLM.
На стадии публичного тестирования (public preview) модели можно развернуть в виде inference-сервисов только на выделенных ресурсах и работать с ними в синхронном режиме.
В Dedicated Inference не предусмотрена возможность загрузки своих моделей.
Нет, сделать это оn-premise, в А-ЦОД, на выделенных серверах и в аттестованном облаке Selectel сейчас нельзя. Развертывать модели из Dedicated Inference можно только в публичном облаке Selectel.
Стоимость зависит от выбранной конфигурации inference-сервиса. При использовании inference-сервиса вы платите только за ресурсы облачной платформы: GPU, vCPU, RAM, размер диска. Стоимость не зависит от количества токенов.
В облачной платформе используется модель оплаты pay-as-you-go. С баланса каждый час списываются средства за предыдущий час использования ресурсов облачной платформы. Подробнее в инструкции Модель оплаты и цены Dedicated Inference.
Перед созданием inference-сервиса пополните баланс.
Присоединяйтесь — нам есть, о чем рассказать: запускаем новые продукты, проводим мероприятия и акции.
ПодписатьсяЗвоните 8 800 555-06-75 или пишите sales@selectel.ru — изучим задачу и подберем подходящее решение.
Если у вас проблема в работе услуг — создайте тикет.
© АО «Селектел», 2008–2026
Лицензия на телематические услуги № 176267