
Готовая инфраструктура для инференса ИИ-моделей
Selectel берет на себя развертывание моделей на собственных серверах и поддержку инфраструктуры, чтобы вы сразу начали использовать нужные модели для решения ваших задач.
Доступные модели
GLM-5.3-flash
| Входные токены, 1 млн | 74,64 ₽ |
| Генерируемые токены, 1 млн | 248,55 ₽ |
| Чтение кеша, 1 млн | 7,46 ₽ |
| Скорость инференса | 76,87 токенов/с |
| Контекстное окно | 262 144 токенов |
DeepSeek-V4-Flash
| Входные токены, 1 млн | 75,42 ₽ |
| Генерируемые токены, 1 млн | 186,29 ₽ |
| Чтение кеша, 1 млн | 7,54 ₽ |
| Скорость инференса | 75,23 токенов/с |
| Контекстное окно | 393 216 токенов |
Qwen-3.8-Flash-Next
| Входные токены, 1 млн | 20,85 ₽ |
| Генерируемые токены, 1 млн | 61,30 ₽ |
| Чтение кеша, 1 млн | 2,09 ₽ |
| Скорость инференса | 94,35 токенов/с |
| Контекстное окно | 262 144 токенов |
Qwen-3.8-27B
| Входные токены, 1 млн | 31,01 ₽ |
| Генерируемые токены, 1 млн | 206,50 ₽ |
| Чтение кеша, 1 млн | 3,10 ₽ |
| Скорость инференса | 88 токенов/с |
| Контекстное окно | 256 000 токенов |
Kimi-K2.7-Code
| Входные токены, 1 млн | 157,20 ₽ |
| Генерируемые токены, 1 млн | 628,70 ₽ |
| Чтение кеша, 1 млн | 15,72 ₽ |
| Скорость инференса | 35,01 токенов/с |
| Контекстное окно | 262 144 токенов |
Больше ИИ-моделей в панели управления
Каталог моделей постоянно пополняется. Актуальные цены и параметры доступны в панели управления.
Преимущества Token Factory
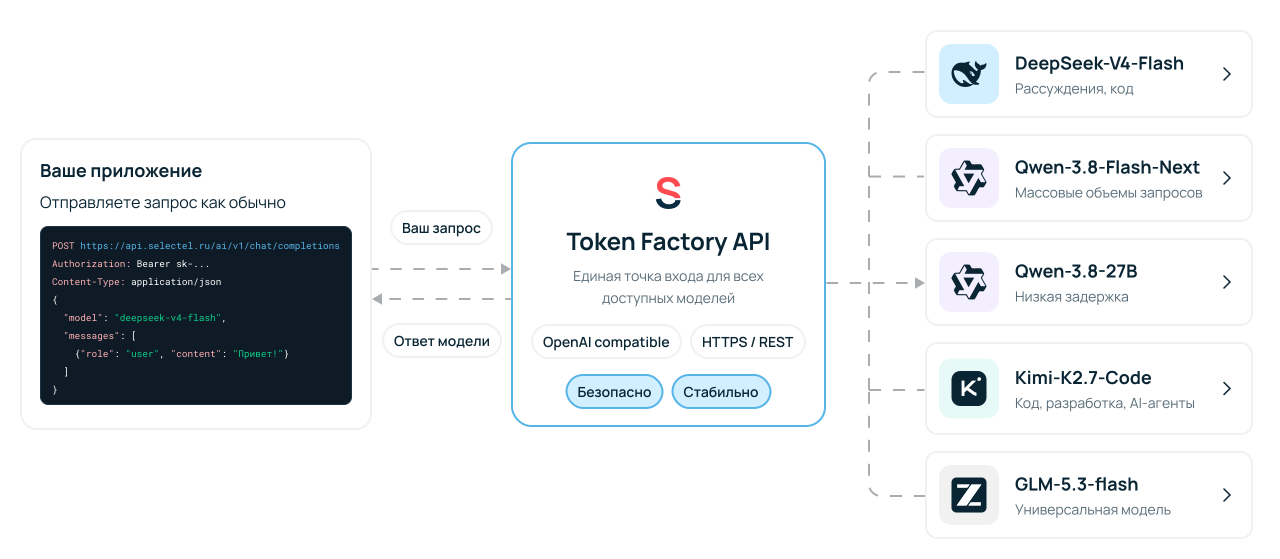
Единый OpenAI-совместимый API
Позволяет менять подключенные к проекту модели и добавлять новые без перестройки всей интеграции.
Оплата за потребление и прозрачный биллинг
Вы платите только за фактически обработанные токены, а не за арендованный сервер. Цены на входящие и исходящие токены известны заранее, а в панели управления есть детализация расходов за любой период.
Политика нулевого хранения
Мы не храним ваши промпты и ответы моделей, не логируем запросы и не используем ваши данные для дообучения нейросетей. Конфиденциальность информации гарантируется для всех клиентов.
Оптимизация на стороне платформы
Оптимизированный алгоритм работы с запросами позволяет максимально эффективно использовать мощности инфраструктуры Selectel.
Инфраструктура в России
Запросы обрабатываются на инфраструктуре Selectel в России. Данные не покидают периметр страны и не передаются зарубежным провайдерам моделей.
От выбора модели до первого запроса за 2 минуты
Выберите модель
Сравните доступные модели по стоимости, скорости, размеру контекста и поддерживаемым возможностям.
Подключите API
Выпустите API-ключ в панели управления, задайте ему имя и срок действия. При необходимости установите лимит потребления.
Начните работу
Используйте ключ в своем приложении — Token Factory обработает запрос и вернет ответ модели.
Разные модели, единый API
Меняйте модели, подключенные к вашему приложению, без перестройки интеграции, и управляйте лимитами токенов по мере роста нагрузки.
Для задач, где нужен готовый инференс
- AI-фичи в продуктах
Подключайте модели к приложениям через API, совместимый с OpenAI. Суммаризация, классификация обращений, генерация описаний и поиск по смыслу работают без отдельной инфраструктуры под каждую функцию. Нагрузка растёт вместе с продуктом, а оплата — по фактическому потреблению.
- Разработка и AI-агенты
Используйте модели для генерации кода, ревью, анализа унаследованного кода и автоматизации рутины. Совместимость с API OpenAI позволяет подключать привычные инструменты без переписывания интеграций. В агентских сценариях с длинными цепочками вызовов оплата за токены предсказуемее, чем аренда выделенных ресурсов.
- RAG и работа с документами
Стройте поиск и ответы по собственной базе знаний: регламентам, договорам, технической документации. Модели с длинным контекстом обрабатывают большие документы целиком, а данные остаются в российском контуре.
- Прототипирование и исследования
Сравнивайте модели на своей задаче, не покупая GPU заранее. Модель в каталоге меняется одним параметром в запросе, поэтому проверка гипотезы занимает часы, а не недели согласований. Неподтверждённая гипотеза стоит столько, сколько токенов на неё ушло.
- Внутренние ассистенты
Создавайте помощников для сотрудников на собственной прикладной логике: поддержка первой линии, адаптация новых сотрудников, ответы по внутренним процессам. Выполнение моделей происходит в России, поэтому во внутренние сценарии можно передавать данные, которые не отправляют во внешние сервисы.
Попробуйте Token Factory
Зарегистрируйтесь в панели управления Selectel и начните работать с ИИ-моделями с оплатой за токены уже сегодня.
консультацию в любое время
FAQ
- Что такое Token Factory?
Token Factory — сервис для инференса (работы обученных AI-моделей) через единый API. Вы выбираете модель, подключаете ее к своему приложению и платите за фактически использованные токены.
- Нужно ли мне самостоятельно арендовать сервер с GPU, чтобы начать пользоваться Token Factory?
Нет, вся инфраструктура для инференса предоставляется Selectel.
- Нужно ли мне уметь писать код, чтобы пользоваться AI-моделями в Token Factory?
Нет, вам не нужно ни скачивать модели, ни обучать их — они полностью готовы к работе.
- За что именно я плачу?
Вы платите только за фактическое потребление токенов. Актуальная цена зависит от конкретной AI-модели и типа токенов.
- Можно ли использовать несколько моделей одновременно?
Да, вы можете пользоваться любыми моделям, подключенными к вашему проекту, через единый API-ключ.
- Можно ли ограничить расходы?
Да, вы можете задать лимиты и квоты на потребление для API-ключей (проектов).
- Где обрабатываются данные?
Обработка выполняется на инфраструктуре Selectel в России.
- Можно ли посмотреть, сколько токенов потратил конкретный ключ?
Да, в панели управления доступна детализация потребления по ключам, моделям, типам токенов и периодам.
- Можно ли выгрузить отчет для бухгалтерии?
Да, детализацию потребления можно скачать в CSV или PDF.