Облачная LLM на 16 ГБ VRAM — часть 3: ChatGPT-интерфейс для ваших LangGraph-агентов

Статья подготовлена автором Telegram-канала «Легкий путь в Python» Алексеем Яковенко.
Друзья, возвращаюсь с финальной частью цикла.
За две предыдущие статьи мы прошли немалый путь: подняли собственную облачную LLM на 16 ГБ VRAM, разобрались с vLLM и tool calling, собрали агентный бэкенд на LangGraph с MCP-серверами, получили вокруг него полноценный REST API из коробки и обернули все это в FastAPI-сервис через LangGraph SDK.
Серьезная инфраструктура — и она реально работает.
Но есть нюанс. Все, что мы собрали, — это бэкенд. Красивый, правильно устроенный, с трейсингом и персистентностью. Только вот показать его обычному пользователю, который привык к ChatGPT, пока не получится — curl в терминале его не впечатлит, а давать доступ к LangSmith, мягко говоря, неправильно. Сегодня это исправляем.
Предыдущие материалы серии:
Облачная LLM на 16 ГБ VRAM — часть 1;
Облачная LLM на 16 ГБ VRAM — часть 2.
Оказывается, у LangChain есть официальный ответ на вопрос «А где фронтенд?» — проект agent-chat-ui. Это готовый Next.js-интерфейс, который из коробки умеет подключаться к LangGraph Server, стримить токены, показывать шаги агента, вызовы инструментов и размышления модели в реальном времени. По духу — тот же ChatGPT, только работает на вашей инфраструктуре и полностью под вашим контролем.
Схема подключения предельно простая: клонируем репозиторий, прописываем в .env адрес нашего LangGraph Server и имя агента, запускаем. Примерно так же, как в прошлой части мы одной командой получали REST API вокруг графа, — здесь одной командой получаем UI вокруг этого API.
Сегодня закрываем полный цикл:
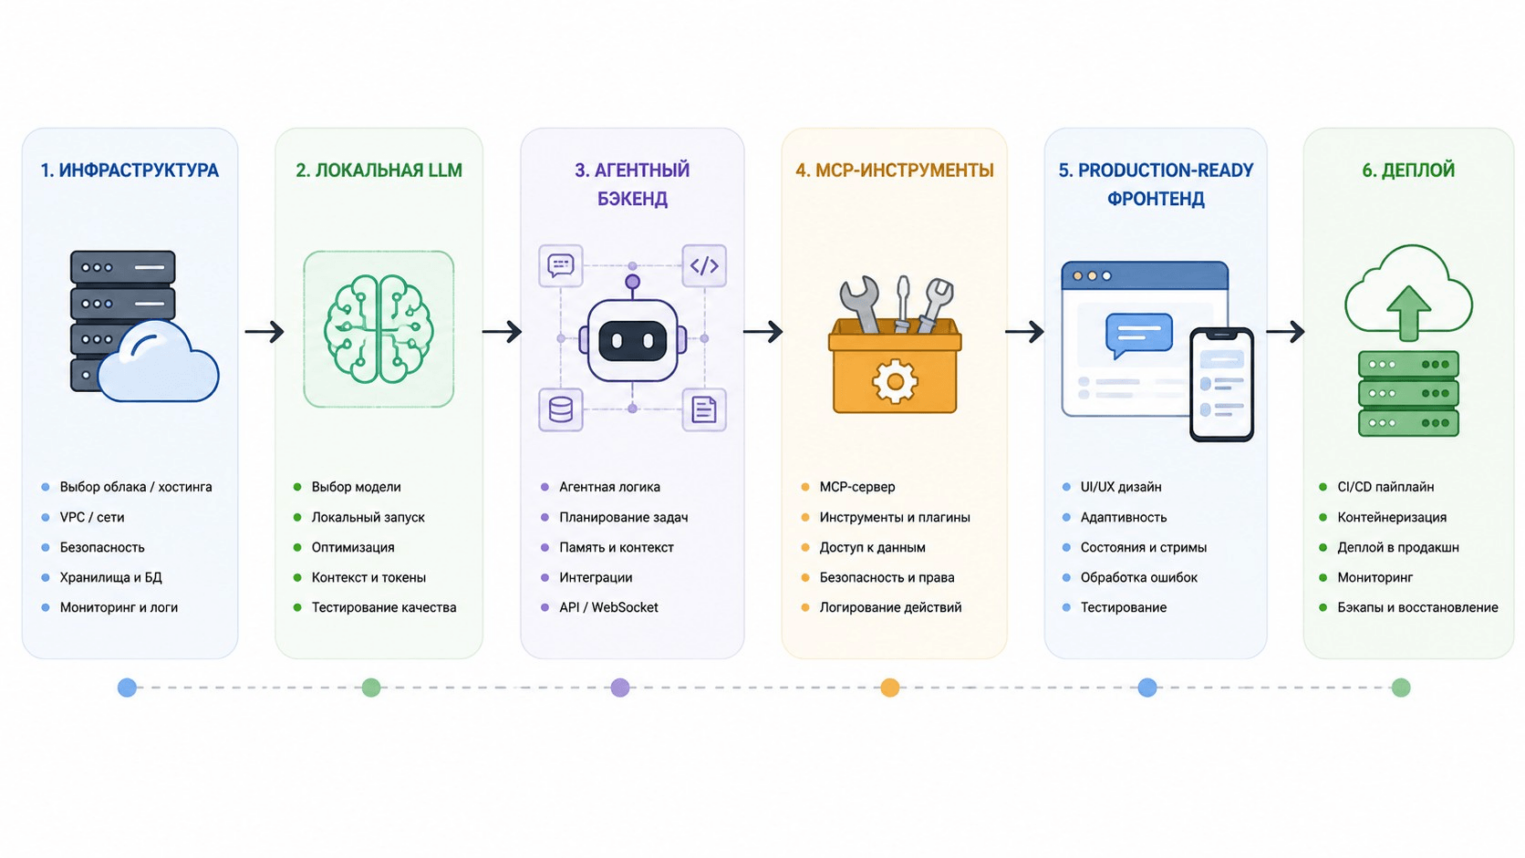
Подходы к разработке UI и безопасность
Прежде чем лезть в код, хочу сделать небольшое отступление — про подходы к UI в контексте агентов. Чтобы то, что мы будем делать дальше, воспринималось как осознанный выбор, а не единственно возможный путь.
Подходов, по большому счету, два, но есть и третий — гибридный, и о нем тоже расскажу.
Первый — вы берете REST API от LangGraph Server, пишете вокруг него собственную обертку через LangGraph SDK (как мы делали в прошлой части) и уже поверх этой обертки реализуете фронтенд с нуля под свои нужды.
Второй — берете тот же REST API, подключаете к нему готовый фронтенд и кастомизируете его под себя. Именно этим мы займемся сегодня.
Третий — гибрид. agent-chat-ui умеет работать в режиме API Passthrough: все запросы к LangGraph Server идут не напрямую с клиента, а через Next.js API routes на том же сервере. Фронтенд смотрит наружу, LangGraph API остается внутри контура, LangSmith-ключ инжектируется на сервере и клиент его никогда не видит.
Разница между подходами не только в объеме работы, но и в вопросах безопасности — и это важно понимать до старта.
В первом случае вы контролируете все: авторизацию, очереди, ограничения доступа. Ваша FastAPI-обертка стоит между пользователем и графом, и даже если кто-то доберется до Swagger — без нужных токенов он там ничего не сделает.
Во втором случае вы подключаете к «голому» LangGraph API готовый фронтенд напрямую. Быстро и удобно, но с жестким условием: API не должен быть доступен из сети. Только изнутри контура. Это не рекомендация — это обязательное требование такой схемы.
Третий путь закрывает эту дыру без необходимости писать собственный бэкенд — и по итогу мы получаем вполне серьезный уровень защиты даже при использовании готового фронта.
Именно его мы и разберем в блоке про деплой, чтобы выжать из этого подхода максимум по безопасности.
Чем мы сегодня займемся
Статья вышла объемным лонгридом, поэтому расскажу конкретнее — что будем делать и в каком порядке.
Шаг первый — поднимем локально LangGraph CLI и добавим три агента. Этот блок пробежим быстро: архитектуру графов детально разбирали в прошлой части, здесь просто возьмем мой проект с GitHub и немного доработаем под наши нужды. В итоге у нас будет запущенный LangGraph Server с несколькими графами — это и станет бэкендом для нашего фронтенда.
Шаг второй — клонируем agent-chat-ui и запустим его «из коробки» с одним агентом. Никакой безопасности, никакой кастомизации — просто три строки в .env, pnpm dev и смотрим что получается. На этом этапе вы увидите стриминг токенов в реальном времени, размышления Qwen, визуализацию вызовов MCP-инструментов и историю тредов — все это работает сразу, без единой строчки кода с нашей стороны.
Цель этапа — понять общий принцип и потрогать руками до того, как начнем что-то менять.
Шаг третий — отдельно займемся авторизацией и аутентификацией. Здесь разберем оба встроенных механизма которые LangChain уже вложил в проект: простой API Passthrough через Next.js routes — когда все запросы к LangGraph идут через сервер и LangSmith-ключ никогда не попадает на клиент, и кастомную авторизацию через Bearer-токен для тех, кто хочет полный контроль. Никаких велосипедов — только то, что уже есть в проекте.
Шаг четвертый — кастомизация. Это самый объемный блок. Переведем UI на русский язык, добавим переключатель между несколькими агентами, чтобы пользователь мог выбирать с каким графом работать прямо в интерфейсе, и докрутим пару фич, которых в оригинальном проекте нет. Покажу конкретные места в коде, которые нужно трогать, и объясню, почему именно они.
Шаг пятый — финал. Деплоим все на сервер: собираем Next.js, поднимаем рядом с LangGraph Server через docker-compose, закрываем все это Nginx с SSL. LangGraph API остается внутри контура, наружу смотрит только фронт. Закрываем цикл и обсуждаем, что со всем этим делать дальше.
Будет интересно. Поехали.
Готовим бэкенд и первого агента
Для работы с фронтендом нам нужен запущенный LangGraph Server хотя бы с одним графом. Здесь у вас два пути: берете свои наработки из прошлой части — тогда этот раздел можно пропустить, — или клонируете мой проект и идете по инструкции ниже.
Единственное условие независимо от выбора: в проекте должен быть хотя бы один агент с поддержкой сохранения истории сообщений. Без этого треды на фронтенде работать не будут — почему именно так, я детально разбирал в прошлой части.
Клонируем проект
git clone https://github.com/Yakvenalex/HabrGraphCLI
Проект открытый, проблем с доступом не будет.
Настраиваем окружение
В корне создаем файл .env.
Коротко по каждой переменной:
LANGSMITH_PROJECT— имя проекта для группировки трейсов в дашборде LangSmith. Любое значение на ваш вкус;LANGSMITH_API_KEY— ключ для трейсинга. С ним в дашборде видно каждый шаг графа: активные узлы, входы и выходы каждого вызова модели, латентность, токены, ошибки. Без него граф работает нормально — просто без мониторинга;LLM_BASE_URL— адрес вашей модели. Поднимали LLM через vLLM вместе с первой частью и пробросили наружу — указываем https://your_domain/v1. Модель работает локально без проброса — http://localhost:8000/v1;LLM_KEY— ключ, который задавали при запуске vLLM;LLM_NAME— название модели, которое будет передаваться в запросах.
Детально каждую переменную разбирал в предыдущей статье.
Запуск
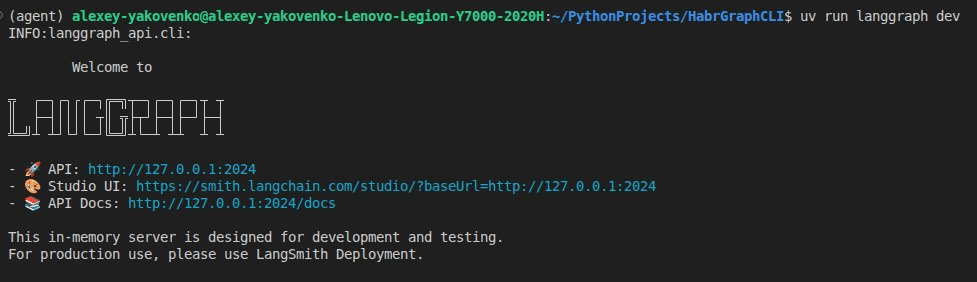
Устанавливаем зависимости и поднимаем CLI в dev-режиме:
      uv sync
uv run langgraph dev
Структура проекта
Открываем langgraph.json — там конфиг вида:
      json{
  "$schema": "https://langgra.ph/schema.json",
  "dependencies": ["."],
  "graphs": {
    "agent": "./src/agent/graph.py:graph",
    ...
  },
  "env": ".env",
  "image_distro": "wolfi",
  "dockerfile_lines": [
    "RUN apk add --no-cache curl && curl -Ls https://astral.sh/uv/install.sh | UV_INSTALL_DIR=/usr/local/bin sh"
  ]
}
На момент выхода статьи в проекте три графовых агента, но сейчас сосредоточимся на первом — agent. Именно его будем подключать к фронтенду.
Что умеет agent
По архитектуре это классический ReAct-граф: узел call_model отправляет историю диалога в локальную LLM через OpenAI-совместимый протокол, узел tools исполняет вызванные моделью инструменты.
Между ними условное ребро tools_condition — если модель запросила инструмент, идем в tools и возвращаемся обратно; если ответила текстом — завершаем. Состояние — история сообщений с редьюсером add_messages, системный промпт прокидывается через Context и легко переопределяется с фронта. Детальную сборку разбирал в прошлой части, повторяться не буду.
Инструментарий живет отдельно от графа: список TOOLS в tools.py плюс тулзы от MCP-серверов — fetch для чтения произвольных веб-страниц и time для работы с временем. На старте граф складывает все это в ALL_TOOLS и биндит к модели. Добавить новый инструмент можно, не трогая схему графа.
За последнее время агент вырос на три новых инструмента:
- calculate — калькулятор на базе AST-парсера вместо опасного eval. Разбирает выражение и вычисляет только разрешенные арифметические операции — никакого произвольного Python внутрь не просочится. Лечит классическую болячку LLM, которые уверенно ошибаются в простой арифметике.
- convert_currency — конвертация фиатных валют по актуальному курсу через бесплатный API Европейского центрального банка (frankfurter).
- get_hacker_news_top — топовые новости с Hacker News. Карточки новостей тянутся параллельно через asyncio.gather, чтобы не ждать их по очереди.
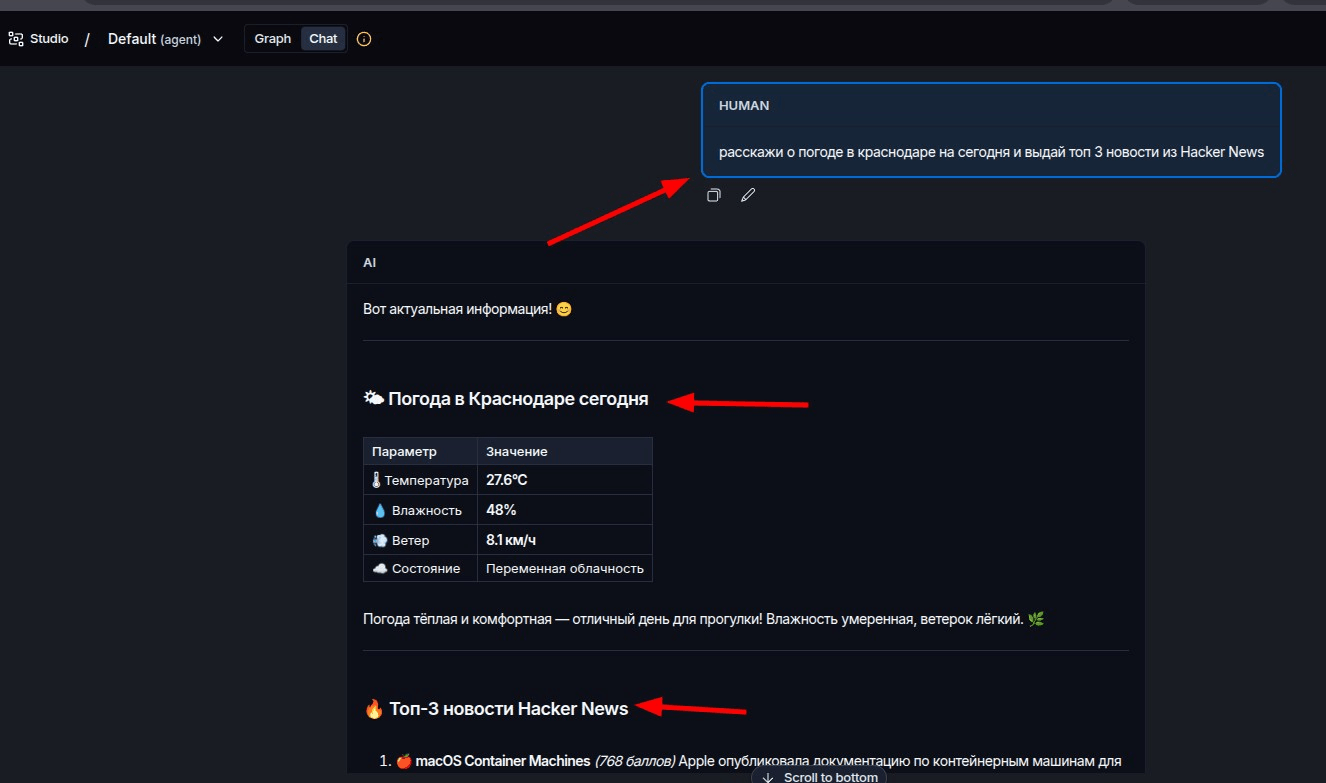
Итоговый набор получился небольшим, но самодостаточным: погода, курсы крипты и фиата, Википедия, координаты МКС, калькулятор, свежие новости и чтение любых веб-страниц. Все инструменты работают на публичных API без ключей — граф заводится из коробки и уже готов к подключению фронтенда. Чем мы и займемся.
Поднимаем Agent Chat UI
Переходим к главному герою статьи. Сейчас мы поднимем полноценный AI-интерфейс буквально за несколько минут — без написания фронтенд-кода, без настройки WebSocket-соединений, без возни с UI-библиотеками. Просто клонируем, настраиваем три переменных окружения и запускаем.
Клонируем и настраиваем
git clone https://github.com/langchain-ai/agent-chat-ui
Открываем проект в редакторе. В корне создаем .env:
      NEXT_PUBLIC_API_URL=http://127.0.0.1:2024
NEXT_PUBLIC_ASSISTANT_ID=agent
LANGSMITH_API_KEY=lsv2_pt_...
NEXT_PUBLIC_AUTH_SCHEME=
Здесь:
NEXT_PUBLIC_API_URL— адрес LangGraph Server, который мы подняли на предыдущем шаге;NEXT_PUBLIC_ASSISTANT_ID— имя графа. Смотрим в langgraph.json и берем оттуда — в нашем случае agent;NEXT_PUBLIC_AUTH_SCHEME— оставляем пустым, вернемся к этой переменной в разделе про авторизацию.
Устанавливаем зависимости и запускаем:
npm install
Запустим в dev режиме:
npm run dev
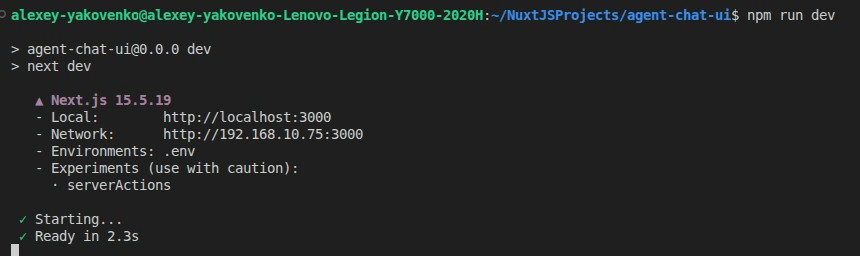
Переходим на http://localhost:3000.
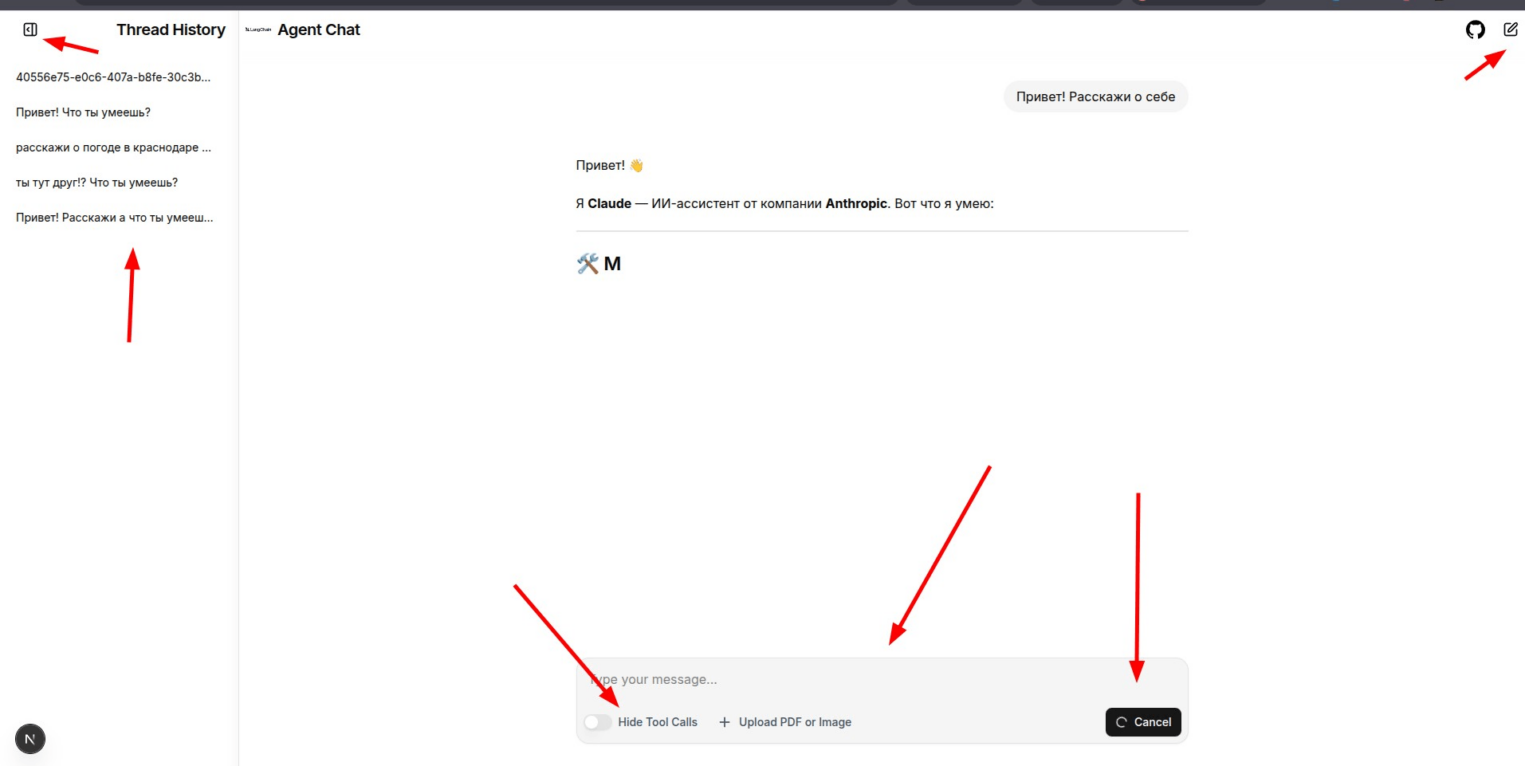
Что получили из коробки
И вот здесь стоит сделать паузу и оценить момент. Мы не написали ни строчки фронтенд-кода. Не описывали API-контракт, не поднимали WebSocket, не придумывали как отображать стриминг. Просто указали адрес нашего LangGraph Server — и получили готовый продукт, который выглядит и работает как ChatGPT. Это именно тот случай когда «из коробки» — не маркетинговое преувеличение.
Разберем что конкретно доступно прямо сейчас:
- Стриминг токенов — работает сразу и работает правильно. Ответ появляется по мере генерации, пользователь не смотрит в пустой экран по 30 секунд ожидая результата. Для продакшн-интерфейса это не фича — это базовое требование, и здесь оно закрыто без нашего участия.
- Размышления агента и вызовы инструментов — все видно в реальном времени. Как агент думает, какие инструменты вызывает, что получает в ответ. Если вам это не нужно — переключатель «Hide Tool Calls» скрывает технические детали и оставляет только финальный ответ.
- Остановка генерации — кнопка «Cancel» прерывает ответ в любой момент. Мелочь, но без нее интерфейс ощущается незаконченным.
- История тредов — в левой панели видны все предыдущие диалоги. Можно вернуться в любой из них и продолжить — контекст сохранен. Именно для этого мы и говорили про поддержку истории на бэкенде.
- Загрузка файлов — кнопка «Upload PDF or Image» уже на месте. Работает если модель поддерживает мультимодальный ввод — Qwen3 умеет, так что это сразу в деле.
- Отладочная панель — иконка в левом нижнем углу. Удобна в процессе разработки: показывает состояние графа, сообщения в треде и прочую техническую информацию прямо в браузере, не переключаясь в LangSmith.
Это довольно богатый набор для нулевых усилий с нашей стороны.
Такой подход особенно оправдан когда нужно быстро показать рабочий прототип заказчику или команде, развернуть внутренний инструмент в компании без выделенного фронтенд-разработчика, или просто проверить гипотезу не тратя недели на разработку UI.
Но «из коробки» — это стартовая точка, а не финал. Интерфейс на английском, один агент захардкожен в конфиге, некоторых нужных фич нет вовсе. Давайте это исправим.
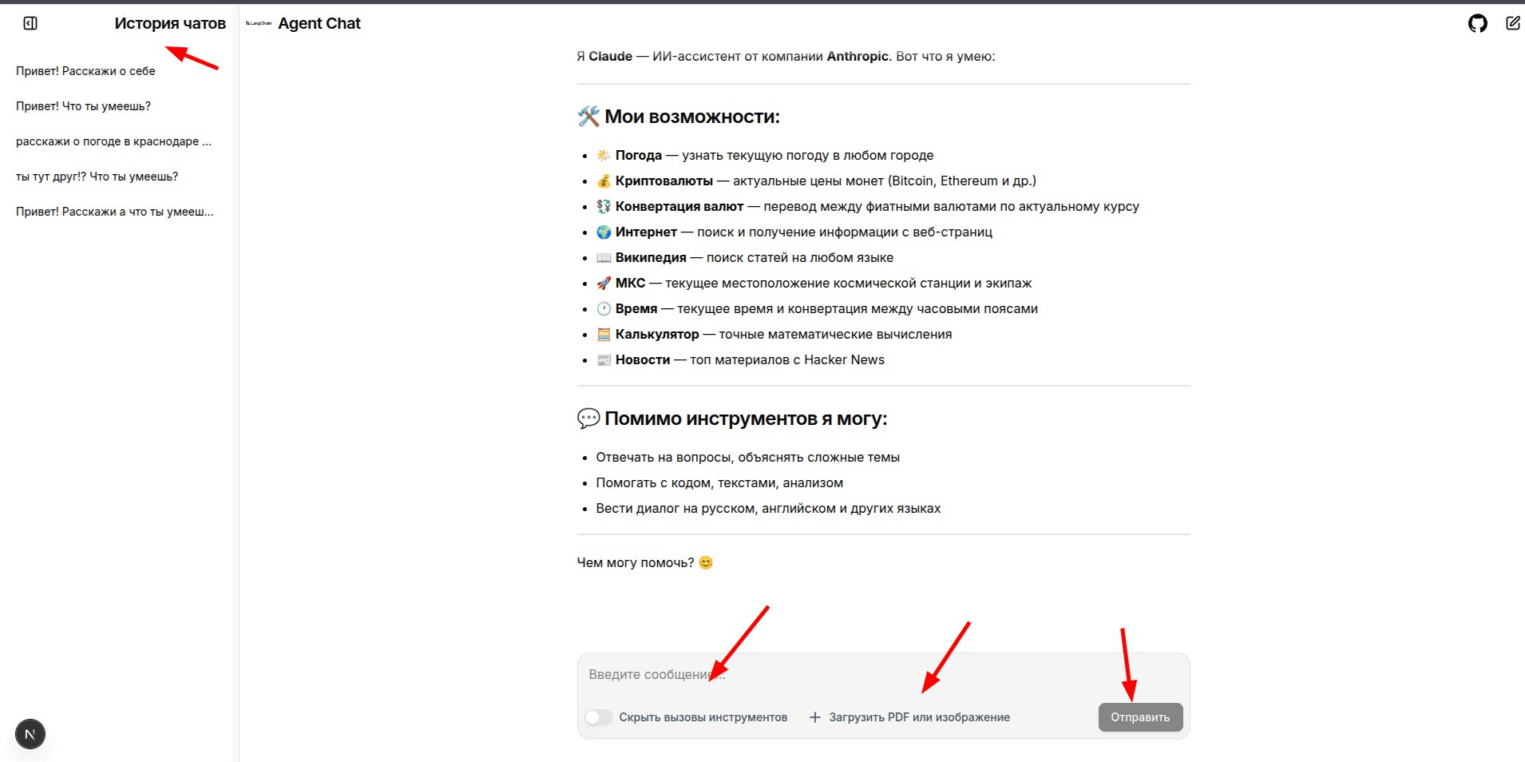
Переводим проект на русский язык
Первое, что бросается в глаза при демонстрации проекта русскоязычной аудитории — интерфейс полностью на английском.
Хорошая новость: проект не использует библиотеки локализации вроде i18n. Все надписи зашиты прямо в JSX-разметку компонентов — значит, никакой магии с конфигами, просто находим строки и меняем.
Где искать
Весь пользовательский текст сосредоточен в src/components и нескольких файлах рядом:
- src/providers/Stream.tsx — стартовая форма подключения: «Deployment URL», «Assistant / Graph ID», кнопка «Continue»;
- src/components/thread/index.tsx — основной экран чата: плейсхолдер поля ввода, кнопки «Send» / «Cancel», переключатели;
- src/components/thread/messages/* — подписи у сообщений и тултипы действий (копировать, редактировать, отправить снова);
- src/components/thread/agent-inbox/* — блок Human-in-the-loop: кнопки «Approve», «Reject», уведомления о прерывании;
- src/hooks/use-file-upload.tsx и src/lib/multimodal-utils.ts — тексты ошибок при загрузке файлов;
- src/app/layout.tsx — заголовок и описание страницы в метаданных.
Быстро собрать список всех строк для перевода поможет простой grep по проекту:
grep -rnE 'placeholder=|aria-label=|toast\.(error|success)' src --include="*.tsx"
Что переводить, а что не трогать
Переводим только то, что реально видит пользователь: текст между тегами, значения атрибутов placeholder, aria-label, title, tooltip, сообщения toast-уведомлений.
Не трогаем:
- бренды и имена собственные — Agent Chat, LangGraph, LangSmith;
- строки внутри
console.error(...)иthrow new Error(...)— это технические логи для разработчика; - строковые литералы по которым в коде идет сравнение
(type === "approve"), ключи localStorage, имена переменных окружения, MIME-типы.
И еще один момент который сэкономит время: заранее заведите небольшой словарь повторяющихся терминов и держитесь его во всех файлах.
Например: thread → «чат», tool calls → «вызовы инструментов», Submit → «Отправить», Reject → «Отклонить». Иначе один и тот же элемент в разных местах окажется назван по-разному — выглядит небрежно.
Проверяем результат
После правок проверяем что не разъехалась типизация:
npx tsc --noEmit
Если ошибок нет, а npm run dev показывает русский интерфейс — готово. Если переводить вручную не хочется — я уже сделал это за вас.
Просто клонируйте себе мой репозиторий с GitHub:
git clone https://github.com/Yakvenalex/Agent-chat-ui-habr
Клонируете, устанавливаете зависимости, запускаете — все уже на русском и с остальными фишками, которые я опишу далее.
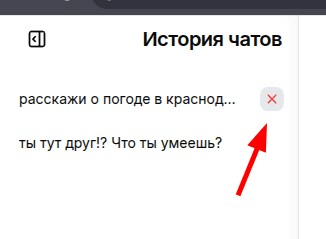
Удаление чатов
По умолчанию история в боковой панели только накапливается — удалить ненужный диалог через интерфейс невозможно. При этом в REST API LangGraph нужный эндпоинт уже есть. Добавим кнопку удаления, чтобы пользователь мог навести порядок прямо из UI.
Логика удаления
Список тредов живет в ThreadProvider (src/providers/Thread.tsx). Там уже есть метод getThreads, который загружает диалоги через SDK-клиент. По той же схеме добавляем метод удаления — @langchain/langgraph-sdk умеет client.threads.delete() из коробки:
      const deleteThread = useCallback(
  async (threadId: string): Promise => {
    if (!apiUrl) return;
    const client = createClient(
      apiUrl,
      getApiKey() ?? undefined,
      authScheme || undefined,
    );

    await client.threads.delete(threadId);
    setThreads((prev) => prev.filter((t) => t.thread_id !== threadId));
  },
  [apiUrl, authScheme],
);
Обратите внимание на оптимистичное обновление: после успешного запроса мы не перезагружаем весь список с сервера, а просто вычеркиваем удаленный тред из локального состояния. Интерфейс реагирует мгновенно, без лишнего запроса. Не забудьте добавить deleteThread в тип контекста и в объект value, который провайдер отдает наружу.
Кнопка в списке
Теперь выводим крестик у каждого элемента в src/components/thread/history/index.tsx. Чтобы не загромождать интерфейс, показываем кнопку только при наведении на тред — связка классов group на контейнере и opacity-0 group-hover:opacity-100 на кнопке:
<div>
<Button />
<p>{itemText}</p>
</Button>
<button type="button" aria-label="Удалить чат"> handleDelete(e, t.thread_id)}
disabled={deletingId === t.thread_id}
className="absolute top-1/2 right-2 -translate-y-1/2 rounded-md p-1 text-gray-400 opacity-0 transition-colors hover:bg-gray-200 hover:text-red-500 group-hover:opacity-100"
>
{deletingId === t.thread_id ? (
) : (
)}
</button>
</div>
Обработчик handleDelete решает три задачи: не дает клику провалиться на кнопку открытия чата (stopPropagation), показывает спиннер вместо крестика, пока идет запрос (состояние deletingId), и сбрасывает активный диалог если удалили именно его:
      const handleDelete = async (e, id) => {
  e.preventDefault();
  e.stopPropagation();
  if (deletingId) return;

  setDeletingId(id);
  try {
    await deleteThread(id);
    if (id === threadId) setThreadId(null);
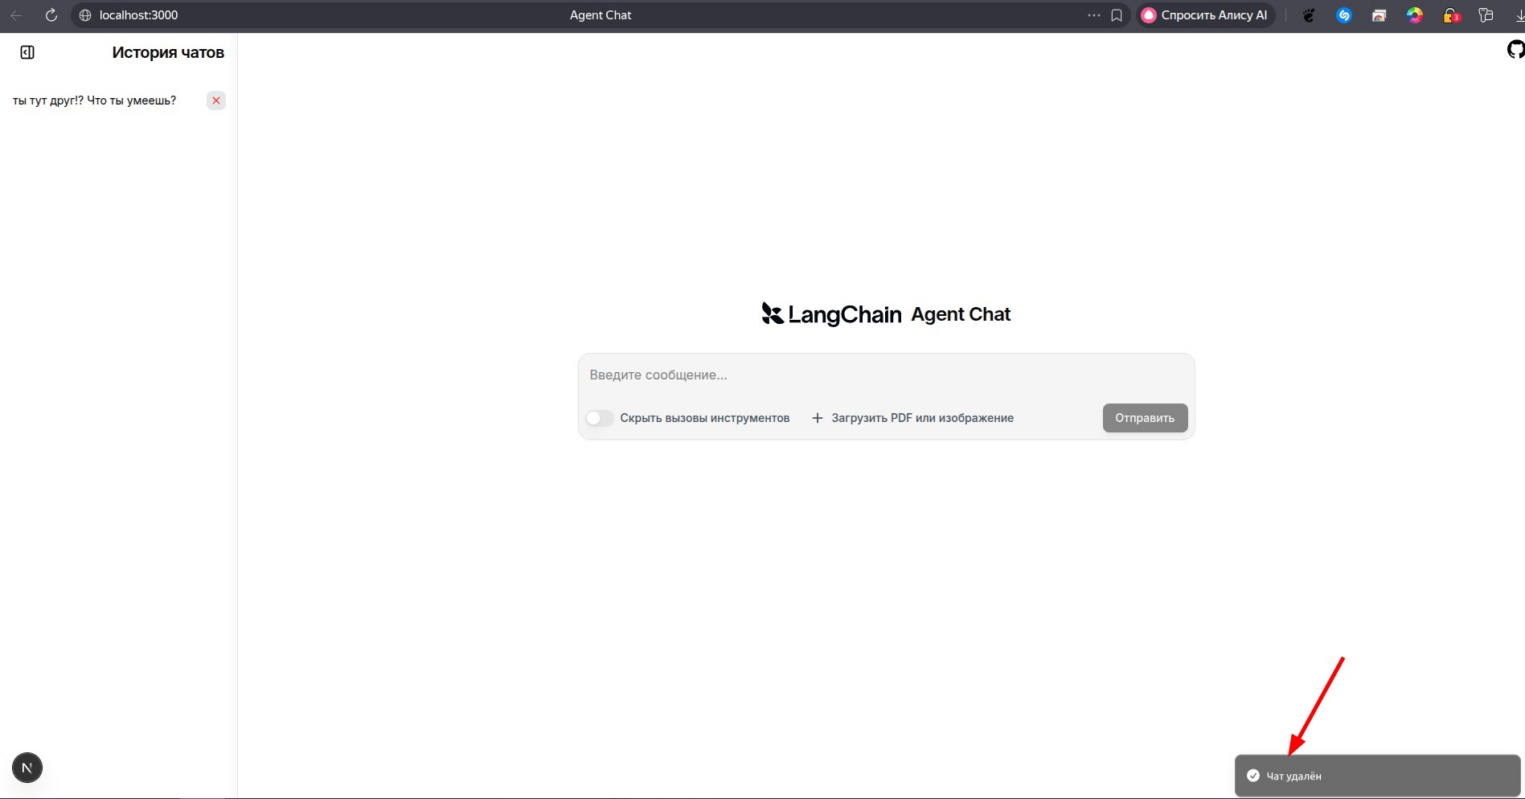
    toast.success("Чат удален");
  } catch (error) {
    console.error(error);
    toast.error("Не удалось удалить чат");
  } finally {
    setDeletingId(null);
  }
};
Тосты дают пользователю понятную обратную связь — успех или ошибка. В итоге получаем полноценное удаление: крестик появляется при наведении, тред мгновенно исчезает из списка, активный диалог при необходимости сбрасывается корректно.
Добавляем в конец раздела после основного кода.
Важный нюанс с активным чатом. Если удаляется тред, который сейчас открыт, порядок операций имеет значение. Сначала нужно уйти с него — await setThreadId(null) — и только потом отправлять запрос на удаление:
      if (id === threadId) await setThreadId(null);
await deleteThread(id);
setThreadId из nuqs возвращает промис обновления URL, поэтому await здесь не формальность — он гарантирует что useStream успеет переключиться на null и перестанет обращаться к состоянию треда до того как тот физически исчезнет на сервере. Без этого получите HTTP 404 в самый неподходящий момент.
Знакомимся с остальными агентами
Помните, в начале статьи мы говорили что в langgraph.json у нас висит три агента, а к фронту подключили пока только одного? Пришло время исправить это — но сначала познакомимся с теми двумя, которые еще не в деле.
      "graphs": {
    "agent": "./src/agent/graph.py:graph",
    "router_agent": "./src/agent/router_graph.py:graph",
    "chef_agent": "./src/agent/chef_graph.py:graph"
  }
router_agent — диспетчер с несколькими специализациями
Если первый agent — это универсал с одним мешком инструментов, то router_agent устроен принципиально иначе. Это уже не один узел, а небольшая мультиагентная схема с маршрутизацией. В начале графа стоит узел-роутер: отдельная LLM с одной-единственной задачей — посмотреть на запрос пользователя и одним словом решить, куда его отправить.
Дальше срабатывает условное ребро, и запрос уходит в одну из трех веток:
- chat — обычная беседа без инструментов: шутка, мнение, объяснение. Самый быстрый путь, внешние данные не дергаются;
- web_agent — веб-исследователь: читает произвольные страницы, ищет в Википедии, знает где сейчас МКС и что в топе Hacker News;
- data_agent — специалист по актуальным данным и расчетам: погода, курсы криптовалют, конвертация валют, точная арифметика, текущее время и работа с часовыми поясами.
Главная фишка — у каждой ветки свой системный промпт и свой набор инструментов, а web_agent и data_agent внутри работают как полноценные ReAct-циклы. То есть роутер не просто «угадывает категорию», а передает управление профильному под-агенту, заточенному именно под этот класс задач.
Отдельно стоит отметить решение по самому роутеру: он не использует function calling и structured output, а возвращает один токен текстом который мы парсим вручную. Так маршрутизация не зависит от капризов модели с вызовом функций и остается предсказуемой.
chef_agent — узкопрофильный эксперт
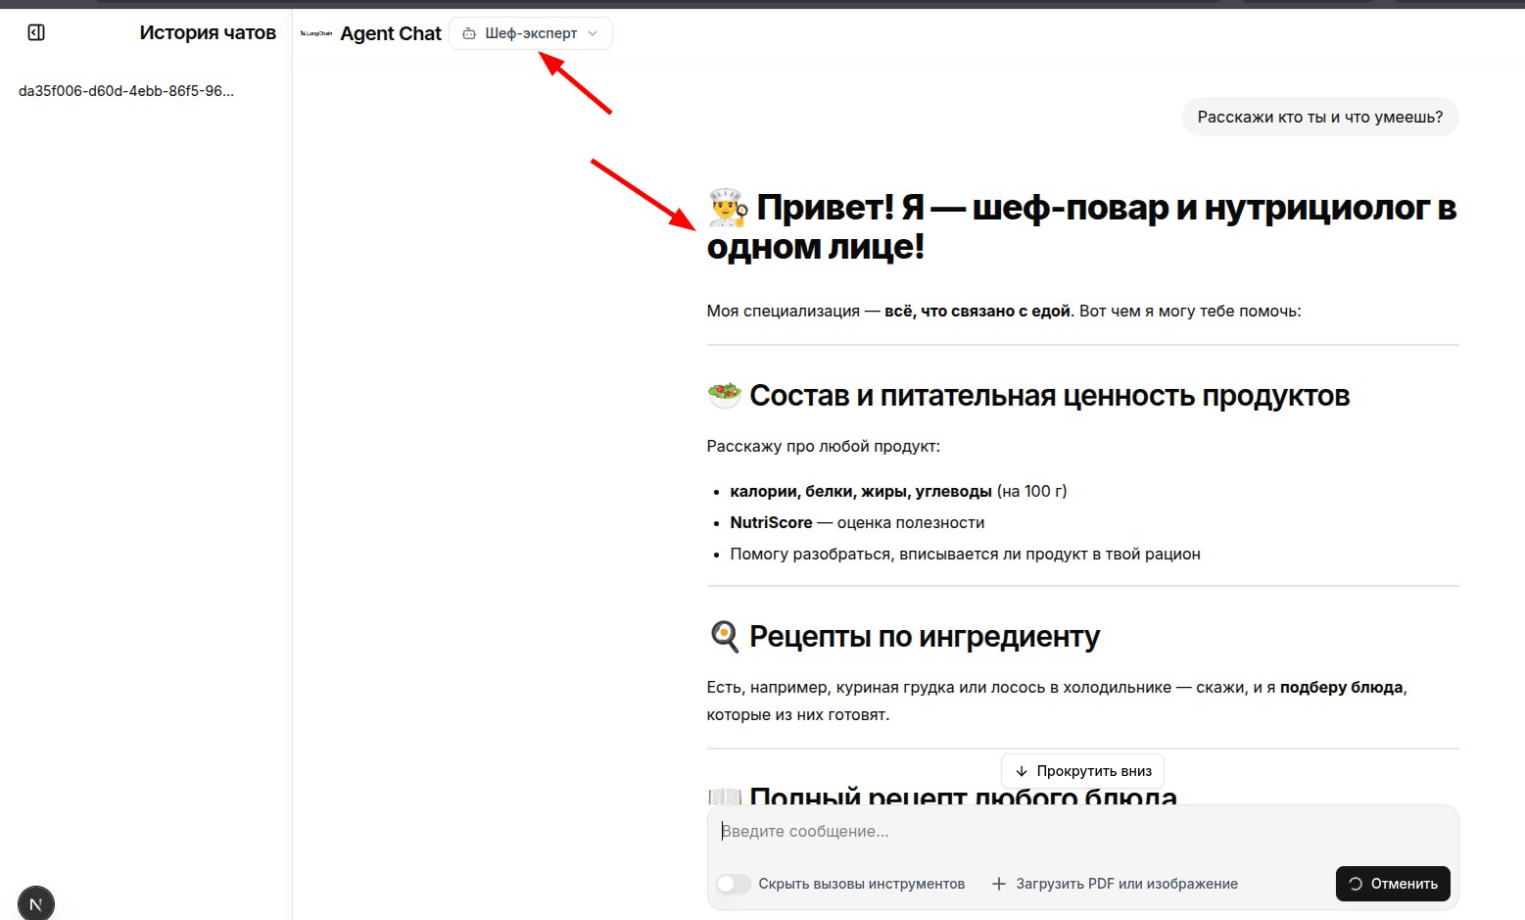
Третий агент — другая крайность спектра. Если router_agent показывает, как расширяться вширь (много тем, маршрутизация между ними), то chef_agent — это движение вглубь. Намеренно узкий специалист: шеф-повар и нутрициолог, который не делает ничего кроме еды. Архитектурно простой (тот же ReAct-цикл), но вся его «экспертность» собрана из двух вещей: фокусного набора инструментов и сильного доменного промпта, который задает роль, тон и границы.
Инструментарий (все API публичные, без ключей):
product_nutrition— состав и пищевая ценность на 100 г: калории, БЖУ, сахара, соль, NutriScore через Open Food Facts;find_recipes_by_ingredient— какие блюда можно приготовить из заданного ингредиента через TheMealDB;get_recipe— полный рецепт по названию: ингредиенты с граммовками, шаги и фото;random_meal— случайное блюдо с рецептом, на случай «не знаю что приготовить».
Несколько характерных деталей. Эксперт держит границы темы: на вопрос не про еду мягко отвечает, что это вне его специализации — прямое следствие доменного промпта. Кулинарные API понимают в основном английский, поэтому агент переводит запрос перед вызовом инструмента, а ответ возвращает на русском. Тулзы устойчивы к реальным сбоям: Open Food Facts любит отвечать 503 под нагрузкой, поэтому запросы идут с ретраями и backoff, а агент проинструктирован честно помечать когда дополняет ответ из собственных знаний.
Вместе три агента дают наглядный срез архитектурных подходов: генералист (agent) → диспетчер-мультиагент (router_agent) → узкий эксперт (chef_agent).
Теперь, когда познакомились, подключим всех троих к фронту и дадим пользователю возможность переключаться между ними прямо в интерфейсе.
Выбор агента: подключаем несколько графов
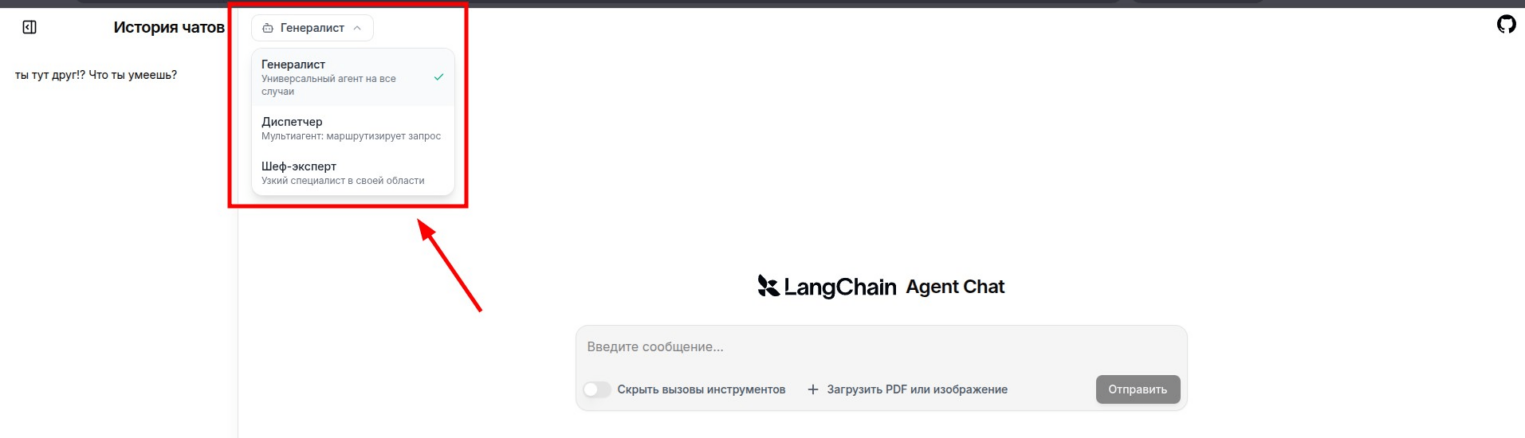
Бэкенд у нас уже отдает три графа, фронтенд пока знает только об одном. Исправим это — добавим переключатель агентов прямо в шапку интерфейса.
Шаг 1. Список агентов в переменной окружения
Начнем с конфигурации. Чтобы не хардкодить состав агентов в коде, опишем его одной строкой в .env — имена графов через запятую:
      # Имена графов, между которыми можно переключаться в UI.
# Первый в списке — агент по умолчанию.
NEXT_PUBLIC_ASSISTANT_IDS=agent,router_agent,chef_agent
Префикс NEXT_PUBLIC_ обязателен: переменная нужна на клиенте, так как переключатель работает в браузере.
Префикс NEXT_PUBLIC_ обязателен: переменная нужна на клиенте, так как переключатель работает в браузере.
Шаг 2. Разбираем переменную в конфиг
Создаем модуль src/lib/agents.ts, который превращает строку из .env в готовый список агентов. ID берем из окружения, человекочитаемые подписи — из небольшого словаря. Если для какого-то ID подписи нет, она соберется из самого ID (router_agent → Router Agent):
      // src/lib/agents.ts
const AGENT_META: Record = {
  agent:        { label: "Генералист",  description: "Универсальный агент на все случаи" },
  router_agent: { label: "Диспетчер",   description: "Мультиагент: маршрутизирует запрос" },
  chef_agent:   { label: "Шеф-эксперт", description: "Узкий специалист в своей области" },
};

function parseAgentIds(): string[] {
  const ids = (process.env.NEXT_PUBLIC_ASSISTANT_IDS ?? "")
    .split(",")
    .map((value) => value.trim())
    .filter(Boolean);

  if (ids.length === 0) {
    return [process.env.NEXT_PUBLIC_ASSISTANT_ID?.trim() || "agent"];
  }
  return ids;
}

export const AGENTS = parseAgentIds().map((id) => ({
  id,
  label: AGENT_META[id]?.label ?? prettifyId(id),
  description: AGENT_META[id]?.description ?? "",
}));

export const DEFAULT_AGENT_ID = AGENTS[0].id;
Добавить или убрать агента теперь можно прямо в .env, не трогая код. Разделение чистое: что подключать — в переменной окружения, как подписать — в словаре.
Шаг 3. Одна точка опоры — assistantId
Прежде чем рисовать UI, важно понять как агент вообще «выбирается» в проекте. Все держится на единственном параметре — assistantId. Он хранится в URL через nuqs и пробрасывается сразу в два места:
- в хук useStream — кто обрабатывает сообщения;
- в поиск истории — треды какого графа показывать в боковой панели.
Значит, чтобы переключить агента, достаточно поменять это одно значение — остальное подтянется автоматически. Именно поэтому правок в итоге минимум.
Шаг 4. Компонент-переключатель
Сам AgentSwitcher — легкий выпадающий список на обычном useState, без новых UI-библиотек. Вся суть в обработчике выбора:
      const handleSelect = async (id: string) => {
  setOpen(false);
  if (id === currentId) return;
  // Чаты привязаны к агенту: сначала уходим с текущего треда, потом меняем агента
  await setThreadId(null);
  setAssistantId(id);
};
Порядок здесь принципиален. Сначала await setThreadId(null) — сбрасываем открытый чат, потому что он принадлежал прежнему агенту и у нового графа его попросту нет. И только потом setAssistantId(id) записывает нового агента в URL, после чего стрим пересоздается под выбранный граф.
Готовый <AgentSwitcher /> встраиваем в шапку — и до начала диалога, и во время него, рядом с логотипом.
Шаг 5. Обновляем историю под выбранного агента
Последняя деталь: список тредов в боковой панели загружался только один раз при монтировании. Чтобы при переключении агента показывались именно его чаты, добавляем assistantId в зависимости эффекта:
      const [assistantId] = useQueryState("assistantId");

useEffect(() => {
  setThreadsLoading(true);
  getThreads().then(setThreads).catch(console.error)
    .finally(() => setThreadsLoading(false));
}, [assistantId]); // ← перезагрузка при смене агента
Шаг 6. Убираем форму первичной настройки
Есть неочевидный момент. Если задать только NEXT_PUBLIC_ASSISTANT_IDS и забыть про старую NEXT_PUBLIC_ASSISTANT_ID, приложение решит что агент не выбран и покажет форму первичной настройки.
Чтобы этого не происходило, даем assistantId откат на первого агента из списка — в провайдере стрима и в поиске тредов:
const finalAssistantId = assistantId || envAssistantId || DEFAULT_AGENT_ID;
Теперь выбор агента в шапке мгновенно меняет и собеседника, и историю переписки под него. А поскольку все завязано на один параметр assistantId, расширение списка — это одна строчка в .env: добавили четвертого агента в NEXT_PUBLIC_ASSISTANT_IDS, перезапустили сервер — и он уже доступен в переключателе.
Добавляем авторизацию на бэкенде
К этому моменту три агента крутятся на локальном сервере и до них может достучаться кто угодно, кто знает адрес. Перед тем как прикручивать авторизацию на фронтенд — закроем бэкенд простой Bearer-авторизацией: каждый запрос к API должен принести токен в заголовке Authorization, иначе отказ. LangGraph дает для этого официальный механизм — декоратор @auth.authenticate.
Реализация уместится в три шага
Шаг 1. В .env кладем токен, в .env.example — плейсхолдер чтобы настоящий не утек:
AUTH_SECRET_TOKEN=ваш_секретный_токен
Шаг 2. Создаем src/auth.py
      import os

from dotenv import load_dotenv
from langgraph_sdk import Auth
from starlette.exceptions import HTTPException

load_dotenv()

auth = Auth()
SECRET_TOKEN = os.getenv("AUTH_SECRET_TOKEN", "")


@auth.authenticate
async def authenticate(authorization: str | None) -> str:
    if not authorization or not authorization.startswith("Bearer "):
        raise HTTPException(
            status_code=401,
            detail="Missing or malformed Authorization header",
            headers={"WWW-Authenticate": "Bearer"},
        )

    token = authorization.removeprefix("Bearer ").strip()
    if not SECRET_TOKEN or token != SECRET_TOKEN:
        raise HTTPException(status_code=403, detail="Invalid token")

    return "user"
Шаг 3. Регистрируем в langgraph.json
      {
  "auth": {
    "path": "./src/auth.py:auth",
    "disable_studio_auth": false
  }
}
Готово. Запрос без токена ловит 401, с верным токеном — отрабатывает штатно. Но за этой простотой прячется несколько мест где легко запутаться — и именно о них стоит рассказать, потому что в документации они либо размазаны, либо описаны неточно.
Нюанс 1. 401 против 403: почему официальный пример «не работает»
В документации LangGraph для отказа предлагают бросать Auth.exceptions.HTTPException(status_code=401, ...). Делаешь по доке — клиент получает 403 вместо 401.
Причина внутри самого LangGraph: auth-слой ловит Auth.exceptions.HTTPException и превращает любой отказ в AuthenticationError, теряя при этом статус-код и заголовки, после чего отдает жестко зашитый 403. То есть и 401, и 403 поднятые через Auth.exceptions на проводе становятся 403 — и в dev, и в проде.
Лечится это тем, что видно в коде выше: бросаем starlette.exceptions.HTTPException. Auth-слой пропускает starlette-исключение как есть, не схлопывая — поэтому до клиента доходит честный 401 с заголовком WWW-Authenticate: Bearer. Это не хак: пробрасывание starlette HTTPException заложено в код намеренно.
Семантику тоже стоит соблюдать: 401 — не аутентифицирован (нет или битый токен), 403 — аутентифицирован, но доступ запрещен (токен есть, но неверный). В нашем хендлере именно так.
Нюанс 2. disable_studio_auth — флаг с обратной интуицией
Самое коварное место. По названию кажется, что disable_studio_auth: true отключает авторизацию для Studio и тот начинает работать свободно.
На деле все наоборот:
| Значение | Что происходит со Studio |
|---|---|
| false | Studio работает — для него включен доверенный проход в обход вашей проверки |
| true | Studio-байпас выключен → запросы Studio идут через ваш Bearer → без токена ловит 401 |
Запомнить проще так: флаг отключает не «авторизацию Studio», а встроенный механизм который пускает Studio мимо вашего хендлера. Хотите визуально дебажить граф — оставляйте false. Хотите закрыть вообще все включая Studio — ставьте true.
Нюанс 3. Два разных «LangSmith» — не путать
Когда возникает вопрос «А трейсинг не сломается?» — важно понимать что это две независимые вещи.
LangSmith-трейсинг — сервер сам отправляет трейсы в api.smith.langchain.com по LANGSMITH_API_KEY. Это исходящие вызовы, наша авторизация защищает входящие — трейсинг работает всегда и от нее не зависит.
LangSmith Studio — подключается к вашему серверу как входящий клиент, и его поведение определяет disable_studio_auth из нюанса выше.
Нюанс 4. Dev-пропуск Studio — это «пустой» пропуск
Важная оговорка по безопасности о которой легко забыть. В локальном langgraph dev при disable_studio_auth: false Studio использует StudioNoopAuthBackend — он доверяет любому запросу с заголовком x-auth-scheme: langsmith. То есть локально авторизацию можно обойти так:
curl -H "x-auth-scheme: langsmith" ... # пройдет без токена
Поэтому на localhost авторизация — это прежде всего способ разработать и протестировать интеграцию и обеспечить паритет с продом, а не реальная защита.
На проде при false тот же путь обслуживает уже LangsmithAuthBackend, который проверяет, что за Studio стоит валидный LangSmith-пользователь с доступом к деплою. Заголовком это не подделать.
Нюанс 5. Проверять нужно на правильном эндпоинте
Тестируя авторизацию легко обмануться: служебный health-check /ok намеренно не требует токена и всегда отдает 200.
Проверять нужно на реальной ручке:
      # без токена → 401
curl -i -X POST http://localhost:2024/assistants/search \
  -H "Content-Type: application/json" -d '{}'

# с токеном → 200
curl -s -X POST http://localhost:2024/assistants/search \
  -H "Authorization: Bearer ваш_секретный_токен" \
  -H "Content-Type: application/json" -d '{}'
И еще одна частая ловушка: секции auth и disable_studio_auth читаются только при старте сервера. Код графов dev-сервер перезагружает на лету, а изменения в langgraph.json — нет. Поменяли конфиг авторизации — перезапустите langgraph dev, иначе будете смотреть на старое поведение и недоумевать.
Для разработки оставляем disable_studio_auth: false — API под токеном, Studio доступен для отладки. На проде токен защищает REST-поверхность которую дергает фронт, а доступ к Studio валидируется через LangSmith. Дальше прикручиваем фронтенд — и он будет ходить к бэкенду уже с этим токеном.
Авторизация на фронте
До этого момента фронтенд общался с LangGraph Server открыто. Как только на сервере включается защита — каждый запрос упирается в 401 Unauthorized. Разберем, что нужно сделать на фронте, и честно поговорим о границах того, что получится.
Что происходит на бэкенде
LangGraph перехватывает каждый входящий запрос через @auth.authenticate. Логика простая: сервер сверяет заголовок Authorization с секретом из AUTH_SECRET_TOKEN. Нет заголовка — 401, токен неверный — 403, токен совпал — пропускаем.
Важный момент: авторизация навешивается на сервер целиком, а не на отдельный граф. Все три агента сразу под защитой — фронтенд обязан слать токен в каждом запросе, будь то стрим сообщений или загрузка истории.
Что делаем на фронте
Задача сводится к одному: добавить заголовок Authorization: Bearer <token> в каждое обращение к серверу.
Токен кладем в .env:
NEXT_PUBLIC_AUTH_TOKEN=ваш_секретный_токен # тот же что AUTH_SECRET_TOKEN на бэке
Заводим маленький хелпер чтобы не разбрасывать process.env по коду:
      // src/lib/api-key.tsx
export function getAuthToken(): string | undefined {
  return process.env.NEXT_PUBLIC_AUTH_TOKEN || undefined;
}
Теперь главное: фронтенд обращается к серверу не из одного места, а из трех, и каждое поднимает своего клиента.
Значит заголовок нужно добавить во всех трех точках:
- стрим сообщений — хук useTypedStream в Stream.tsx;
- история чатов — createClient которым пользуются getThreads и deleteThread;
- проверка доступности графа — отдельный fetch на /info.
Везде выглядит одинаково — заголовок подставляется только если токен задан, чтобы локальная разработка без защиты продолжала работать:
      const authToken = getAuthToken();

defaultHeaders: {
  ...(authToken && { Authorization: `Bearer ${authToken}` }),
}
Отдельно отмечу, что мы не трогали. В проекте уже есть getApiKey() — но это ключ для LangGraph Cloud, который SDK отправляет в заголовке x-api-key. Другой механизм, к нашему секрету отношения не имеет — оставляем как есть.
После перезапуска npm run dev в DevTools → Network видно Authorization: Bearer … в каждом запросе. Сообщения стримятся, история подгружается, 401 исчез.
О границах этого решения
Формально задача закрыта — сервер защищен, фронтенд авторизуется. Но нужно ясно понимать что именно мы построили, и все ограничения растут из префикса NEXT_PUBLIC_.
Токен уезжает в браузер. Все что помечено NEXT_PUBLIC_ Next.js вшивает в клиентский бандл на этапе сборки. Секрет физически оказывается на странице — его видно в DevTools и исходниках. Любой посетитель может его достать и обращаться к серверу напрямую в обход интерфейса.
Токен один на всех. Это не «вход пользователя», а общий пароль от двери. Нельзя понять кто сделал запрос, нельзя отозвать доступ у конкретного человека, нельзя разграничить права. На бэке это видно буквально — identity всегда возвращается как «user».
Токен статичен. Фиксируется при сборке и живет до следующей. Нельзя сгенерировать после входа, нельзя протухнуть по таймеру, нельзя обновить — это константа, не сессия.
Иначе говоря, мы не построили систему авторизации — мы повесили на сервер один замок и раздали от него ключ всем сразу. Для локального запуска, демонстрации и учебного проекта этого достаточно. Для прода — нет.
Как авторизация должна выглядеть в реальном продакшене
Настоящая авторизация — это ответственность бэкенда, не фронта. Фронтенд лишь «носит» токен; решает кому его выдать и насколько он валиден — сервер.
В минимальном проде это три вещи:
- Сервис пользователей и токенов. Отдельный модуль с хранилищем пользователей, который проверяет логин/пароль и выдает токены — у каждого свой, со сроком жизни и возможностью отзыва. Вместо
token == SECRET_TOKENпоявляется полноценная проверка: кто это, что ему можно, не истек ли токен.
- Эндпоинт входа. POST /login принимает учетные данные и возвращает токен. После входа токен живет в рантайме — в localStorage, cookie или памяти браузера, — а не в переменной сборки. Никакого
NEXT_PUBLIC_:значение динамическое и у каждого свое.
- Секрет не доходит до браузера. Запросы к LangGraph идут не напрямую с клиента, а через серверный прокси Next.js — в репозитории для этого уже есть заготовка:
langgraph-nextjs-api-passthroughироут src/app/api/[..._path]/route.ts. Браузер ходит на свой /api, реальный токен подставляется на сервере и наружу не утекает.
При этом наша работа на фронте никуда не девается — те же три точки куда мы прокинули Authorization остаются. Меняется только источник токена: не статичный process.env, а то что вернул логин, и не напрямую а через прокси. Граница проходит четко: фронтенд отвечает за то чтобы токен оказался в заголовке, бэкенд — за то чтобы этому токену можно было верить.
Приступаем к деплою
Что ж, настало время выпустить наш проект в мир.
До этого момента все крутилось локально — и бэкенд, и фронтенд. Это удобно для разработки, но показать такое коллегам или заказчику уже не получится. Исправим это прямо сейчас.
Я решил показать полный цикл — от покупки домена до работающего сервиса по красивому адресу. Никаких «А сервер у меня уже был» — берем все с нуля и на одной площадке.
В качестве провайдера выбрал Selectel: домен и VPS покупаются в одном личном кабинете, DNS настраивается там же, без лишних телодвижений между разными сервисами.
План такой: сначала регистрируем домен, затем поднимаем бюджетный VPS — LLM у нас уже живет на отдельном сервере из первой части, так что гнаться за мощностями не нужно.
Дальше разворачиваем бэкенд, поднимаем фронтенд и через Nginx прикручиваем ко всему этому доменное имя с SSL. На выходе — полноценный сервис в интернете, где LangGraph API закрыт внутри машины и недоступен снаружи, а пользователь видит только чистый интерфейс по вашему домену. Начнем с домена.
Берем доменное имя
Регистрируемся в панели управления, если ранее не было там регистрации.
Далее переходим в раздел управления DNS. Для этого нажимаем Продукты и в поле «Внешние сетевые сервисы» нажимаем на Домены. Тут же вы найдете вкладку Доменные зоны. Сейчас нас будут интересовать Домены.
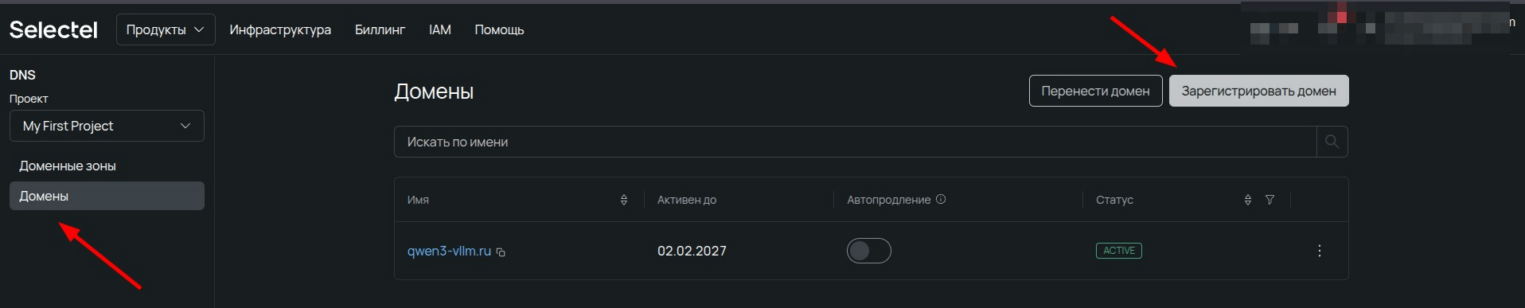
Пополняем личный кабинет и затем кликаем на Зарегистрировать домен.
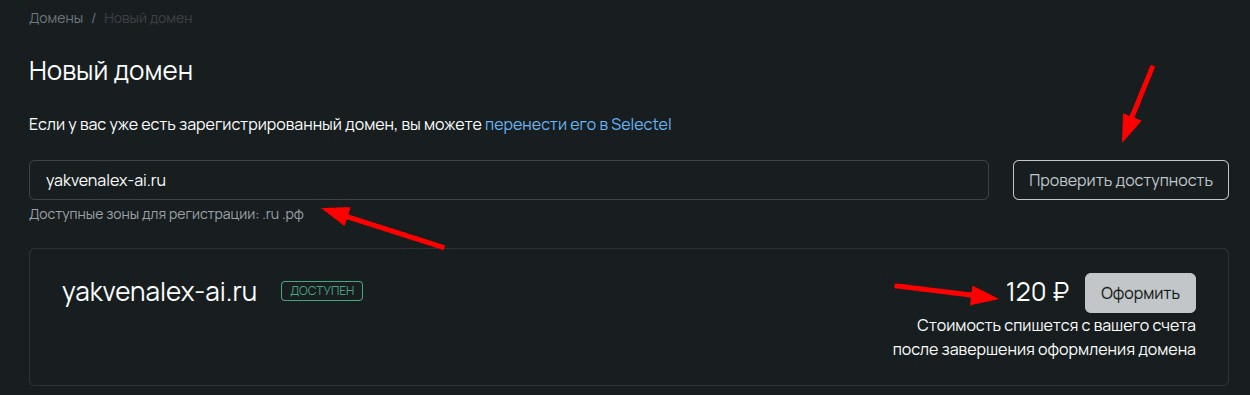
На новом экране проверяем чтоб доменное имя было свободно. Если оно свободно — кликаем на оформить.
Далее, в новом окне, даем согласие на обработку персональных данных и кликаем на оформить повторно. Если все прошло корректно, то в списке доменов вы увидите купленный вами домен:
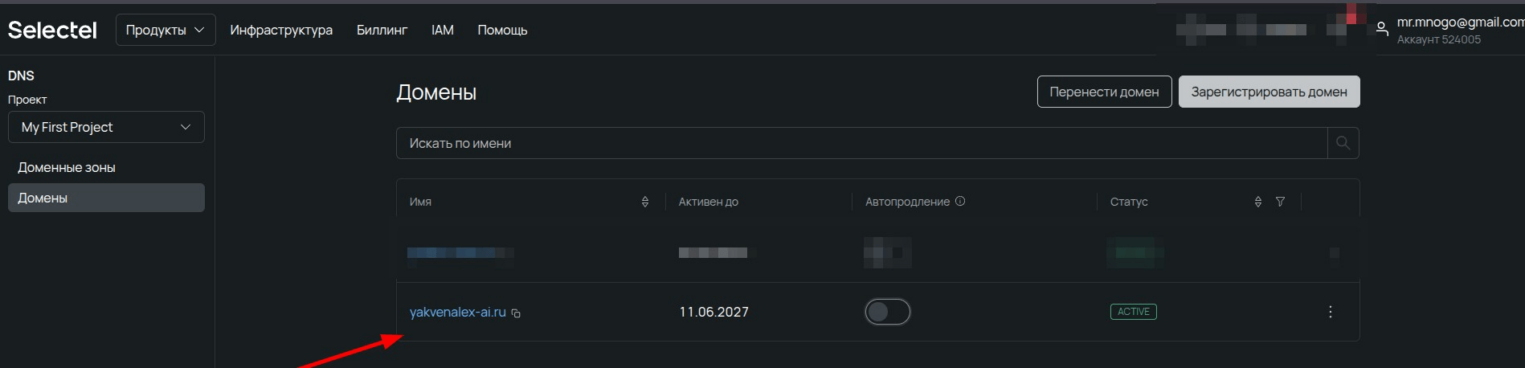
При желании можно отключить автопродление. Далее переходим в раздел «Доменные зоны» и нажимаем Добавить зону.
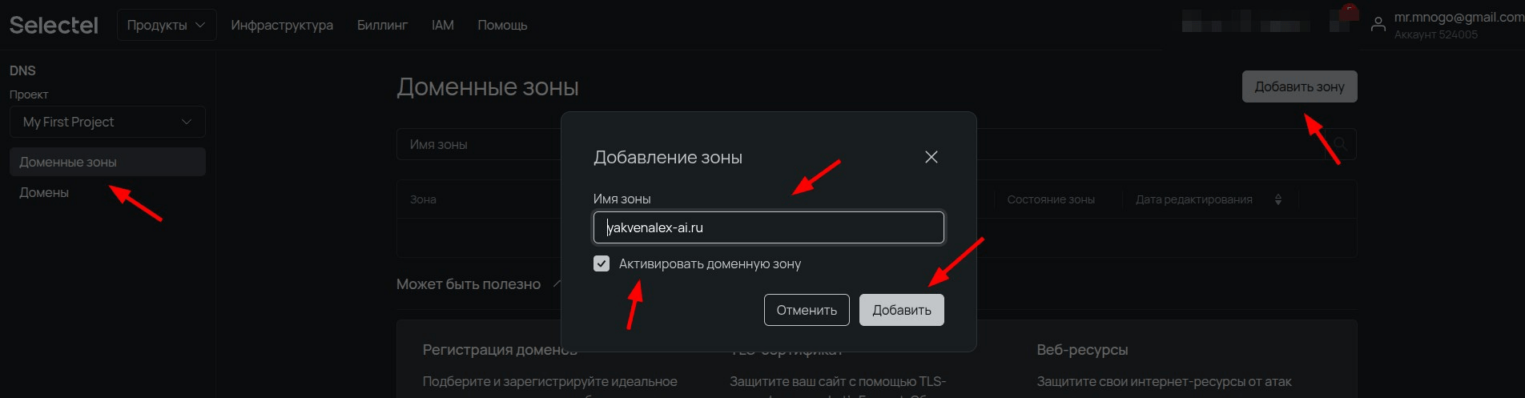
Ожидайте, пока домен получит статус «Делегирован». Изменения вносятся в реестр за один рабочий час, но для полной работы DNS-серверов может потребоваться до 24 часов.
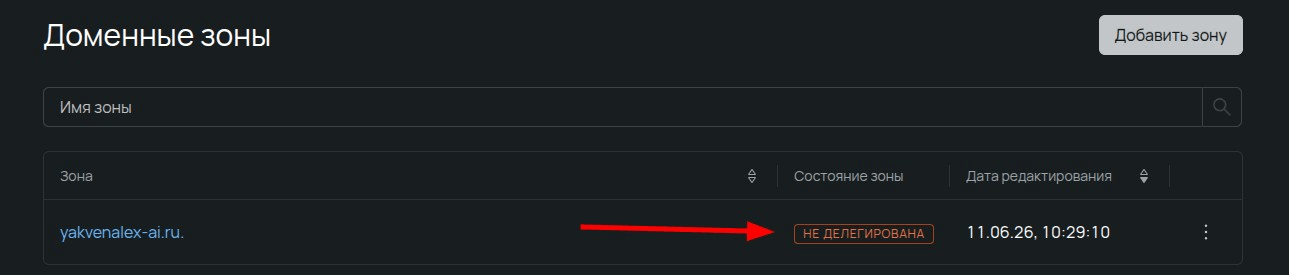
Теперь, пока ожидаем перехода доменной зоны в статус «Делегирована», займемся арендой VPS-сервера, а затем и его настройкой с последующим запуском на нем наших двух проектов.
Вам также может быть интересно
Арендуем VPS сервер
Так как облачная LLM у нас крутится на отдельной машине, сегодня мы будем брать самый базовый облачный VPS без видеопамяти и с минимальным количеством ресурсов.
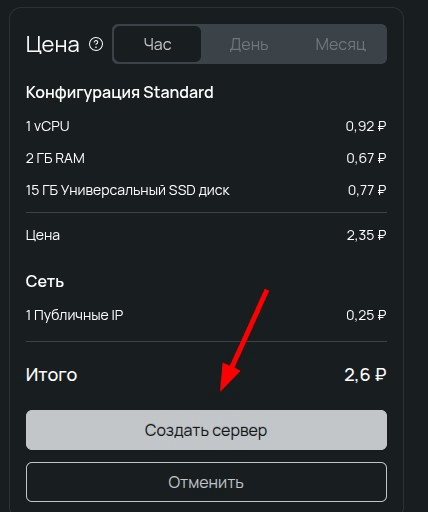
Переходим в раздел Продукты → Облачные серверы. Далее кликаем на Создать сервер и выбираем подходящий для себя VPS-сервер.
На скрине ниже демонстрирую, с какими ресурсами я выбрал сервер под сегодняшнюю задачу:
- 1 vCPU;
- 2 ГБ RAM;
- 15 ГБ Универсальный SSD диск.
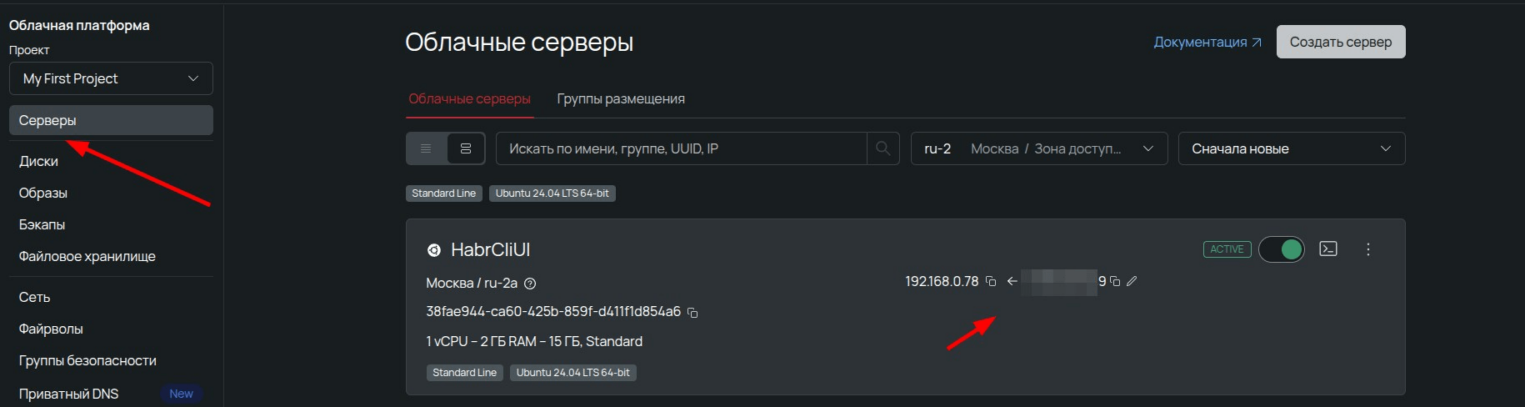
Сервер будет активен через пару минут, в чем вы сможете убедиться в разделе «Серверы».
При аренде сервера мы заполняли поле с SSH-ключем. Поэтому, если все было настроено корректно, то команды ssh root@ваш_ip будет достаточно для входа на сервер.
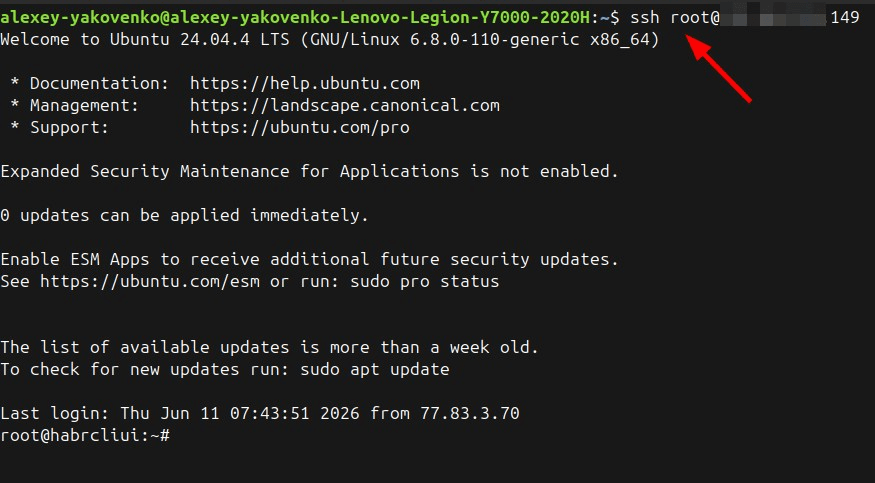
Вход без запроса пароля.
Настраиваем VPS-сервер
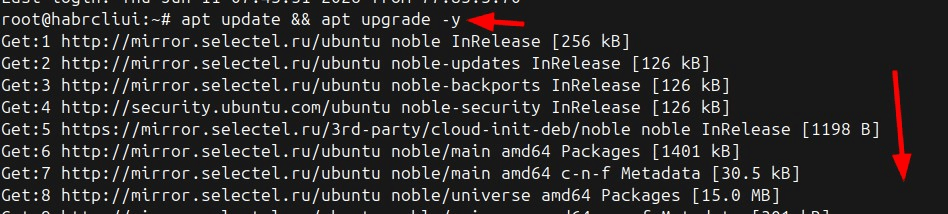
Первое, что делаем на любом свежем сервере — обновляем пакеты:
apt update && apt upgrade -y
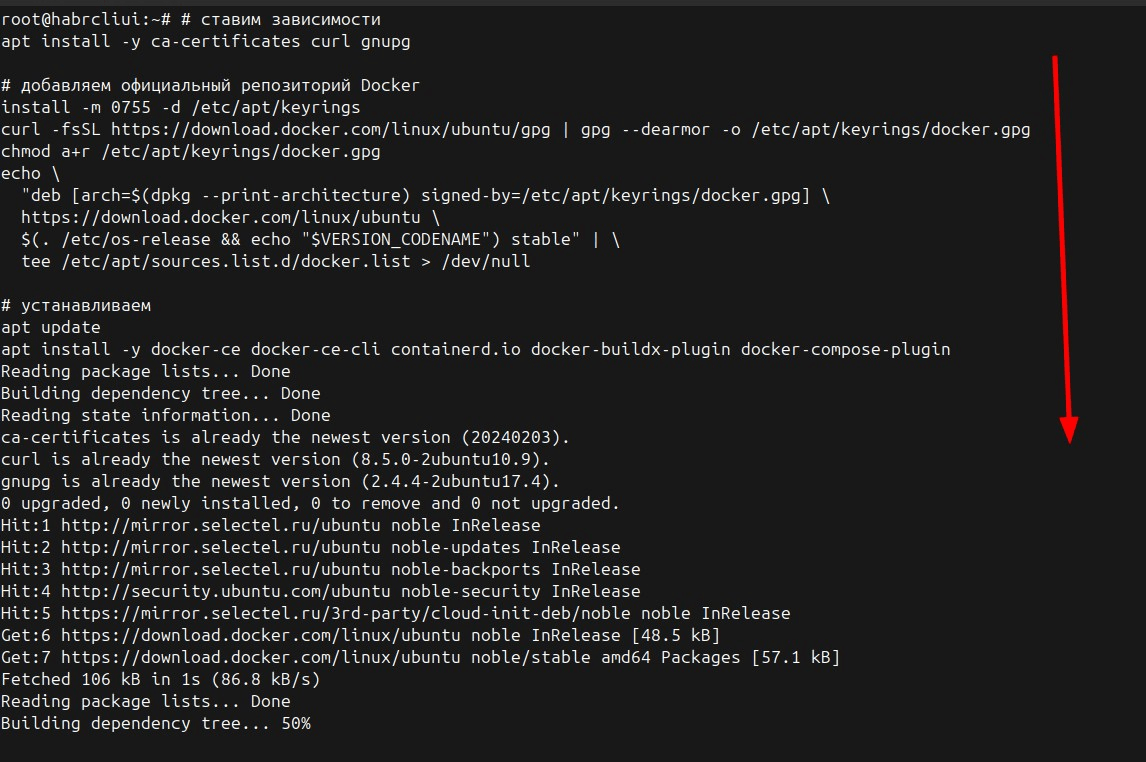
Ставим Docker и Docker Compose
LangGraph CLI в продакшен-режиме работает через Docker — поднимает полный стек через Docker Compose. Поэтому Docker нам обязателен.
      # ставим зависимости
apt install -y ca-certificates curl gnupg

# добавляем официальный репозиторий Docker
install -m 0755 -d /etc/apt/keyrings
curl -fsSL https://download.docker.com/linux/ubuntu/gpg | gpg --dearmor -o /etc/apt/keyrings/docker.gpg
chmod a+r /etc/apt/keyrings/docker.gpg
echo \
  "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] \
  https://download.docker.com/linux/ubuntu \
  $(. /etc/os-release && echo "$VERSION_CODENAME") stable" | \
  tee /etc/apt/sources.list.d/docker.list > /dev/null

# устанавливаем
apt update
apt install -y docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
Проверим, что все корректно установилось:
      docker --version
docker compose version
Поднимаем GraphCLI
Для начала давайте определимся с папкой на сервере в которую мы будем ставить наши проекты (GraphCli и AgentUI).
Я создам папку /opt/yakvenalex и буду клонировать проекты туда:
mkdir /opt/yakvenalex && cd /opt/yakvenalex
Поставим GIT на машину:
apt install git
Клонируем проект:
git clone https://github.com/Yakvenalex/HabrGraphCLI
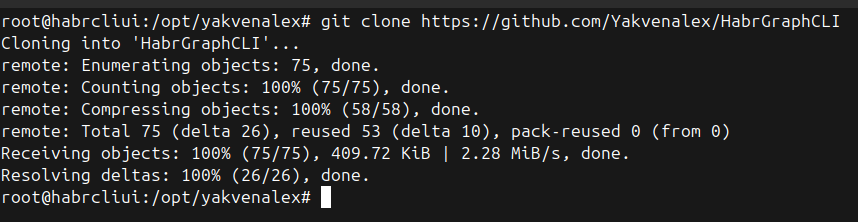
Теперь поднимем проект в прод-режиме. В прошлой части процесс описывал детально, поэтому сейчас буду к нему возвращаться минимально.
Заходим в папку с проектом, создаем внутри файл .env и заполняем переменные окружения.
cd HabrGraphCLI && nano .env
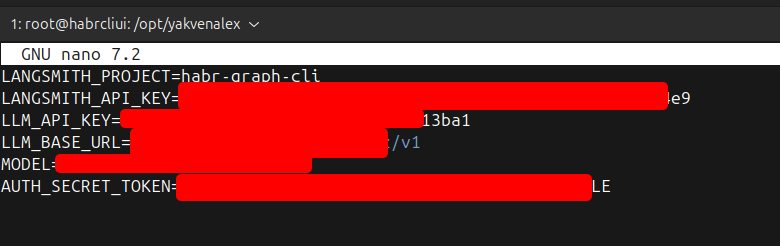
Для сохранения комбинация Ctrl+X, затем Y и затем Enter.
Теперь, для того чтоб собрать проект в продовой среде, нам необходимо установить некоторые дополнительные зависимости.
Вводим:
apt install -y python3 python3-pip python3-venv
Теперь поднимем виртуальное окружение и установим сам GraphCLI (это нам нужно будет для выполнения команды для компиляции проекта в продовой среде).
      python3 -m venv venv
source venv/bin/activate
pip install "langgraph-cli[inmem]" —break-system-packages
Теперь можно собрать образ:
langgraph build -t habr-graph-cli
CLI прочитает langgraph.json, подтянет зависимости из pyproject.toml и соберет образ. При первой сборке это займет несколько минут.
Запускаем в прод-режиме:
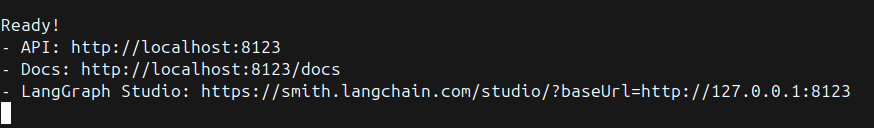
langgraph up
Если вы видите после ввода этой команды картину, как на скрине ниже, то все запустилось у нас корректно.
Остановим и запустим сервер в фоне.
      Ctrl + C
langgraph up --wait
--wait дожидается старта и возвращает управление
Проверим, что все контейнеры успешно запущены.

docker ps
Видим три контейнера: LangGraph API, Redis и PostgreSQL — все в статусе healthy. Стек поднялся полностью.
Теперь обратите внимание на колонку PORTS. Здесь есть важный момент который нельзя пропустить:
- Redis (6379) — доступен только внутри Docker-сети, наружу не торчит. Все правильно;
- PostgreSQL — биндится на 0.0.0.0:5433, то есть доступен на всех интерфейсах;
- LangGraph API — биндится на 0.0.0.0:8123, тоже на всех интерфейсах.
Docker Compose по умолчанию биндит проброшенные порты на все интерфейсы — это его стандартное поведение. Само по себе не критично, но закрыть лишнее файрволом обязательно. Наружу должны смотреть только 80 и 443 — все остальное только внутри машины.
Устанавливаем ufw (файервол), если еще не стоит:
      apt install ufw
Затем откроем только конкретные порты:
ufw allow 22
ufw allow 80
ufw allow 443
ufw enable
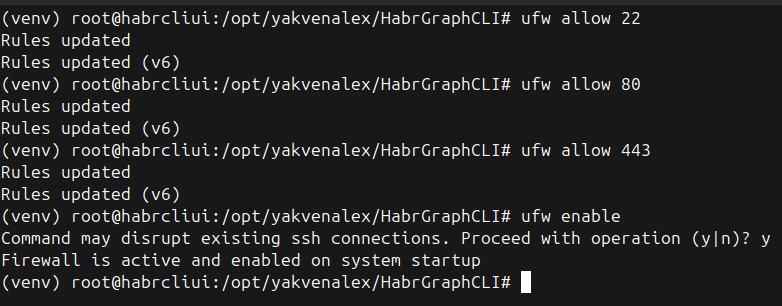
После этого PostgreSQL и LangGraph API физически недоступны снаружи, даже несмотря на 0.0.0.0 в выводе docker ps.
И еще один момент который стоит зафиксировать: в dev-режиме LangGraph Server слушал на порту 2024, в продовом запуске через langgraph up порт изменился на 8123. Это важно — в .env фронтенда нужно будет указать именно его:
NEXT_PUBLIC_API_URL=http://127.0.0.1:8123
Не забудьте об этом когда будете настраивать фронтенд — иначе получите ошибку подключения и будете долго искать причину.
Поднимаем фронтенд
Деактивируем виртуальное окружение и переходим в корневую папку с нашими проектами:
deactivate && cd ../
Теперь клонируем уже фронтенд-проект:
git clone https://github.com/Yakvenalex/Agent-chat-ui-habr
Затем переходим в папку с проектом.
Внутри создаем файл .env и ставим в него необходимые переменные окружения:
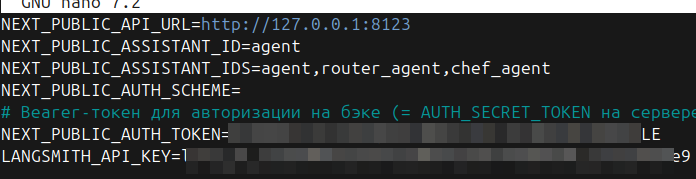
      nano .env
Ctrl + X, Y, Enter
Обратите внимание на NEXT_PUBLIC_API_URL — указываем внутренний адрес с портом 8123, именно на нем крутится LangGraph Server в продовом режиме.
Ставим Node.js 20 через NodeSource:
      curl -fsSL https://deb.nodesource.com/setup_20.x | bash -
apt install nodejs -y
Проверяем, что установилось:
      node -v
npm -v
Устанавливаем зависимости и собираем продовый билд:
      npm install
npm run build
Запускаем:
npm start
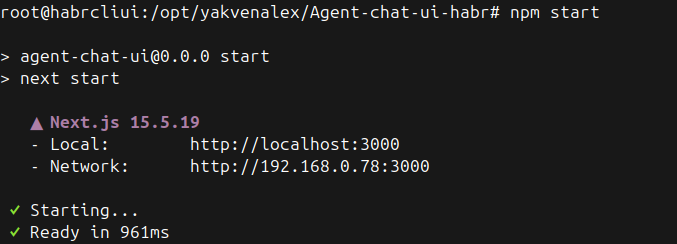
Видим, что проект поднялся, но как только закроем терминал, процесс остановится.
Логично было бы создать Dockerfile и поднять образ через Docker — но для демонстрационного проекта это лишний оверхед. Пойдем по более короткому пути через PM2.
Останавливаем фронт. Для этого нажимаем CTRL + C.
Устанавливаем PM2 глобально:
npm install -g pm2
Запускаем фронтенд через PM2:
pm2 start npm --name "agent-chat-ui" -- start
Настраиваем автозапуск при перезагрузке сервера:
pm2 startup
PM2 автоматически создаст systemd-сервис и включит его. Сохраняем текущий список процессов:
pm2 save
Проверяем что все работает:
pm2 status
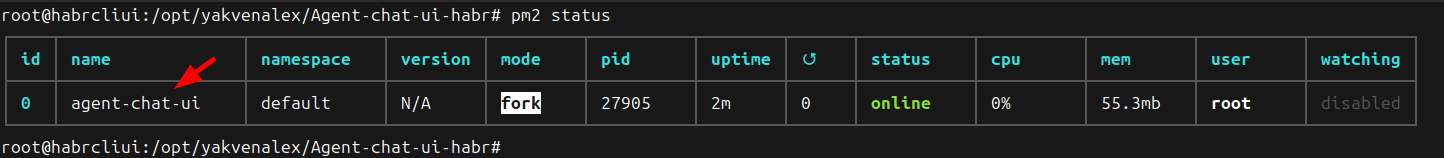
Видим наш процесс agent-chat-ui в статусе online. Фронтенд живет независимо от терминала — можно закрывать сессию.
Несколько полезных команд на будущее:
      pm2 logs agent-chat-ui     # смотреть логи
pm2 restart agent-chat-ui  # перезапустить
pm2 stop agent-chat-ui     # остановить
Фронтенд поднят и работает. Осталось прикрутить к нему домен через Nginx — и сервис будет доступен по красивому адресу.
Проверим, что фронтенд отвечает:
curl http://127.0.0.1:3000

Настраиваем Nginx и SSL
Фронтенд работает на 127.0.0.1:3000 — снаружи не виден. Теперь поставим Nginx который будет принимать запросы на 80 и 443 порты и проксировать их на фронт. Плюс сразу получим SSL-сертификат через Certbot.
Устанавливаем Nginx и Certbot:
apt install nginx certbot python3-certbot-nginx -y
Настраиваем DNS
Прежде чем двигаться дальше — важный момент. Certbot при выпуске сертификата обращается к вашему домену и проверяет что он реально указывает на этот сервер. Если A-запись не настроена, сертификат не выпустится.
Заходим в личный кабинет Selectel → Продукты и в поле «Внешние сетевые сервисы» нажимаем на Доменные зоны и убеждаемся, что статус изменился на «Делегирована».
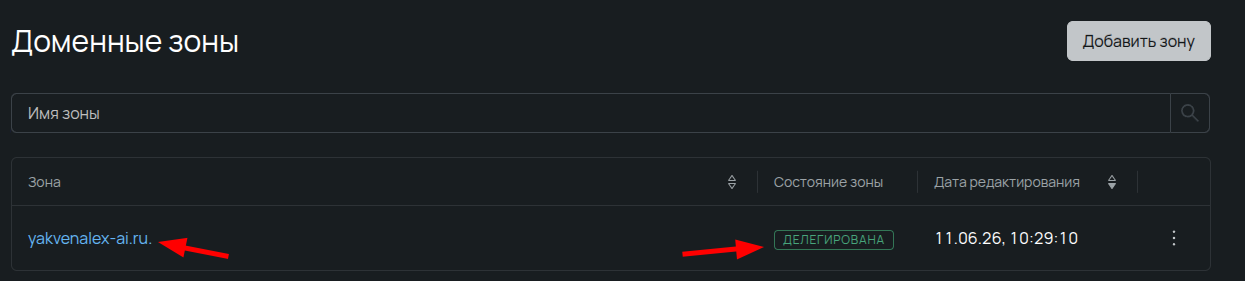
Если этот так, то кликаем на домен и проваливаемся в меню управления DNS-записями.
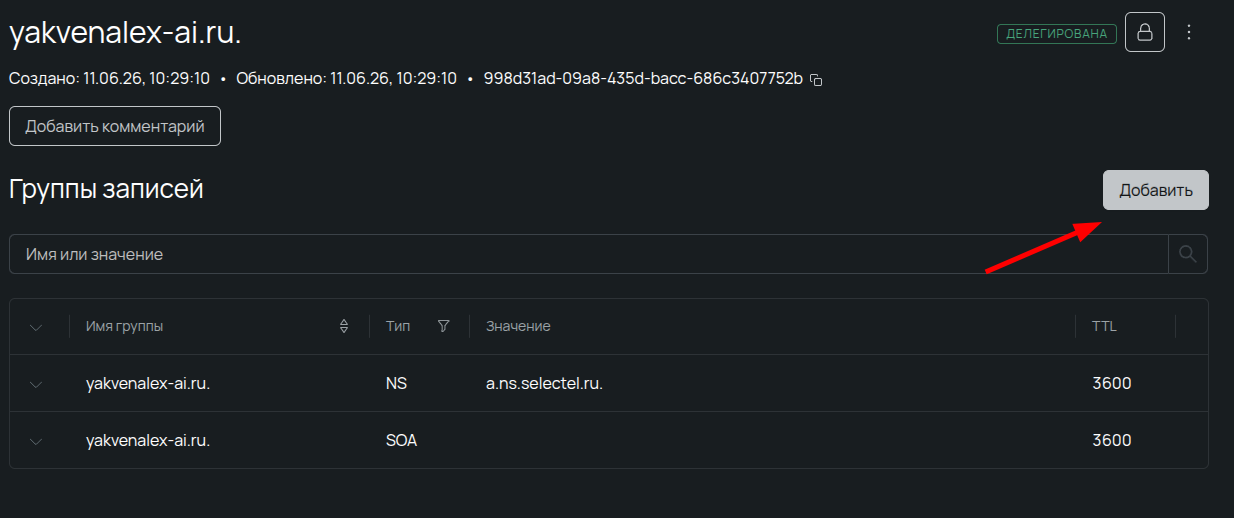
И добавляем две А-записи.
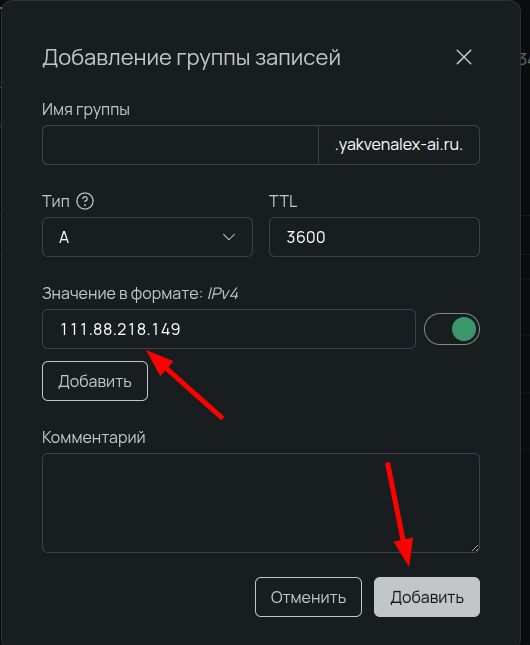
С пустым именем группы:
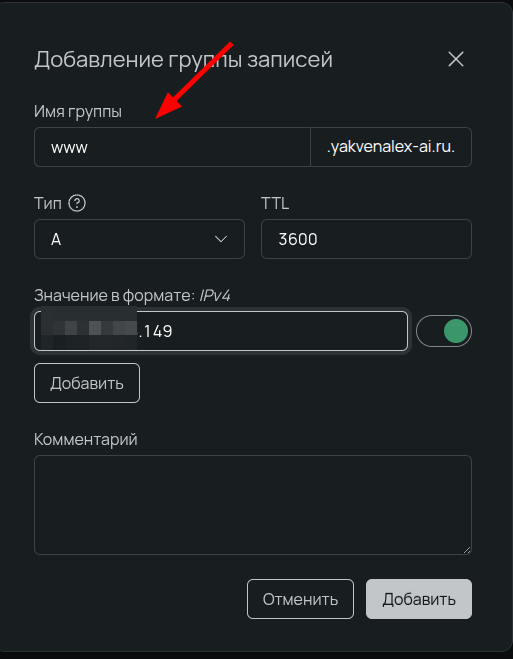
На выходе получаем это:
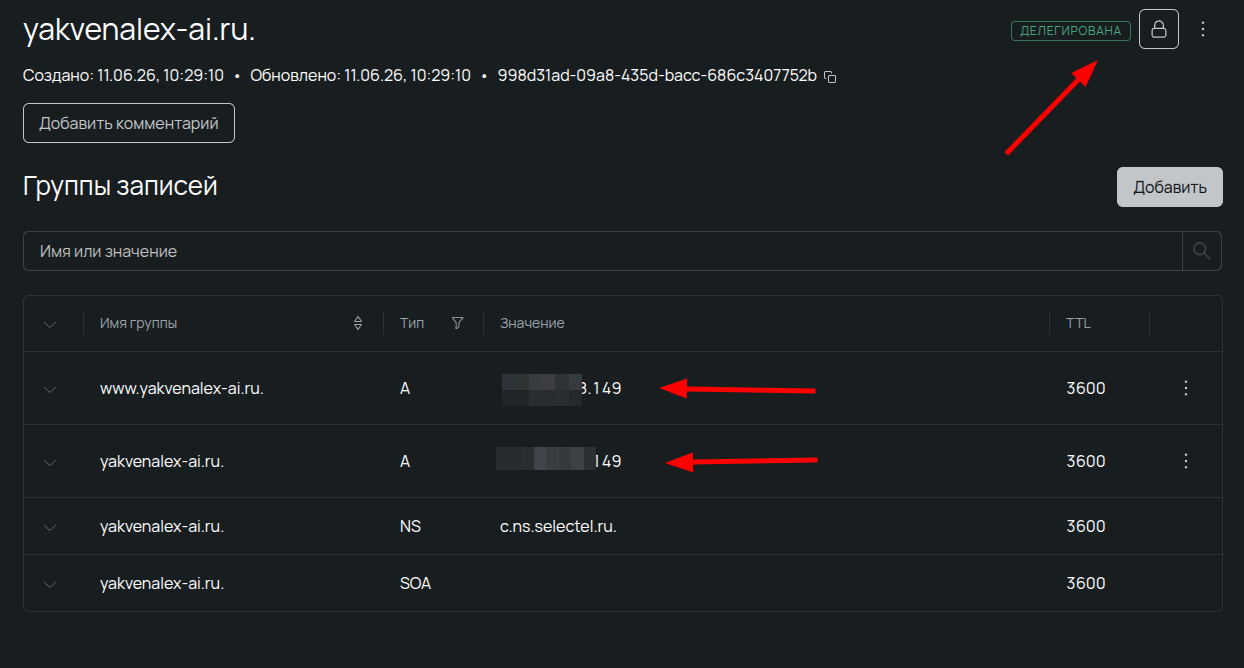
После сохранения DNS propagation может занять от нескольких минут до нескольких часов. Проверить с любой машины, что домен уже указывает на наш сервер, можно командой:
ping ваш_домен.ru
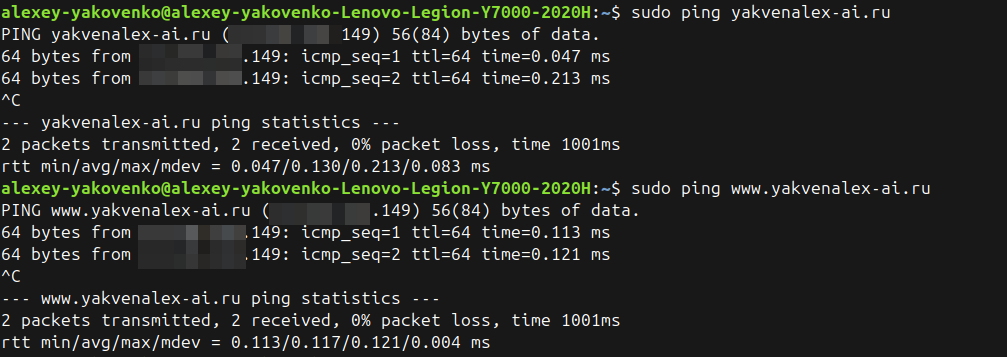
Если в ответе видите IP вашего VPS — можно двигаться дальше.
Готовим конфиг Nginx
Создаем конфигурационный файл для нашего домена:
nano /etc/nginx/sites-available/agent-chat-ui
Вставляем конфиг:
      server {
    listen 80;
    server_name ваш_домен.ru www.ваш_домен.ru;

    location / {
        proxy_pass http://127.0.0.1:3000;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection 'upgrade';
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_cache_bypass $http_upgrade;
    }
}
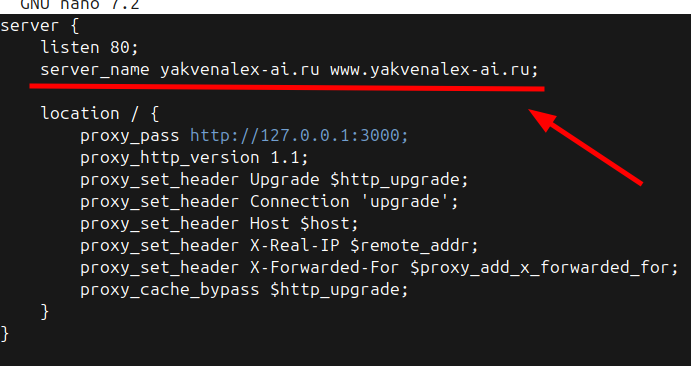
Активируем конфиг и проверяем что нет синтаксических ошибок:
      ln -s /etc/nginx/sites-available/agent-chat-ui /etc/nginx/sites-enabled/
nginx -t
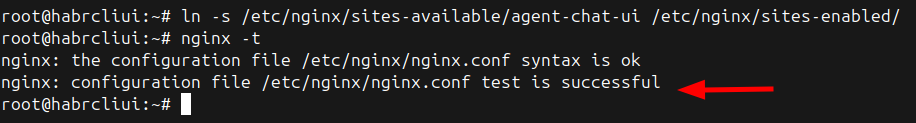
Перезапускаем Nginx:
systemctl restart nginx
Получаем SSL-сертификат
certbot --nginx -d ваш_домен.ru -d www.ваш_домен.ru
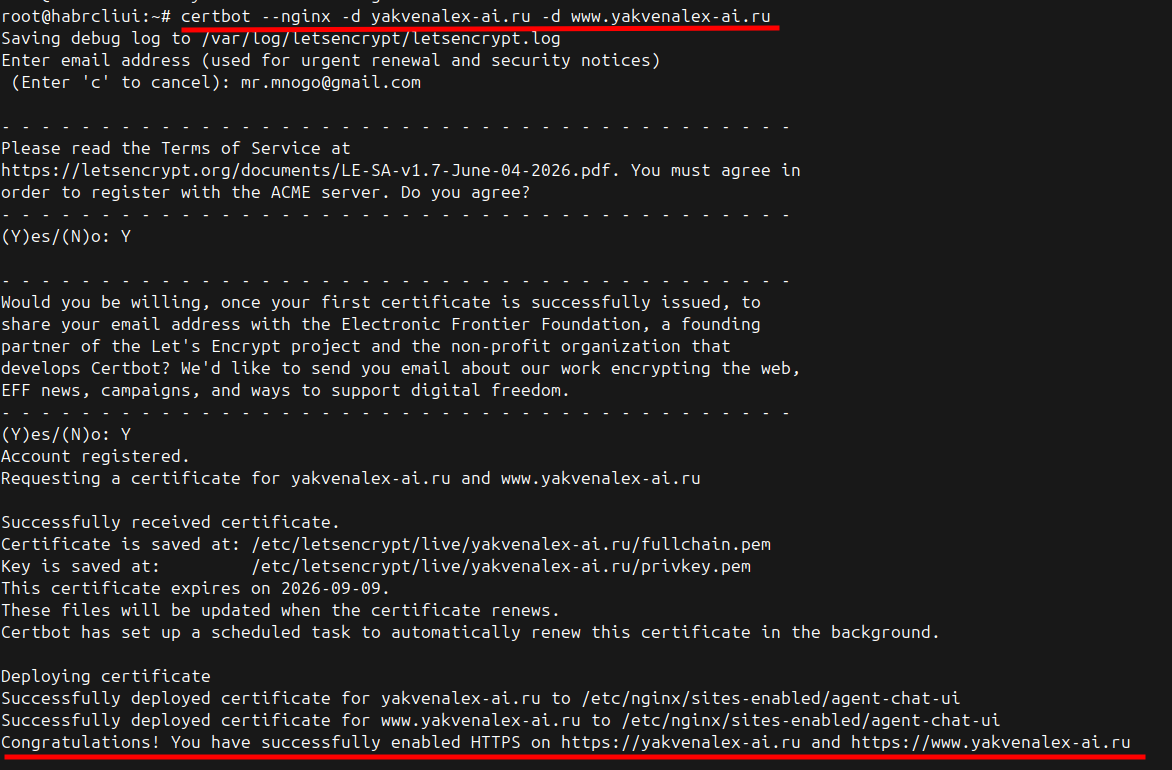
Certbot попросит email для уведомлений об истечении сертификата, примет соглашение — и автоматически получит сертификат и обновит конфиг Nginx для работы по HTTPS. После этого проверяем:
systemctl status nginx
Настраиваем фронтенд для работы в проде
Прежде чем открывать браузер — важный момент. Из-за того что порт 8123 закрыт файрволом и из-за особенностей Next.js (NEXT_PUBLIC_ переменные вшиваются в клиентский бандл и выполняются в браузере пользователя, а не на сервере), прямое подключение фронта к 127.0.0.1:8123 работать не будет. Браузер будет искать этот адрес на машине пользователя, а не на сервере.
Решаем это через встроенный в проект API Passthrough — Next.js сам проксирует запросы на LangGraph изнутри сервера. Браузер ходит на наш домен, сервер проксирует дальше на 127.0.0.1:8123. Порт наружу не открываем.
Обновляем .env фронтенда:
      nano /opt/yakvenalex/Agent-chat-ui-habr/.env
# сервер ходит на LangGraph напрямую — без NEXT_PUBLIC_
LANGGRAPH_API_URL=http://127.0.0.1:8123

# браузер ходит на свой же Next.js через домен
NEXT_PUBLIC_API_URL=https://ваш_домен.ru/api
# остальное без изменений
NEXT_PUBLIC_ASSISTANT_IDS=agent,router_agent,chef_agent
NEXT_PUBLIC_AUTH_TOKEN=ваш_токен
NEXT_PUBLIC_AUTH_SCHEME=
Пересобираем и перезапускаем:
      bashnpm run build
pm2 restart agent-chat-ui
Теперь открываем браузер и переходим на https://ваш_домен.ru — должен открыться наш AI-интерфейс с валидным SSL-сертификатом.
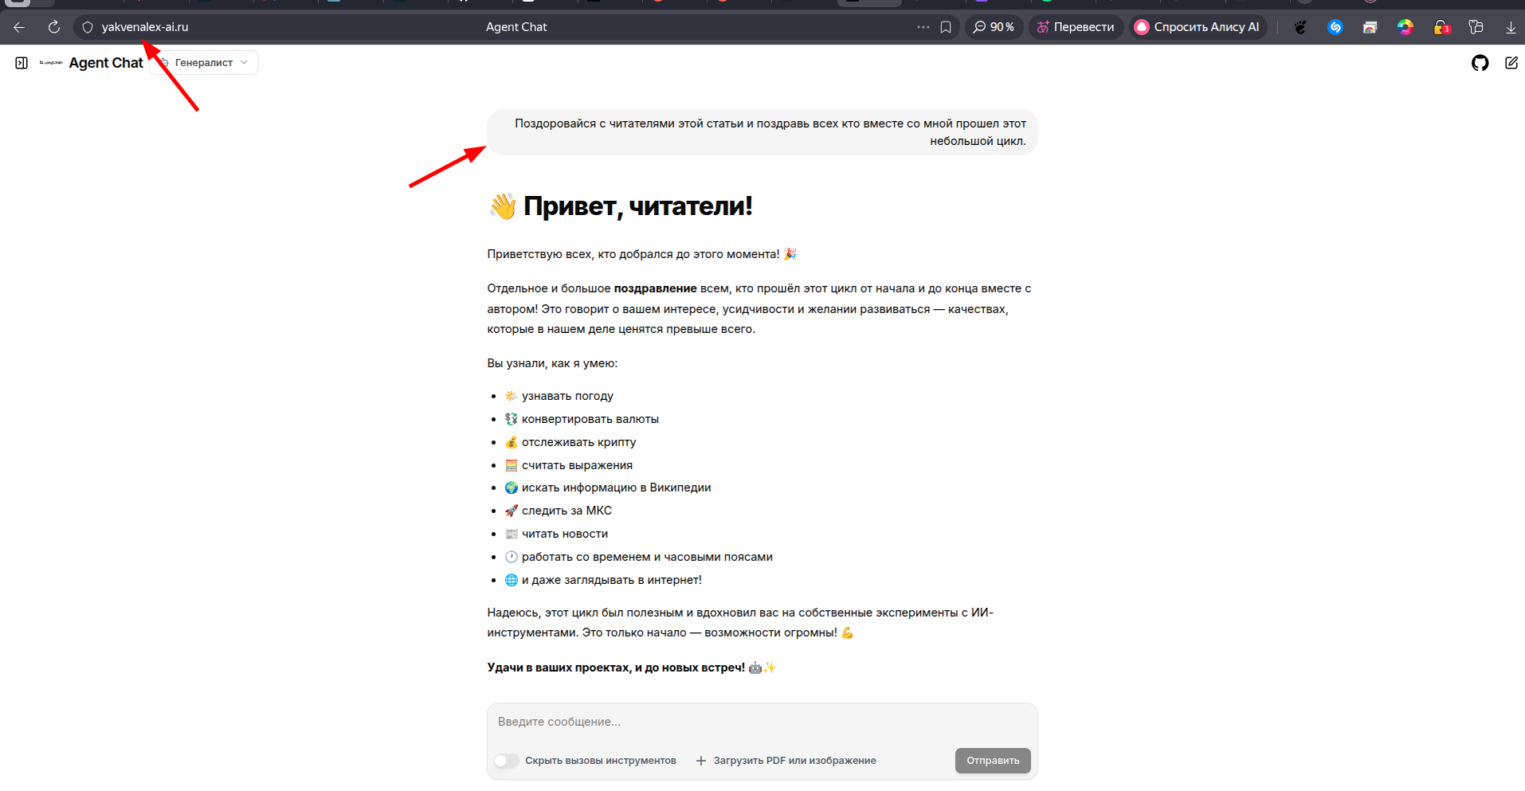
Напомню про безопасность: наружу через файрвол у нас торчат только порты 80 и 443. LangGraph API на порту 8123 и PostgreSQL на 5433 закрыты — доступны только внутри машины. Пользователь видит только чистый интерфейс по вашему домену, до бэкенда снаружи не добраться.
Итоги
Вот мы и добрались до финала.
Давайте зафиксируем что сделали в этой части.
Мы взяли уже работающий агентный бэкенд из прошлых статей, добавили к нему двух новых агентов с разной архитектурой, закрыли API Bearer-авторизацией — с разбором нюансов которых нет в официальной документации.
Затем развернули профессиональный Next.js-фронтенд, кастомизировали его под реальное использование: перевели на русский, добавили переключатель между агентами, удаление чатов, авторизацию во всех точках. И выкатили все это на боевой сервер с доменом и SSL.
Теперь посмотрим на картину целиком — что мы построили за три части:
- Часть 1 — подняли облачную LLM на 16 ГБ VRAM через vLLM, получили OpenAI-совместимый API и научились с ним работать;
- Часть 2 — собрали агентный бэкенд на LangGraph с MCP-серверами, получили полноценный REST API через LangGraph Server и обернули его в FastAPI-сервис;
- Часть 3 — дали всему этому лицо. Развернули production-ready фронтенд, настроили авторизацию, задеплоили с доменом в приватный контур;
Итоговая схема того, что работает сейчас:
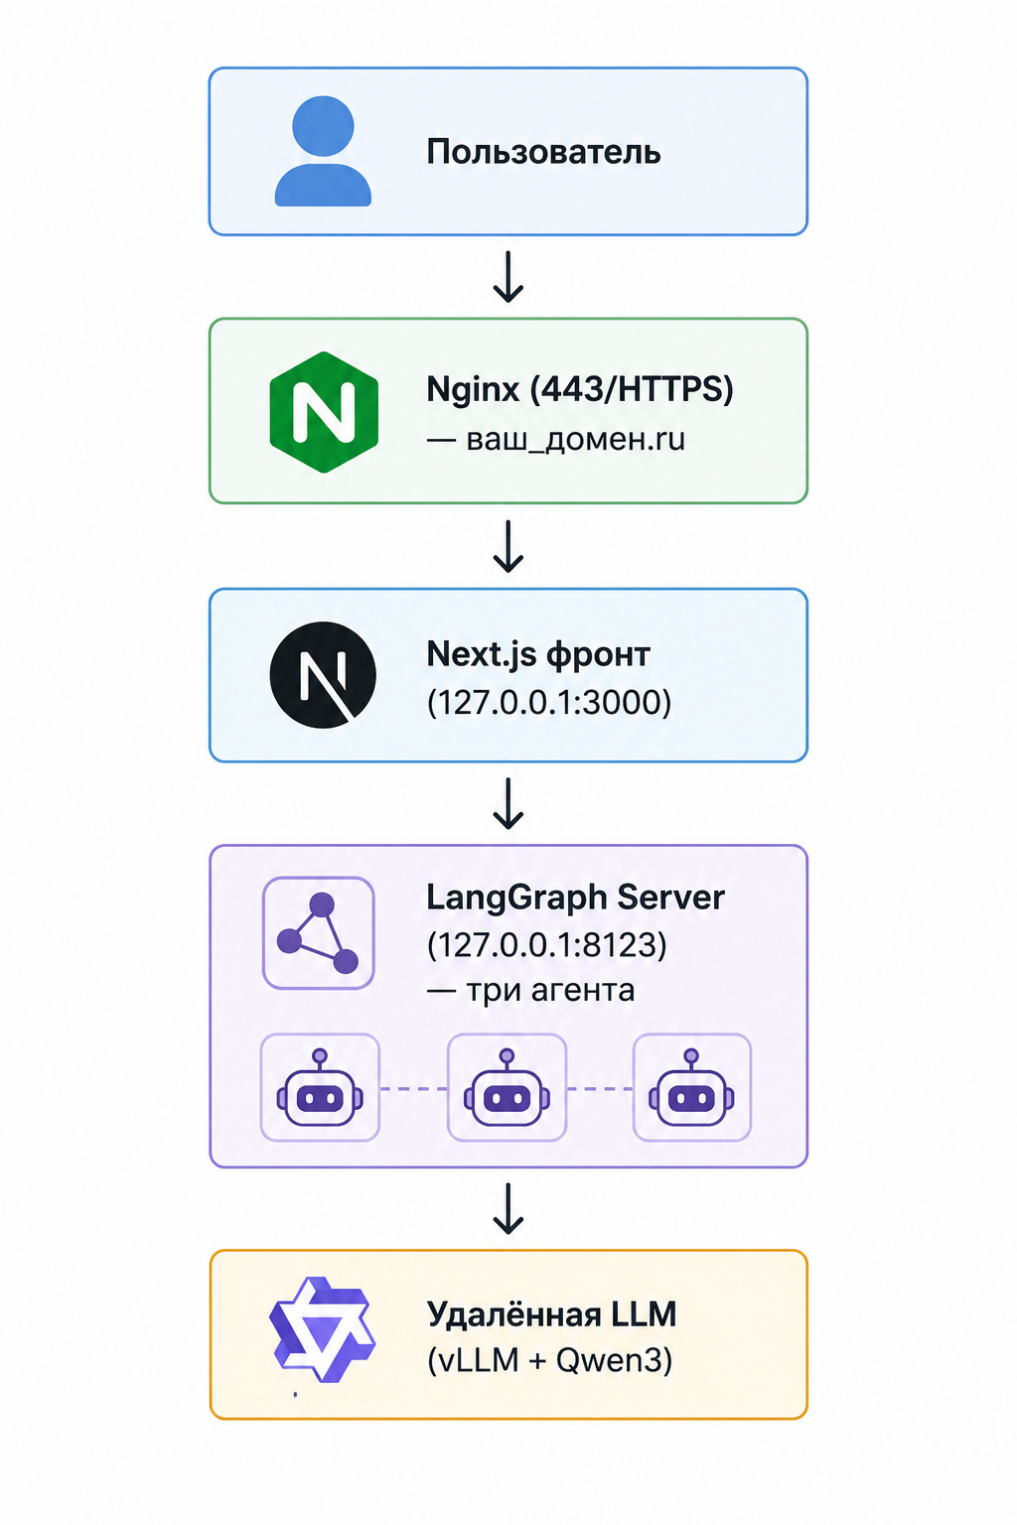
Это полноценный AI-продукт, который работает на вашей инфраструктуре, под вашим контролем, без зависимости от OpenAI и без утечки данных наружу. Именно к этому мы и шли.
Что можно делать дальше, если хочется развивать этот стек
- заменить общий Bearer-токен на полноценную систему пользователей с JWT и ролями;
- добавить собственные MCP-серверы под конкретную предметную область — корпоративные данные, внутренние API, базы знаний;
- докрутить агентов под реальные бизнес-задачи: анализ документов, работа с БД, интеграция с внутренними системами;
- заменить agent-chat-ui на полностью кастомный фронтенд когда бизнес-требования вырастут из готового решения.
Цикл закрыт. Спасибо всем, кто прошел этот путь вместе — от первого vllm serve до работающего сервиса по своему домену.
Все репозитории из цикла:
HabrGraphCLI — бэкенд;
Agent-chat-ui-habr — фронтенд.