Простая нейросеть на Keras помещается примерно в 20 строк кода. Звучит как преувеличение, но проверить это можно за один вечер. Еще недавно глубокое обучение считалось уделом исследователей, а сегодня первую модель собирают на обычном ноутбуке даже те, кто только знакомится с машинным обучением.
Помогает в этом Keras: он берет на себя рутину и оставляет разработчику самое интересное — выбор архитектуры и работу с данными. Выясним, что это за библиотека, чем она отличается от TensorFlow и PyTorch, как ее установить и как запустить первую программу.
Что такое Keras
Keras — это открытая библиотека для Python с высокоуровневым API, с помощью которой собирают и обучают нейронные сети. С его помощью работа по построению модели облегчается в разы. Высокоуровневый API означает, что пользователь описывает структуру модели и вызывает готовые методы обучения, а отдельные математические операции программа выполняет автоматически.
Зачем нужна библиотека
Современная нейросеть состоит из десятков слоев. Описать такую сеть можно на чистом Python, но тогда придется самому считать производные, по которым изменяются параметры модели, и следить за тысячами чисел вручную.
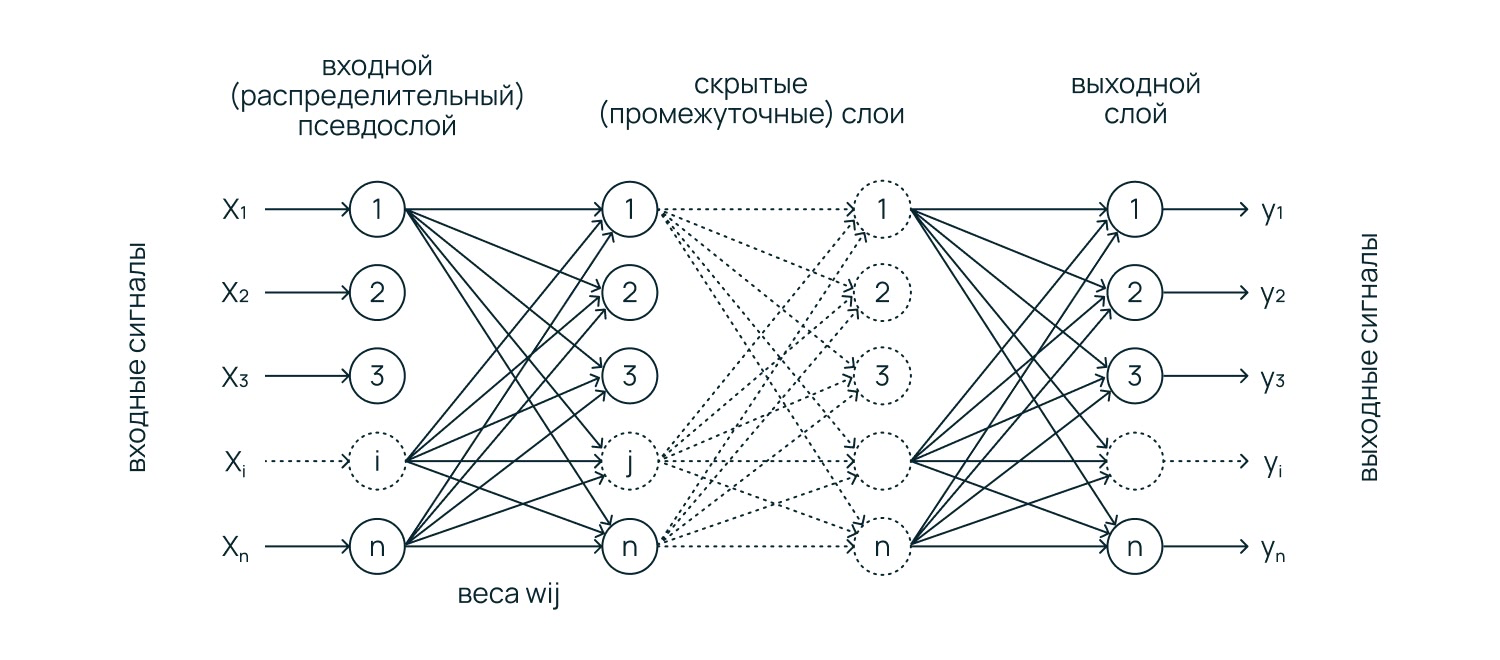
Keras выполняет эти операции автоматически: для описания сети достаточно указать число слоев и их размер, поэтому код получается короче и проще для чтения. В библиотеке есть также готовые функции потерь, оптимизаторы, методы обучения и проверки модели и инструменты для подготовки данных.
Роль Keras в построении моделей
Keras отвечает за построение модели и за порядок обучения: какие слои взять, как их соединить, чем измерять ошибку и каким методом ее уменьшать. Сама библиотека вычислений не выполняет. Расчеты, то есть операции с тензорами и вычисление градиентов, выполняет другая библиотека, которую в Keras называют бэкендом.
По умолчанию этим бэкендом в Keras служит библиотека TensorFlow. Версия Keras 3 поддерживает три бэкенда для обучения моделей: TensorFlow, JAX и PyTorch. При смене бэкенда код модели остается прежним.
Особенности Keras
Разработка Keras опирается на три принципа: простой и единообразный API, модульность и расширяемость. Простой и единообразный API (он же — программный интерфейс) означает, что все инструменты библиотеки устроены по единой логике и требуют минимум кода. Вы используете одни и те же привычные команды для решения самых разных задач, поэтому не приходится заучивать сложные правила под каждый новый тип нейросети.
Модульность означает, что слои, функции потерь, оптимизаторы и метрики — это самостоятельные компоненты, которые можно легко сочетать друг с другом, как детали конструктора.
Расширяемость дает свободу творчества: если стандартных деталей не хватает, разработчик может написать собственный уникальный компонент и без проблем подключить его к остальным. Чтобы понять, как эти принципы работают на практике, разберем несколько базовых понятий, без которых не обходится ни одна модель.
Нейроны и модель
Нейросеть состоит из слоев, а слои состоят из нейронов. Нейроны — вычислительные элементы, которые принимают числа, преобразуют их по формуле и передают результат дальше. Совокупность слоев, нейронов и связей между ними называется моделью. Обучение модели — это подбор ее внутренних параметров на примерах: модель получает данные, выдает ответ, ответ сравнивается с правильным, и параметры изменяются так, чтобы ошибка уменьшалась.
Слои
Слой — это структурная единица нейронной сети: группа нейронов, которая получает на вход набор чисел, преобразует его и передает результат следующему слою. Входные числа образуют вектор, то есть упорядоченный набор значений, например координаты точки или признаки объекта. Для первого слоя этот вектор состоит из исходных данных, для остальных слоев он составляется из выходных значений предыдущего слоя.
Нейрон вычисляет значение по формуле:
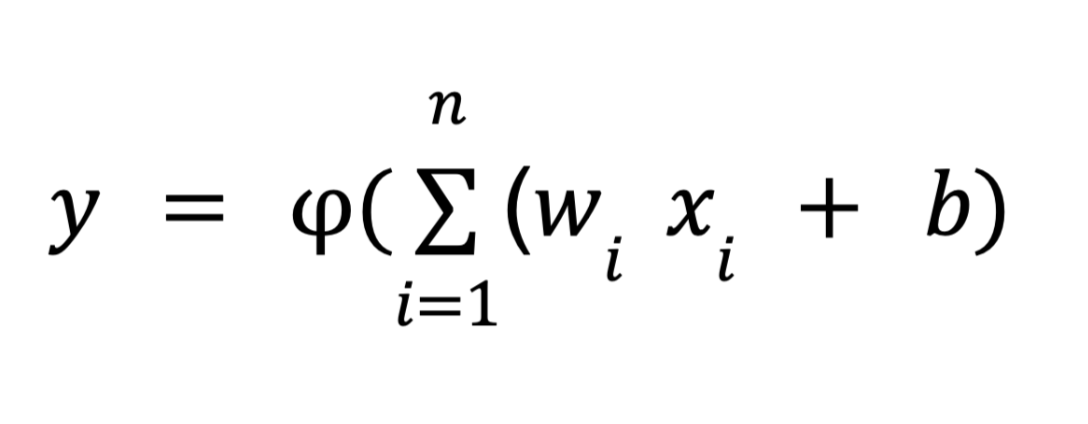
где x — входные числа;
W — веса (коэффициенты, определяющие значимость каждого входа);
b — смещение;
𝜑 — функция активации;
y — выходное значение нейрона, передающееся дальше.
Каждое входное число умножается на свой вес, результаты суммируются, к сумме прибавляется смещение, а затем к результату применяется функция активации. Вес показывает, насколько важно для нейрона данное входное число. Смещение сдвигает сумму и позволяет нейрону срабатывать, даже если все входы равны нулю. Веса и смещения сеть подбирает сама в процессе обучения; пользователь задает только число нейронов и функцию активации.
Самый распространенный слой называется Dense: в нем каждый нейрон получает все числа от предыдущего слоя. Он универсален и подходит для любых числовых данных. Для данных с особой структурой есть специальные слои — например, сверточные, которые используются для работы с изображениями.
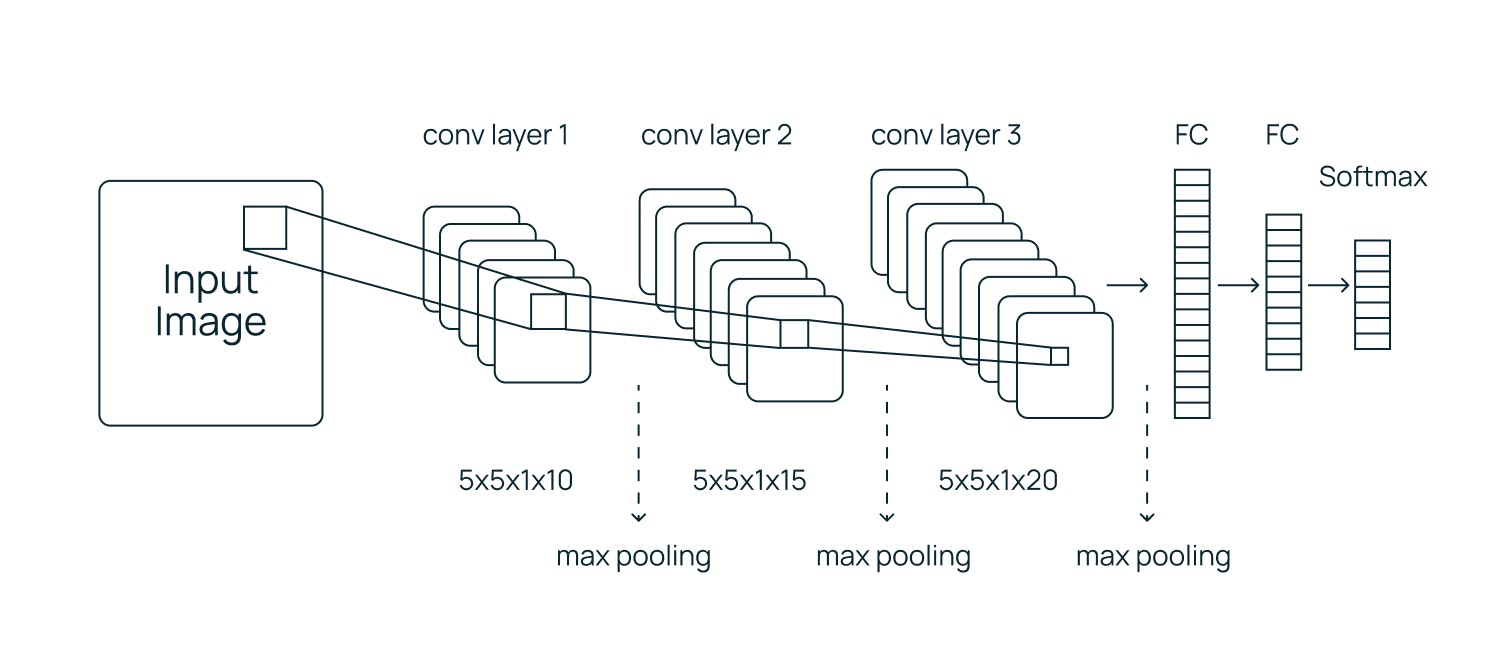
Например:
- сверточные (Conv1D) для звука;
- сверточные (Conv2D) для изображений;
- Embedding и LSTM для текста и последовательностей.
Слои Keras свободно комбинируются, а при желании можно написать собственный.
Оптимизатор
Оптимизатор (optimizer) — это алгоритм, который изменяет параметры модели (веса и смещения) так, чтобы значение функции потерь уменьшалось. Принцип основан на градиенте: это вектор производных функции потерь по каждому параметру, и он показывает, в каком направлении ошибка растет быстрее всего.
Оптимизатор изменяет параметры в противоположном направлении, поэтому ошибка уменьшается. Такой метод называется градиентным спуском. Размер изменения за один шаг задает параметр learning_rate. Если он слишком мал, ошибка уменьшается медленно и обучение занимает много времени. Если он слишком велик, параметры меняются слишком сильно и пропускают минимум функции потерь.
В Keras доступно несколько оптимизаторов. SGD (стохастический градиентный спуск) обновляет параметры по небольшим порциям данных. RMSprop делит шаг на скользящее среднее квадратов градиентов, поэтому шаг подстраивается под каждый параметр. По умолчанию применяют Adam. Он использует скользящие средние градиента и его квадрата, тоже подбирает шаг для каждого параметра, быстрее приводит обучение к сходимости и требует меньше настройки.
Функция потерь (loss function)
В Keras функцию потерь задают при компиляции модели параметром loss в model.compile(). Функция потерь показывает, насколько ответы модели отличаются от правильных. Чем меньше это число, тем точнее модель. Во время обучения оптимизатор подбирает параметры так, чтобы значение функции потерь уменьшалось. Выбор функции зависит от задачи.
Варианты, использующиеся в Keras:
- mean_squared_error — среднее значение квадратов разности между ответом модели и правильным ответом. Используется для предсказания числа (регрессии), например, для предсказания температуры или цены;
- binary_crossentropy — модель выдает одно число от 0 до 1, которое трактуется как вероятность первого класса, поэтому последний слой использует функцию активации sigmoid. Используют для классификации на два класса (например, «да» и «нет»);
- sparse_categorical_crossentropy — последний слой в этом случае возвращает вероятность для каждого класса, для чего применяется функция активации softmax. Используют для классификации на несколько классов с метками в виде целых чисел (номер класса).
Ограничения Keras
Несмотря на удобство библиотеки, при работе с ней важно учитывать четыре основных ограничения. Во-первых, это зависимость от бэкенда. Keras не выполняет вычисления самостоятельно, поэтому для реализации нестандартных или сложных операций может потребоваться писать код напрямую на уровне выбранного вычислительного движка.
Во-вторых, существует проблема несовместимости версий. В Keras 3 были удалены или изменены некоторые функции из прошлых релизов: например, метод predict_classes больше не поддерживается, и вместо него теперь используют predict. Кроме того, библиотека предъявляет высокие требования к данным и ресурсам. Для решения сложных задач вам понадобятся большие наборы размеченных данных и значительное время на вычисления.
Наконец, для эффективной работы с инструментом необходима базовая теоретическая подготовка. Keras заметно упрощает написание кода, однако чтобы грамотно оценивать результаты модели, нужно понимать основы машинного обучения — например, что такое градиент, функция активации и переобучение.
Сравнение с TensorFlow, PyTorch
Кроме Keras существуют другие библиотеки для создания нейронных сетей со схожим функционалом: TensorFlow, PyTorch и JAX. Прямыми конкурентами они не являются, так как они различаются уровнями абстракции. Уровень абстракции — это способ скрыть лишние детали реализации системы, чтобы работать с ней через более простой и понятный интерфейс. Этот подход помогает управлять сложностью программ и оборудования.
Keras — это высокоуровневый API, который предлагает готовые слои и методы compile, fit и predict. TensorFlow и PyTorch — это фреймворки, то есть наборы библиотек, которые выполняют вычисления с тензорами и автоматически вычисляют градиенты. Их можно использовать и без Keras, но тогда разработчик описывает больше операций самостоятельно. Keras и TensorFlow решают задачи разных уровней и применяются вместе.
Выбирают так: нужен быстрый прототип со стандартными слоями, берут Keras. Если нужен более сложный цикл обучения с многоуровневыми расчетами, то используют PyTorch или TensorFlow напрямую. При этом не забываем, что Keras 3 может работать на бэкенде PyTorch или TensorFlow для выполнения более простых задач.
Установка Keras
Зависимости ( Python, TensorFlow и подобные)
Для корректной работы Keras необходимо установить Python версии 3.10 и выше. Кроме самого Keras понадобится бэкенд, то есть движок вычислений.
Как установить Keras с помощью pip
Менеджер пакетов pip — это самый простой инструмент для установки библиотек, потому что он устанавливается вместе с Python и не требует дополнительной конфигурации. Рекомендуется устанавливать Keras в виртуальном окружении. Это изолирует зависимости проекта и предотвращает конфликты между разными проектами.
Как создать виртуальное окружение с помощью стандартной Python-библиотеки venv:
      python3 -m venv .venv
source .venv/bin/activate
После этого можно переходить к установке Keras. По умолчанию в качестве бэкенда будет использоваться TensorFlow.
Выполните команду в терминале:
pip install keras tensorflow
Если вы хотите выбрать другой фреймворк (например, jax или torch), то в предыдущем шаге вам необходимо прописать его вместо tensorflow, например:
pip install keras jax
По умолчанию Keras ищет TensorFlow. Если пакета нет, при импорте появится ошибка ModuleNotFoundError: No module named ‘tensorflow’.
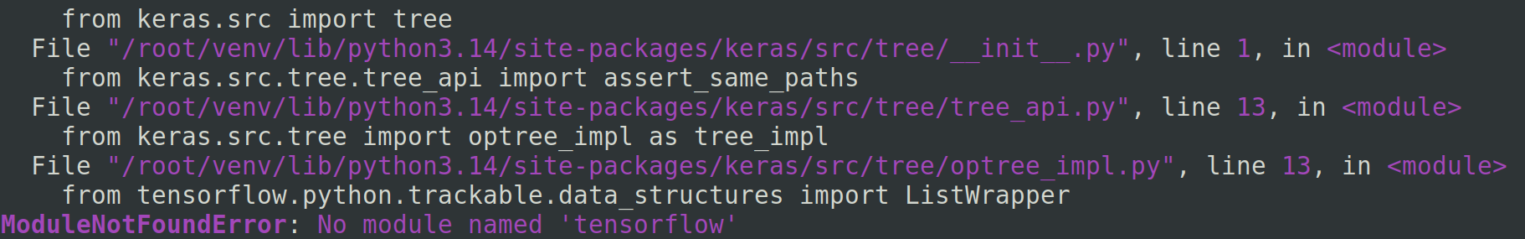
Чтобы исправить ошибку, нужно добавить переменную окружения KERAS_BACKEND со значением jax или torch до импорта Keras. В Python, в файле с кодом, это делается так:
      import os
os.environ["KERAS_BACKEND"] = "jax"
import keras
То же значение можно записать в файл ~/.keras/keras.json в поле backend вместо tensorflow.
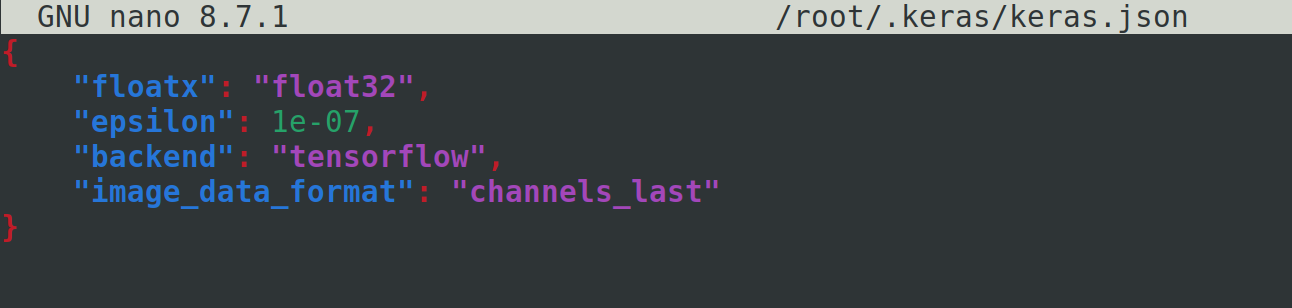
Заменим значение на jax:
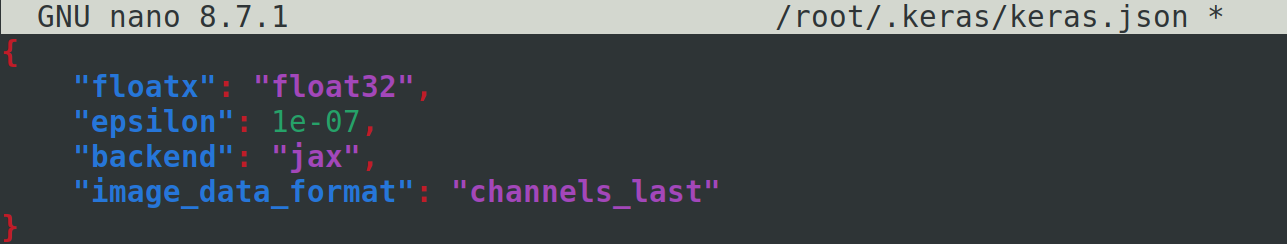
Теперь ошибки ModuleNotFoundError: No module named ‘tensorflow’ не будет.
Проверка установки
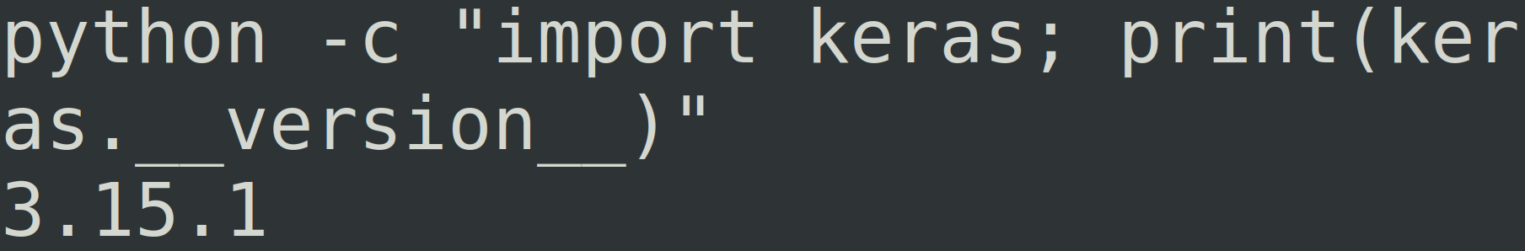
Запустите в терминале команду:
python -c "import keras; print(keras.__version__)"
В выводе появится версия Keras, например 3.15.1.
Библиотеки и инструменты для работы
Для базовой работы хватит самого Keras и библиотеки для бэкенда, а остальные инструменты подключаются только под конкретные задачи. Например, библиотека NumPy хранит данные в виде многомерных массивов и выполняет над ними математические операции. Именно на ней строится подготовка информации, так как модель Keras принимает на вход готовые массивы NumPy.
Если требуется ускорить нейросетевые вычисления на видеокарте, понадобится библиотека cuDNN от NVIDIA, для работы которой также необходимы видеодрайвер и платформа CUDA. Без этих компонентов Keras спокойно запустится на обычном процессоре, просто обучение займет больше времени.
Для визуализации архитектуры пригодятся инструменты Graphviz и Pydot, которые позволяют отрисовывать схемы моделей с помощью функции keras.utils.plot_model. А библиотеки HDF5 и h5py отвечают за сохранение весов в формате .h5. Современный формат .keras их уже не требует, но такие модули все еще нужны для совместимости со старыми проектами.
Как начать работать с Keras: первая модель
Возьмем простую задачу: перевод градусов Цельсия в градусы Фаренгейта. Температура пересчитывается по формуле:
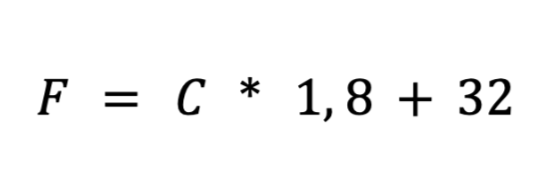
Сети эту формулу мы не покажем. Дадим ей несколько пар чисел и посмотрим, найдет ли она закономерность сама.
Для такой задачи достаточно одного нейрона. В нашей задаче на входе температура по Цельсию, на выходе температура по Фаренгейту, поэтому и вход, и выход состоят из одного числа.
Шаг 1: данные
      import numpy as np
import keras
from keras import layers
keras.utils.set_random_seed(1)  # зафиксируем начальное состояние генератора случайных чисел, чтобы начальные веса и результат повторялись при каждом запуске

# данные для обучения: температура в градусах Цельсия

celsius = np.array([-40, -20, -10, 0, 8, 15, 22, 38, 60], dtype="float32")

# правильные ответы в градусах Фаренгейта
fahrenheit = celsius * 1.8 + 32
Функция set_random_seed задает начальное значение генератора случайных чисел. Начальные веса слоя выбираются случайно, поэтому при одном и том же значении (в примере это 1) каждый запуск дает одинаковые начальные веса и одинаковый результат. Без этой строки результаты немного отличались бы от запуска к запуску.
Массив celsius это то, что получает модель на входе. Массив fahrenheit хранит правильные ответы. В реальных проектах ответы берут из таблиц или измерений, а здесь мы посчитали их по формуле, чтобы потом проверить, угадала ли сеть.
Шаг 2: модель
      model = keras.Sequential([
    keras.Input(shape=(1,)),   # на входе одно число
    layers.Dense(1),           # на выходе тоже одно число
])
Объект Sequential принимает список слоев. Input(shape=(1,)) сообщает форму входных данных: одно число на каждый пример. Слой Dense(1) создает один нейрон.
Шаг 3: настройка и обучение
      # выбираем функцию потерь и оптимизатор
model.compile(optimizer=keras.optimizers.Adam(learning_rate=0.1),

              loss="mean_squared_error")

# обучение: 1500 проходов по всем данным
history = model.fit(celsius, fahrenheit, epochs=1500, verbose=0)
Метод compile подключает к модели оптимизатор Adam с размером шага 0,1 и функцию потерь mean_squared_error, подходящую для задач с числовым ответом. Функция берет разность между ответом модели и ожидаемым ответом, возводит ее в квадрат и усредняет по всем примерам. Квадрат делает любое отклонение положительным и сильнее учитывает большие ошибки.
Обучение запускает метод fit. Один проход по всем данным называется эпохой. Выбрано 1 500 эпох: этого хватает для сходимости, то есть для состояния, в котором ошибка перестает заметно уменьшаться. Параметр verbose=0 отключает вывод каждой эпохи на экран, а история ошибок сохраняется в объекте history.
Шаг 4: проверка
Сначала определим, чего мы ждем от модели. Две температуры, которых нет в обучающих данных, мы пересчитаем по формуле сами. Для 100 °C получаем 100 × 1,8 + 32 = 212 °F (температура кипения воды), для 37 °C получаем 37 × 1,8 + 32 = 98,6 °F (температура тела). Кроме того, мы ожидаем, что модель найдет вес 1,8 и смещение 32, то есть коэффициенты формулы.
      for value in (100, 37):

    result = model.predict(np.array([[value]]), verbose=0)[0][0]

    print(f"{value} °C -> {result:.1f} °F")

weight, bias = model.layers[0].get_weights()

print(f"вес: {weight[0][0]:.2f}, смещение: {bias[0]:.2f}")
Метод predict принимает массив формы (количество примеров, 1) и возвращает массив ответов той же формы. Метод get_weights возвращает список из двух массивов: весов и смещений. В выводе для каждого значения печатаются ответ модели и ответ по формуле, поэтому сравнение видно сразу.
На нашем запуске (Keras 3.15.1, бэкенд TensorFlow) вышло так:
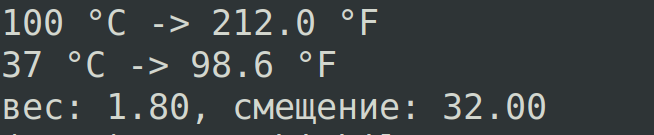
Ответы модели совпали с ожидаемыми. Вода кипит при 212 °F, а температура тела равна 98,6 °F. Вес 1,80 и смещение 32,00 совпадают с коэффициентами формулы (F = C × 1,8 + 32). Нейрон без функции активации выполняет линейную регрессию, то есть подбирает прямую по набору точек.
Чтобы вывести изменение ошибки в процессе обучения, можно добавить в код следующие строчки:
      loss_values = history.history['loss']
target_epochs = [1, 100, 500, 1500]
print("Изменение ошибки на выбранных эпохах:")

for epoch in target_epochs:
    current_loss = loss_values[epoch - 1]
    print(f"Эпоха {epoch:4d}: ошибка = {current_loss:.4f}")
В выводе получим:
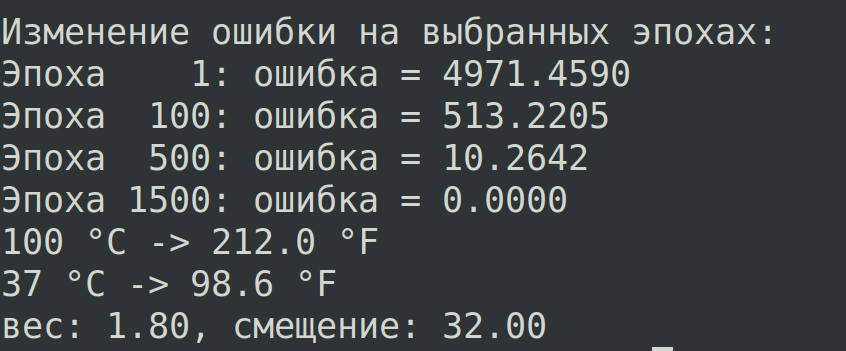
Ошибка здесь — это значение функции потерь, то есть мера расхождения между ответами модели и правильными ответами. Когда это значение уменьшается, ответы модели приближаются к правильным. Нулевая ошибка на 1 500-й эпохе означает, что на всех девяти примерах ответ модели совпал с формулой. Именно этого и нужно добиться от обучения, поэтому уменьшение ошибки считается признаком того, что модель учится.
Что попробовать дальше
Изменить скорость обучения. Параметр learning_rate задает размер шага оптимизатора, то есть на сколько изменяется каждый параметр модели за один шаг обучения. Его значение подбирают под задачу, поэтому полезно изменить его и сравнить результаты. Замените 0,1 на 0,01 в строке с compile и запустите программу снова. В нашем запуске за те же 1 500 эпох модель не успела сойтись: ошибка осталась равной 381, вес стал 1,99, смещение 11,7. Шаг в десять раз меньше, поэтому до значения 32 смещение за 1 500 шагов не дошло.
Если попробовать изменить значение learning_rate на 0,5 или даже на 1,0, то обучение на 1 500 эпохах закончится так же успешно (попробуйте проверить это в нашем коде). Отметим, что для задачи с одним нейроном большие значения learning_rate допускаются. Однако в сложных сетях такие параметры могут привести к некорректной работе функции потерь и обучение будет расходиться.
Чем может помочь Selectel
Если вы занимаетесь задачами, связанными с машинным обучением, вам будет полезен DAVM — готовый облачный сервер с предустановленными и настроенными инструментами. Он подходит для разработки и обучения ML-моделей, тестирования LLM, создания небольшой платформы обработки данных и BI-аналитики. Среди доступных и готовых к работе инструментов — популярные фреймворки и библиотеки, включая Keras, TensorFlow, HuggingFace, OpenCV, PyTorch, Pandas и другие.
Образ DAVM разворачивается за несколько минут из панели управления. Мы уже настроили авторизацию через Keycloak, установили CUDA Toolkit для работы с GPU и привязали домен, с помощью которого вы сможете подключаться к инструментам через интернет.
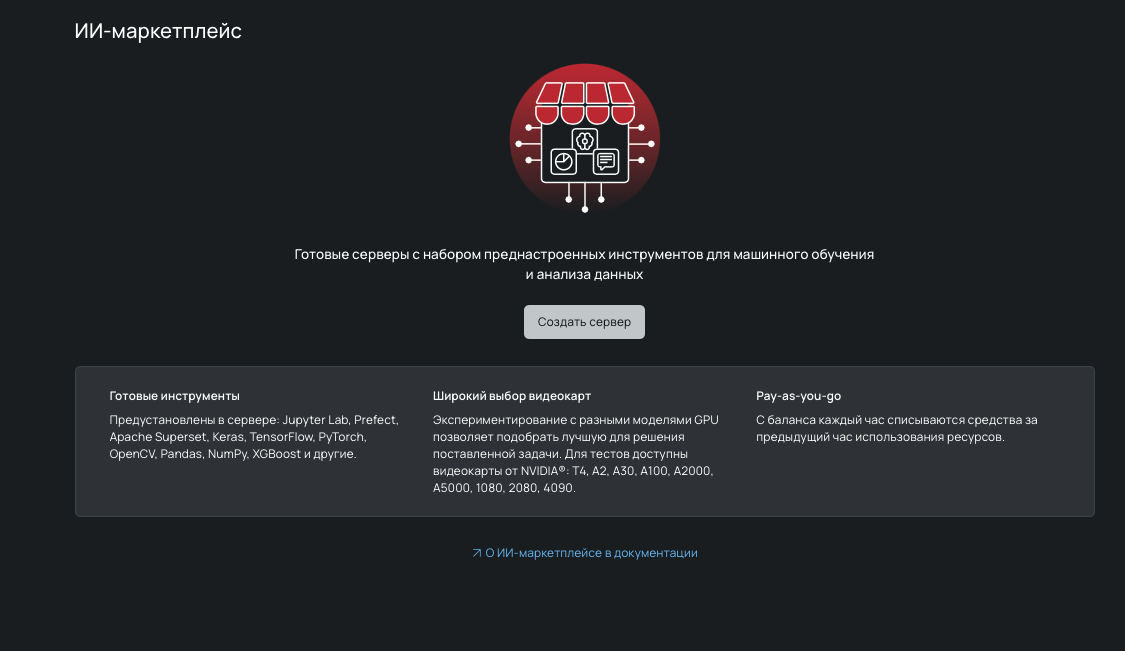
Внутри панели нажимаем Продукты, во вкладке ИИ-платформа, находим и нажимаем на ИИ-маркетплейс.
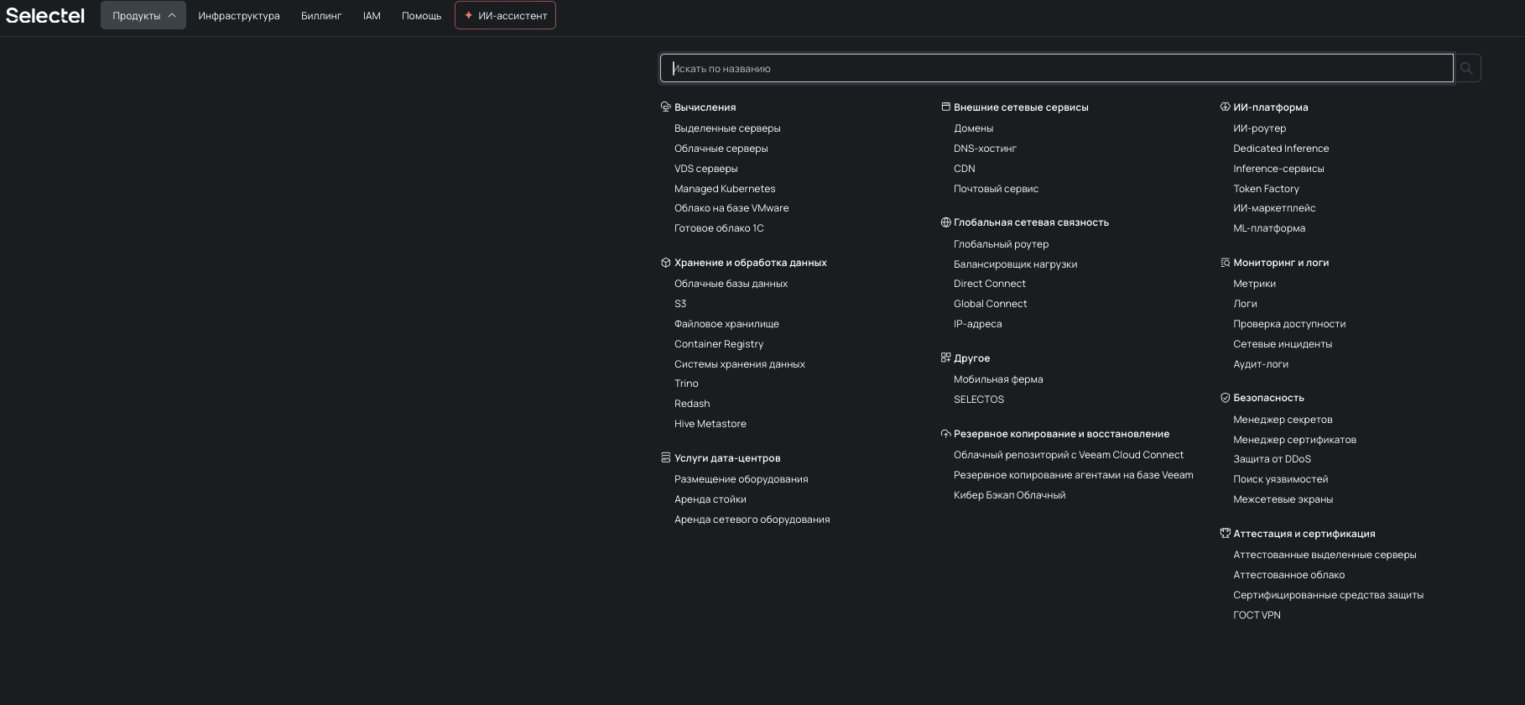
Открывается страница ИИ-маркетплейса, на которой нужно нажать Создать сервер.
Вам остается выбрать готовую конфигурацию DAVM или собрать свою.
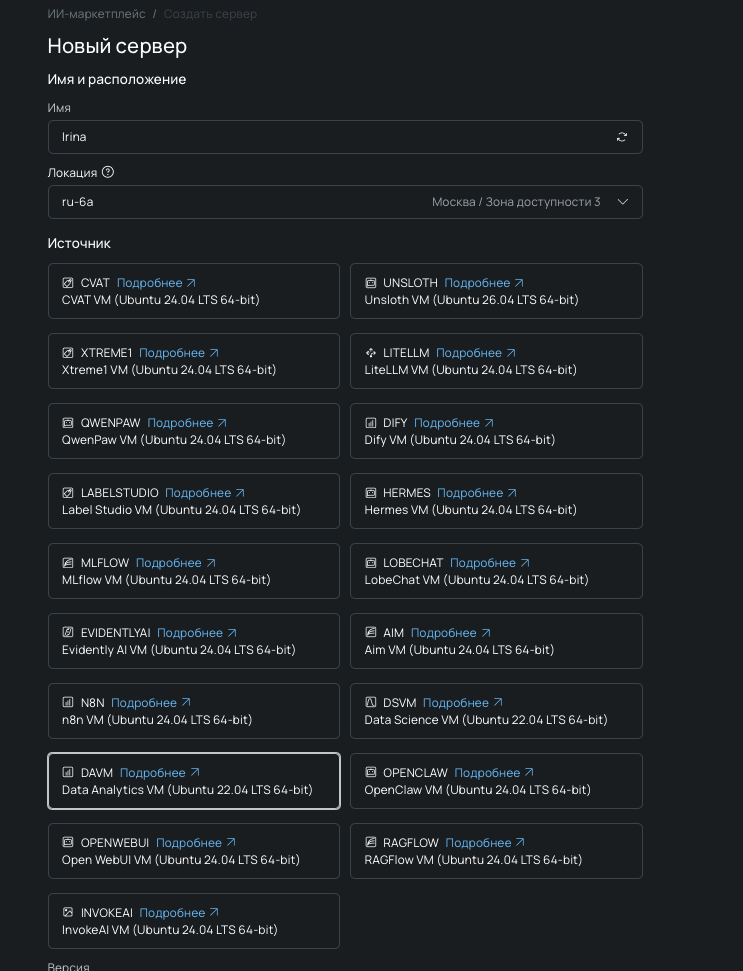
Выбирайте любую конфигурацию облачного сервера с RAM от 4 ГБ и объемом загрузочного диска от 100 ГБ. Если ваша задача — обучение ML-моделей, рекомендуем использовать конфигурации линейки GPU Line.