Статьи будут раскрывать основополагающие идеи ML. Я предпочитаю интуитивное объяснение алгоритмов и методов формальной постановке задач и их решению, не умаляя важности последних.
Но начнем с главного — со скелета. Разберем, как работает машинное обучение, из каких этапов состоит любой алгоритм и какие задачи вообще существуют. Для понимания материала достаточно базовых знаний математики, статистики и умения работать с данными. Код на Python: pandas и numpy для данных, а в конце покажем тот же алгоритм четырьмя строками на scikit-learn. Дальше в примерах используются две таблицы: архив из 1 000 прошлых студентов с признаками и меткой «Списал?» и список новых студентов, для которых мы будем предсказывать эту метку. Код и таблицы ниже показывают ход решения именно под эти данные, повторять их один в один необязательно.
Задача
Представьте: вы принимаете экзамен у полусотни лбов, и выявить списывающих не так-то просто без должного опыта. Среди сдавших экзамен оказываются и те, кто раз за разом проваливал семинарские работы и нередко пропускал пары. Раз вам не удалось поймать их за руку в аудитории, вы определите обман на основе данных! В деканате имеется архив учебных журналов с оценками, посещаемостью и результатами экзамена. В них отдельно отмечены те, кто сдал экзамен, но был уличен в списывании.
Архивные данные о тысяче студентов выглядят так:
№ | Пропуски (часы) | Средняя оценка за семинар | Списал? |
| 0 | 37 | 28,5 | Да |
| 1 | 44 | 21,1 | Да |
| 2 | 91 | 8,2 | Да |
| 3 | 28 | 100,0 | Нет |
| 4 | 45 | 76,2 | Нет |
| … | … | … | … |
| 995 | 65 | 6,2 | Да |
| 996 | 46 | 61,1 | Нет |
| 997 | 75 | 41,4 | Да |
| 998 | 43 | 64,9 | Нет |
| 999 | 54 | 94,1 | Нет |
Их можно представить в виде матрицы признаков X и вектора целевых меток Y (размером 1 000×1). Матрица признаков X состоит из 1 000 строк и двух столбцов. Каждая строка описывает одного студента через два признака: суммарное время пропущенных пар в часах (первый столбец) и среднюю оценку за семинар (второй столбец). Вектором целевых меток Y назовем столбец из значений «Да», если студент списал, и «Нет», если не списывал. Само значение «Да» или «Нет» называется меткой.
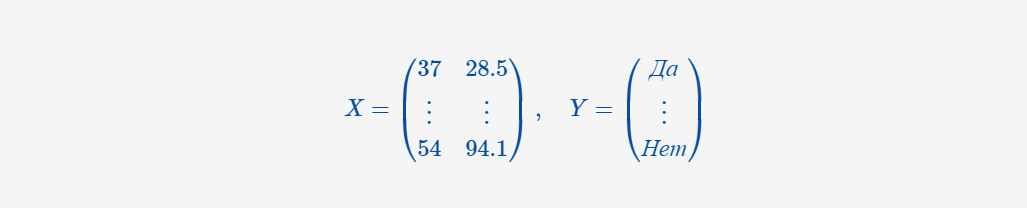
      import pandas as pd
import numpy as np
from math import sqrt

df = pd.read_excel(r'C:\Users\Data\Aрхив.xlsx')
# Конвертируем “Да” в 1, “Нет” в 0
def f(x):
  if x['Списал?'] == 'Да':
    x['Списал?'] = 1
    return x['Списал?']
  else:
    x['Списал?'] = 0
    return x['Списал?']

df['Списал?'] = df.apply(f, axis=1)
X = df.drop(columns = 'Списал?').values
Y = df['Списал?']
Данные по студентам, у которых вы сегодня приняли экзамен, состоят только из матрицы признаков и не имеют соответствующих им меток («Да» / «Нет»), так как вы не знаете, кто списал, а кто нет. Такие данные называются неразмеченными.
№ | Пропуски (часы) | Средняя оценка за семинар | Списал? |
| 0 | 15 | 42,5 | |
| … | … | … | … |
| 49 | 100 | 45,7 |
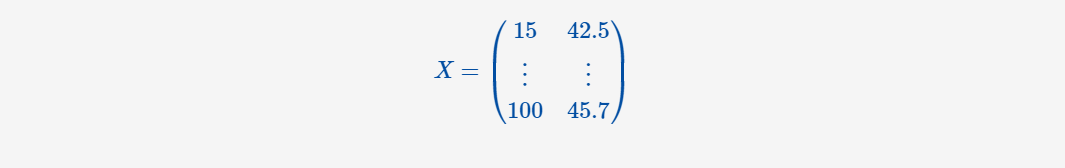
Итак, нужно написать программу, которая запомнит архивные данные и на основе двух признаков определит, списал студент или нет:
- признак 1 — пропуски занятий в часах (от 0 до 100);
- признак 2 —средняя оценка за семинар (от 0 до 100).
Программа будет решать задачу классификации — она определяет каждый объект (каждого сдавшего экзамен студента) к классу 1 (списал) или 0 (не списал).
Идея для решения
Давайте визуализируем данные архива на плоскости, где по оси Х будут пропуски, а по оси Y — средняя оценка за семинар. Точки красного цвета будут соответствовать списавшим студентам, зеленого цвета — честным студентам.
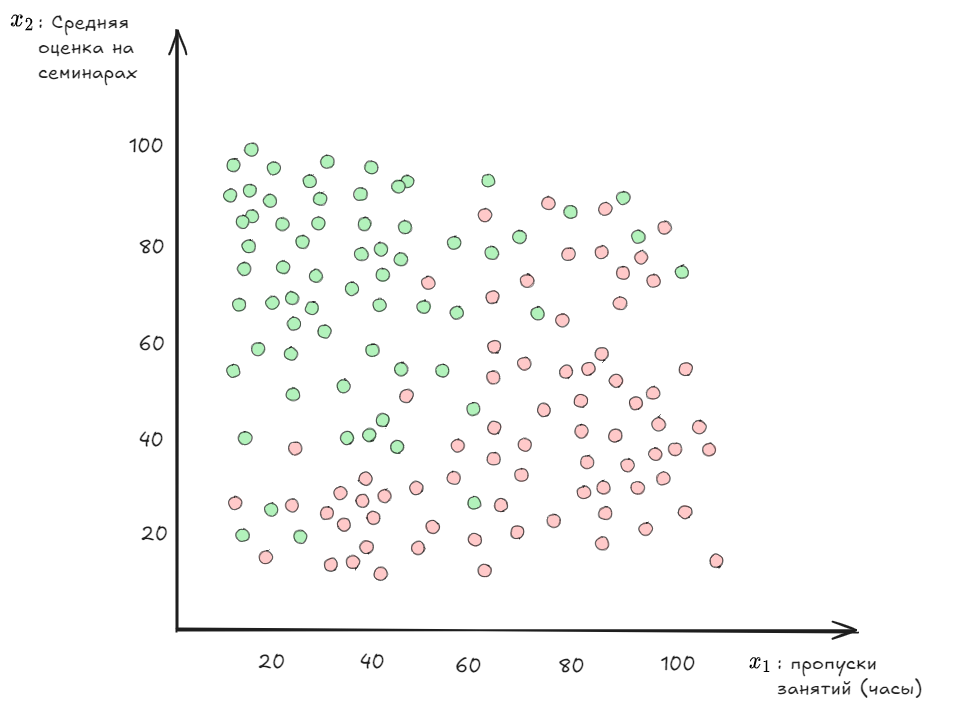
Несложно заметить, что красная точка будет скорее в окружении красных точек, нежели зеленых. Исключения допускаются, но они редки. Действительно, если двое студентов учились схоже и оба сдали экзамен, то, скорее всего, они либо оба списали, либо оба сдали честно… На основе этого наблюдения сформулируем алгоритм, по которому программа будет определять значение меток y (списал ли студент) для неразмеченных данных:
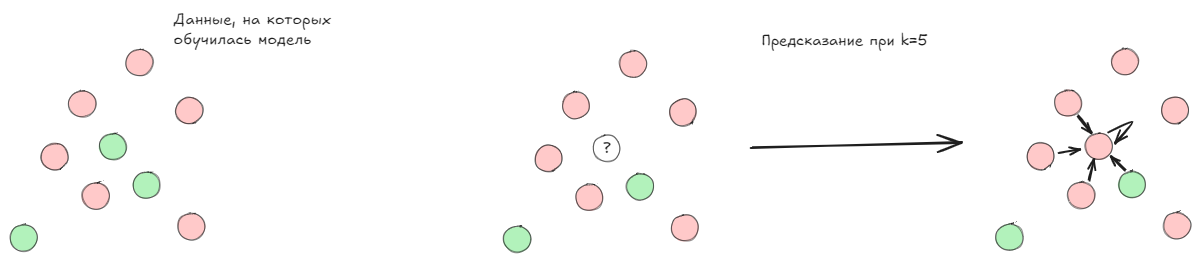
Студент, сдавший экзамен, считается списавшим, если среди ближайших к нему k наблюдений большинство списывали.
Пример: возьмем k=5 и выясним списал ли студент, прогулявший 60 часов и имеющий среднюю оценку 80 за семинары.
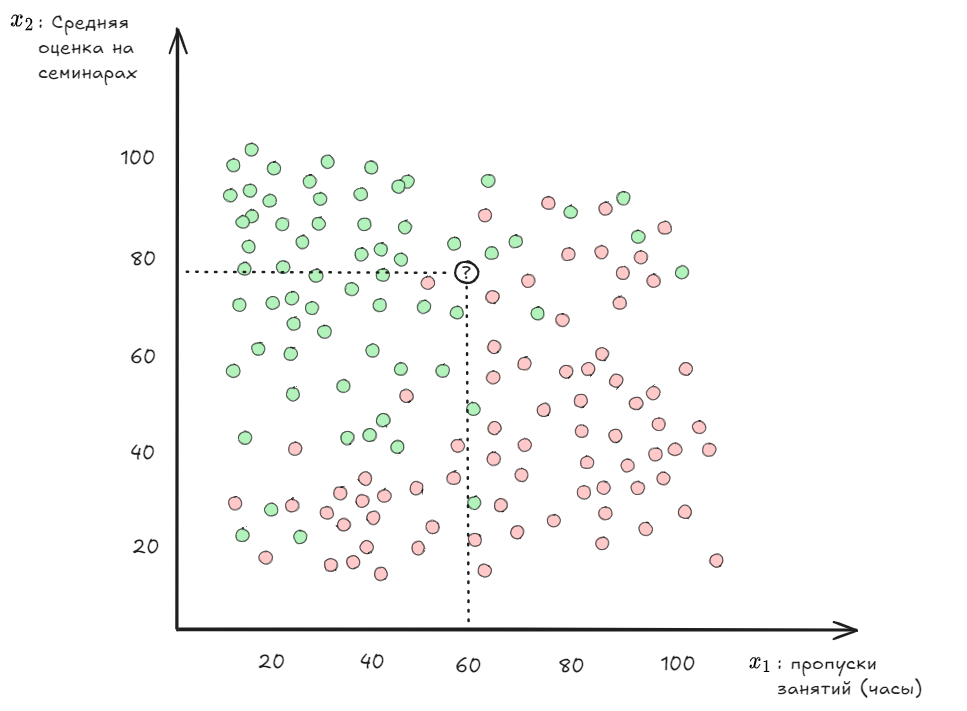
Методом зоркого глаза находим пять ближайших соседей: двое студентов списали, а трое честно сдали экзамен. Значит, зачислим данного студента в ряды честных.
Наш алгоритм называется KNN — k ближайших соседей. В случае KNN обучение сводится в основном к запоминанию объектов и их меток. Это самый простой пример обучения. Для других алгоритмов обучение может выглядеть сложнее — например, модель может подбирать параметры.
Число ближайших соседей k, по которому мы определяем метки, называется гиперпараметром: это значение, которое мы задаем заранее, до обучения. Разницу между параметром и гиперпараметром узнаем в следующей статье. Отдельно заметим: расстояние считается сразу по двум признакам, поэтому важен их масштаб. Здесь оба признака лежат в диапазоне от 0 до 100 и влияют одинаково. Если бы пропуски измерялись в минутах (до 6 000), они заглушили бы оценку за семинар, и признаки пришлось бы приводить к одному масштабу.
Рассмотрим реализацию алгоритма:
# Функция расстояния между двумя точками

def distance_between_point(a, b):
    return sqrt(sum((a - b) ** 2))
def predict_point(X, Y, k, new_data):
    dist_and_label = []
    for i in range(len(X)):
        distance = distance_between_point(new_data, X[i])
        dist_and_label.append((distance, Y[i]))
    dist_and_label.sort()
    nearest = dist_and_label[:k]
    nearest_label = [label for dist, label in nearest]

# При равенстве голосов среднее равно 0,5, а np.round(0,5) дает 0 — это  «Нет»
    result = np.round(np.mean(nearest_label))
    return result
if predict_point(X, Y, 5, np.array([60, 80])) == 1:
    print('Да')
else:
    print('Heт')
Насколько хорошо будет работать наша программа? Сравним метки архивных данных и предсказания нашей модели на этих же данных! Иначе говоря, программа будет брать каждого студента из архива и определять, списал ли он на основе этого же архива. А значит, из k ближайших наблюдений каждого студента наиболее близким будет он сам, и если k>1, то модель, вероятно, будет совершать ошибки.
Факт того, что модель запомнила данные, не означает правильное предсказание на основе этих же данных. Ниже представлен пример ошибки модели. Ошибка случается в части данных, которую мы называли исключением: зеленая метка оказалась в окружении красных.
Мы протестировали нашу модель при k=5 и сравнили метки: наша модель ошиблась 83 раза. Это всего 8,3% от наших данных.
def predict_point(X, Y, k, new_data):
    dist_and_label = []
    for i in range(len(X)):
        distance = distance_between_point(new_data, X[i])
        dist_and_label.append((distance, Y[i]))
    dist_and_label.sort()
    nearest = dist_and_label[:k]
    nearest_label = [label for dist, label in nearest]
    result = np.round(np.mean(nearest_label))
    return result
def predict_Y(X, Y, k):
    predict = []
    for student in X:
        predict.append(predict_point(X, Y, k, student))
    return predict
Y_predict = predict_Y(X, Y, 5)
print(sum(Y_predict != Y))
Мы только что посчитали функцию потерь, или loss, — функцию, количественно оценивающую ошибку предсказаний нашей программы. Наша функция потерь будет считать долю ошибок среди всех предсказаний.
Получается, чем меньше loss, тем лучше модель описывает данные. Давайте протестируем модель с другим k. Возьмем k=8 и получаем loss=0,079. Таким образом, loss позволяет нам не только количественно оценить модель, но и сравнивать разные модели и их настройки.
Переобучение
Конечно, мы хотим, чтобы loss был как можно меньше и потому будем искать такое значение ближайших соседей, при котором оно становится минимальным. Перебрав пару значений k, мы натыкаемся на k=1: тут loss становится равным нулю!
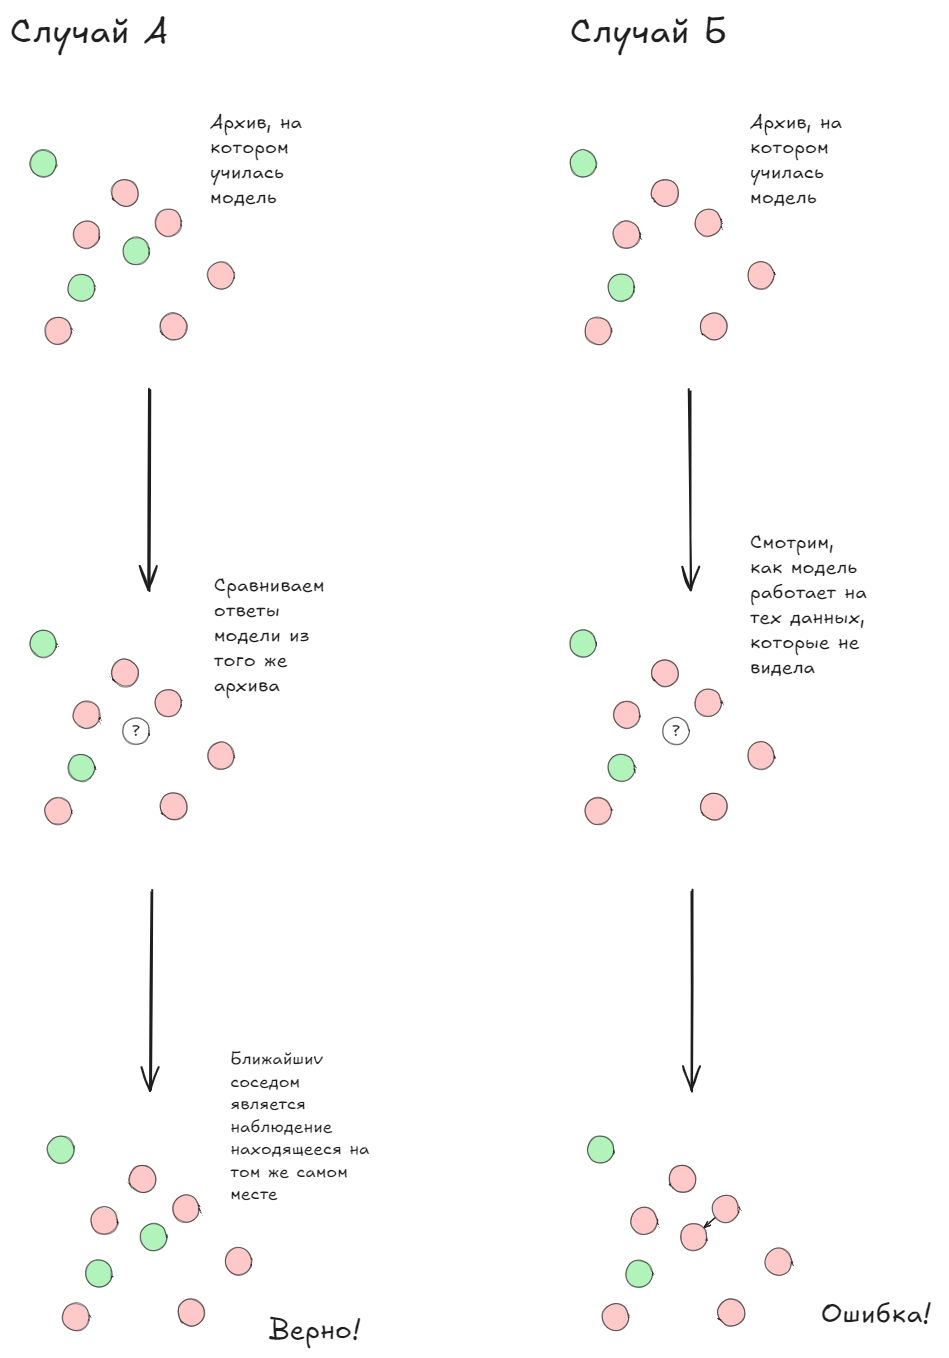
При k=1 ближайшим соседом каждого объекта оказывается он сам, поэтому на обучающей выборке loss равен нулю, то есть модель не ошибается. Давайте сравним две ситуации — в первой (случай А) модель предсказывает класс объекта из выборки, на которой училась, во второй (случай Б) модель предсказывает класс объекта, не входившего в состав выборки, но истинную метку которого мы знали (допустим, нашли еще данные прошлых лет).
Мы приходим к выводу, что функция потерь, рассчитанная на обучающих данных, может некорректно отражать поведение модели на данных, которые она не видела. Получается довольно странная ситуация: мы спрашиваем модель, хорошо ли она работает на данных, которые уже ей показали. Придется пойти на хитрость: часть архива не покажем и сверим предсказание модели для этой части с реальными метками.
Случай с k=1 называется переобучением (overfit): модель слишком хорошо подстроилась под обучающие данные, но плохо работает на новых данных, иначе говоря, Loss на обучающей выборке сильно меньше, чем Loss на валидационной. Таким образом, само по себе стремление функции ошибки на обучающих данных к нулю не обеспечивает обучение и может привести к заучиванию данных.
Делим данные
Давайте разделим ваши архивные данные на три части: обучающую (Train), валидационную (Validation) и тестовую (Test). На первой модель обучается, на второй будем рассчитывать loss, оценивающий работу модели на новых данных, а третью отложим в сторону и на время забудем. Можно сказать, что с помощью валидационной выборки мы симулируем ситуацию с неразмеченными данными и потому можем более объективно оценить эффективность модели.
Разделим размеченные данные случайным образом в следующей пропорции:
- 80% данных на обучение,
- 10% на валидацию,
- 10% на тест.
# Перемешиваем данные
df = df.sample(frac=1, random_state=42)
X = df.drop(columns = 'Списал?').values
Y = df['Списал?']
X_train, X_valid, X_test = np.split(X, [int(0.8*len(X)), int(0.9*len(X))])
Y_train, Y_valid, Y_test = np.split(Y, [int(0.8*len(Y)), int(0.9*len(Y))])
Теперь мы обучаем модель на 800 студентах и рассчитываем оценку модели на 100 студентах. Давайте посчитаем loss для каждого значения гиперпараметра от одного до девяти.
def predict_Y(X_valid, k, X_train, Y_train):
    predict = []
    for student in X_valid:
        predict.append(predict_point(X_train, Y_train, k, student))
    return predict
for i in range(9):
    Y_predict = predict_Y(X_valid, i+1, X_train, Y_train)
    print(i+1, sum(Y_predict != Y_valid))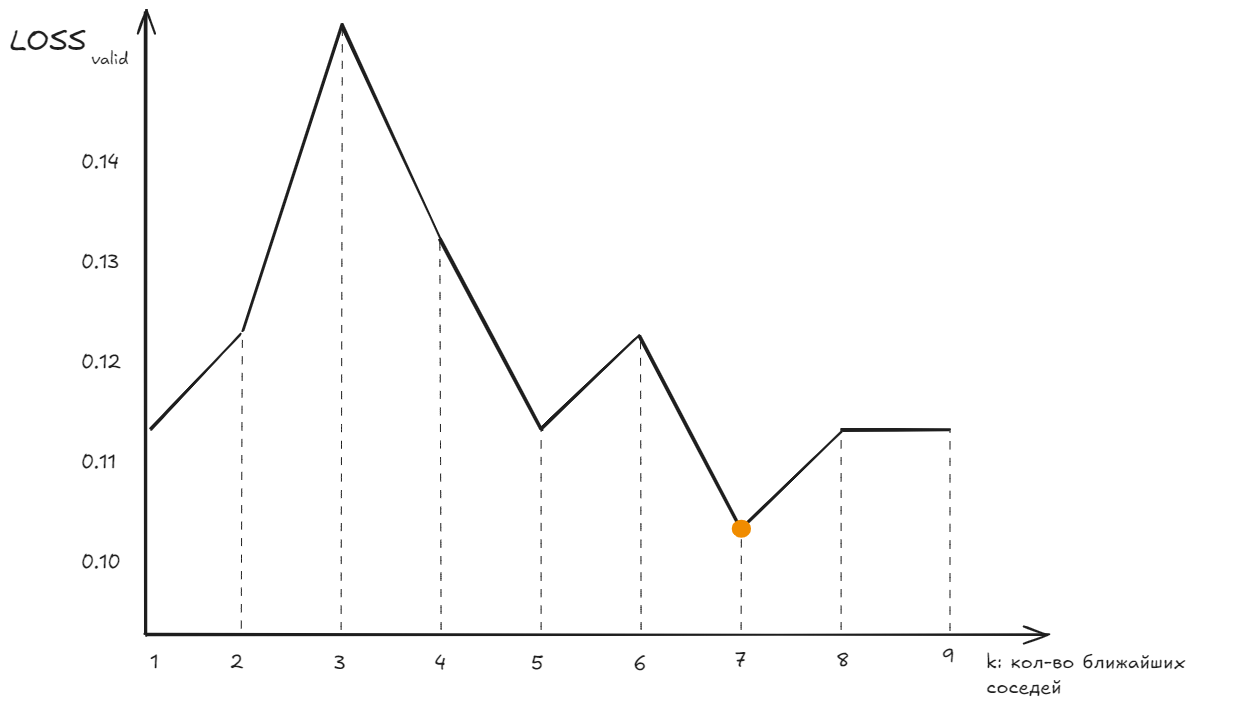
Перебором вы выяснили, что оптимальным является k=7. Именно при семи ближайших соседях модель допускает минимальное число ошибок на валидационной выборке Loss_{validation}=0,1, то есть модель ошибается в 10% случаев. Однако на 100 студентах одна ошибка весит целый процентный пункт, поэтому разница между k=6, 7 и 8 легко может быть шумом. Выбор k=7 разумен, но не единственно возможный.
Действительно ли функция потерь, рассчитанная на валидационной выборке Loss_{validation}, говорит о том, как хорошо модель будет работать на неразмеченных данных? Хоть валидационная часть выборки не была скормлена машине, но мы ее использовали раз за разом, подгоняя гиперпараметр k. Таким образом, мы получили не совсем честную оценку.
Поэтому нам и необходима тестовая часть выборки: она используется единожды в самом конце для получения максимально честной оценки эффективности модели.
Y_predict = predict_Y(X_test, 7, X_train, Y_train)
print(sum(Y_predict != Y_test))
Посчитав долю ошибок на тесте, получаем, что модель ошибается в 9% случаев — это и будет нашей итоговой оценкой качества. Это близко к 10% на валидации, а значит, подбор k не подогнал модель под валидационные данные. Но и 9% приблизительны: на 100 объектах погрешность составляет несколько процентных пунктов. Для масштаба можно посчитать ошибку «глупой» модели, которая всегда отвечает самым частым классом: min(Y.mean(), 1 – Y.mean()). Наши 9% должны быть заметно лучше.
Схема нашего ML-проекта
Теперь, когда алгоритм настроен, вы запускаете его на неразмеченных данных своих студентов. Перед вами оказывается список фамилий.
New_Data = pd.read_excel(r'C:\Users\Data\Новые_студенты.xlsx')
New_Data['Списал?'] = predict_Y(New_Data.drop(columns = 'Списал?').values, 7, X_train, Y_train)
С этим списком вы направляетесь в деканат — начинается повторная аттестация.
Важная оговорка: модель не доказывает списывание, а лишь подсказывает, кого стоит перепроверить. При ошибке около 9% примерно каждый десятый вердикт неверен, поэтому решение остается за человеком, а повторная аттестация не должна быть наказанием. Кроме того, доля ошибок не различает ложное обвинение и пропущенного списавшего. О других метриках поговорим в следующих статьях.
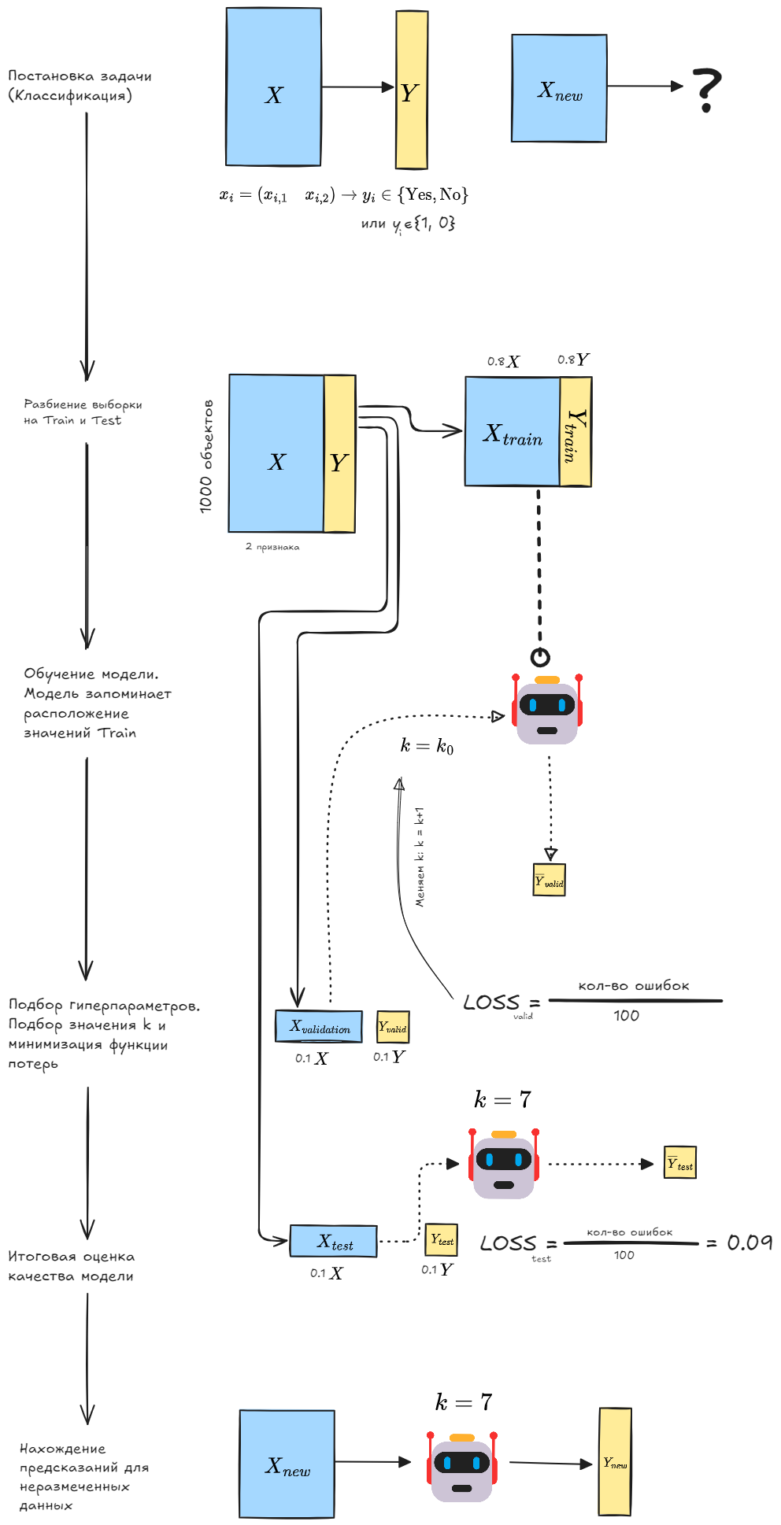
Итак, подытожим наши шаги:
- поставили задачу и выбрали алгоритм обучения и предсказания (KNN);
- выбрали функцию потерь;
- разбили выборку на Train, Validation, Test;
- скормили Train программе — она запомнила данные;
- рассчитывали Loss_{valid} для каждого значения k от одного до девяти. Нашли k=7, при котором модель допускает наименьшее количество ошибок;
- оценили качество модели на Test;
- применили модель и получили метки для ваших студентов.
Ту же модель можно собрать в четыре строки с помощью scikit-learn:
from sklearn.neighbors import KNeighborsClassifier model = KNeighborsClassifier(n_neighbors=7) model.fit(X_train, Y_train) print((model.predict(X_test) != Y_test).mean()) Цифра может слегка отличаться от нашей: при равных расстояниях библиотека выбирает соседей иначе.
Какие бывают задачи ML
Только что вы смоделировали небольшой ML-проект, решая задачу классификации. Но какие еще существуют задачи? Большую часть задач классического машинного обучения можно разделить на несколько основных типов. Разница между ними определяется тем, что именно мы хотим получить на выходе модели или в результате предсказания.
Если нужно определить, к какому классу относится объект, перед нами классификация. Если предсказать число — регрессия. Если расставить объекты в нужном порядке — ранжирование. Если найти группы похожих объектов без заранее известных ответов — кластеризация. А если данных слишком много и хочется представить их в более компактном виде — можно использовать снижение размерности. Каждая из перечисленных задач будет раскрыта в последующих статьях.