Итак, вы отправляете запрос через сайт или приложение. В этот момент начинается его путь к подробному и, возможно, корректному ответу. По дороге запрос проходит через несколько систем, причем каждая выполняет свою задачу. Давайте разберем этот процесс.
Всем привет! С вами Сергей Ковалёв, менеджер продукта Выделенные серверы в Selectel. Сегодня расскажу, как устроена серверная инфраструктура ИИ-сервисов, с которыми каждый день работают менеджеры, поддержка, продавцы и специалисты сотен других профессий. Разберемся, почему качественный ИИ-сервис — это не только LLM, агент и GPU с большим объемом RAM, но и балансировщик, API, nginx, NVLink и другие компоненты.
Ворота в ИИ-сервис
Вы пишете текст в окне запросов и нажимаете Enter — запускается серия проверок. Прежде чем ваш запрос доберется до нейросети, он проходит через несколько «ворот».
Первая точка входа называется API Gateway. Он читает служебные заголовки вашего запроса: кто вы, какой у вас токен авторизации, откуда пришел запрос. Gateway за доли секунды проверяет, действителен ли ключ авторизации, не превышен ли лимит, не заблокирован ли аккаунт и какую модель вы запросили. Если все в порядке, запрос идет дальше. Если нет — Gateway отвечает сам, и до модели дело не доходит. Gateway здесь выполняет функцию фильтра и контроллера.
Такой фильтр важен по экономическим причинам. Один запрос к нейросети задействует сотни дорогих GPU-операций, а Gateway отсекает «некорректные» запросы еще на входе, не тратя на них вычислительные ресурсы.
Дальше запрос нужно направить к нужной модели. У OpenAI и Anthropic их несколько, и на этом этапе Gateway определяет, какая нужна вам: та, что вы выбрали сами, или та, которую подберет режим «Авто». Затем балансировщик нагрузки выбирает наименее загруженную группу серверов с этой моделью и отправляет запрос туда. Балансировщик нагрузки распределяет миллионы одновременных запросов так, чтобы ни один сервер не был перегружен.
С языковыми моделями дело обстоит сложнее, чем с обычными сайтами: один запрос к модели занимает полсекунды, другой — полминуты, ведь все зависит от длины ответа. Поэтому балансировщик считает активные генерации в модели и длину очереди на каждой группе серверов. Число открытых соединений о реальной загрузке почти ничего не говорит.
Жизнь модели делится на два этапа. Сначала ее обучают: показывают огромные объемы текста и подбирают параметры. Это занимает месяцы, на это тратят огромные ресурсы. Потом модель начинает отвечать пользователям — это и есть инференс.
Третий компонент — Rate limiter. Он следит за тем, чтобы один пользователь не забрал себе слишком много ресурсов (или даже все). Счетчик нельзя держать на каком-то одном сервере, иначе его будет легко обойти, отправляя запросы на разные машины. Поэтому он хранится в отдельном общем хранилище в оперативной памяти, к которому обращаются все серверы. Типичный инструмент для этого — Redis.
Лимиты считают и в запросах, и в токенах. У Anthropic, например, три счетчика: запросы в минуту, входные токены в минуту и выходные токены в минуту. Токены точнее отражают нагрузку, потому что длинный запрос обходится сервису дороже короткого. Когда лимит превышен, сервер отвечает кодом 429 и сообщает, что через сколько секунд можно попробовать снова.
Технически все три компонента (API Gateway, балансировщик и Rate Limiter) работают на привычных инструментах вроде NGINX и Envoy или на собственных разработках компаний. Envoy, например, используется в инфраструктуре OpenAI. GPU на этом этапе еще не нужны: хватает обычных x86-серверов (вроде Dell, HPE или Supermicro). Подобные серверы для балансировки нагрузок и фильтрации трафика можно арендовать и в Selectel: разница с гигантами только в количестве машин, при этом вся проверка занимает миллисекунды. Как пример — сервер с 16 ядрами на актуальном процессоре AMD EPYC 9135 и памятью DDR5 ECC Reg.
Этот этап важен и для конечного пользователя: чем меньше ресурсов тратит сервис, тем ниже итоговая цена продукта.
Контекст и память
Балансировщик отправил сообщение на доступный сервер. Однако нейросеть сама по себе не помнит предыдущих сообщений. Чтобы чат работал как чат, есть отдельная система управления контекстом. Она хранит историю вашего разговора и с каждым новым сообщением отправляет модели весь диалог с самого начала. Модель видит переписку целиком и отвечает с учетом всего сказанного.
Контекстное окно («рабочая память» модели) — максимальный объем информации, который она держит в поле зрения одновременно. Туда входят ваши сообщения, ответы модели, загруженные файлы и инструкции. Измеряется в токенах. Токен — это «кусочек» слова, обычно несколько символов.
Отсюда следует ограничение: чем длиннее разговор, тем больше токенов нужно обработать на каждом шаге. Каждый следующий ответ становится дороже и медленнее.
Саму переписку сервисы хранят в обычных постоянных базах данных, а поверх организуют кэши в оперативной памяти, чтобы быстро доставать данные. Например, OpenAI подробно описала свою платформу хранения Habitat. Цифры такие: больше 70 миллионов запросов в секунду, больше миллиарда пользователей в неделю, почти 40 регионов и более 500 ПБ данных. Запросов к хранилищу намного больше, чем сообщений в чатах: одно действие пользователя превращается в сотни обращений к базе. С помощью контекста пользователь может получать ответы на свои вопросы быстрее.
Нейросеть
Здесь запрос, миновав Gateway, балансировщик и контекстное окно, наконец попадает в модель. Теперь начинается самое интересное.
Модель можно представить как огромную математическую формулу с миллиардами настраиваемых коэффициентов (у самых больших моделей их порядка триллиона). Эти числа называют параметрами. Их подобрали во время обучения так, чтобы на входящий текст формула выдавала осмысленное продолжение, то есть ответ. «Под капотом» перемножаются таблицы чисел (матрицы), и это повторяется миллиарды раз.
Последовательность такая:
- текст делится на токены, и каждому присваивается номер. Слово «нейросеть» может разделиться, например, на «нейро» и «сеть»;
- каждый токен превращается в набор чисел, описывающий его смысл. Такой набор называют вектором. У слов с близким смыслом векторы похожи: «король» и «королева» окажутся рядом, а «автомобиль» далеко от них;
- еще нужно учесть порядок слов: модель обрабатывает все токены одновременно и сама не знает, какой из них первый, а какой последний. Поэтому к каждому добавляется числовая метка с его местом в тексте. Это называется позиционным кодированием;
- включается механизм внимания. Он помогает понять, какие слова связаны друг с другом. Во фразе «он взял ключи и открыл ими замок» модель определяет, что «ими» относится к ключам. Смотрит она на текст сразу несколькими «взглядами», их называют головами внимания: одна может следить за грамматикой, другая — за смысловыми связями;
- результат проходит дополнительную обработку, и весь цикл повторяется слой за слоем. В конце модель выбирает следующий токен ответа.
Потом такой процесс повторяется для следующего токена. Ответ собирается по кусочку, поэтому в чате текст появляется постепенно.
Трансформер — это архитектура нейросети, в основе которой лежит механизм внимания (attention). Он позволяет модели при обработке каждого слова «смотреть» на все остальные слова в тексте сразу и определять, какие из них важнее для понимания смысла.
Все эти вычисления выполняет GPU — графический процессор. Один GPU состоит из тысяч небольших вычислительных блоков, работающих одновременно. Одну сложную задачу он не решает быстрее обычного процессора CPU, зато миллиарды простых операций выполняет параллельно и весьма эффективно. Перемножение больших таблиц чисел как раз раскладывается на множество простых действий — это и нужно нейросети.
GPU устанавливают в серверы, а серверы собирают в дата-центры. Чтобы отвечать на миллионы запросов от пользователей одновременно, нужны тысячи таких машин. Эффективность работы связки модели и GPU также влияет на скорость работы сервиса и стоимость его услуг.
Про железо или как устроено хранение модели
Во время инференса (ответа на запросы клиента) параметры модели лежат в памяти графических процессоров. Модель на триллион параметров занимает от 0,5 до 2 ТБ видеопамяти. Разброс зависит от формата хранения параметров («весов») модели и степени их сжатия (квантования). Для сравнения: оперативная память домашнего ПК обычно не превышает 128 ГБ, а смартфона — 12 ГБ.
Столько же терабайт помещается в один сервер топового уровня? Обычно в устройствах такого класса установлено восемь GPU. Например, у сервера на базе NVIDIA B300 каждый чип несет на борту по 288 ГБ памяти, что суммарно дает около 2,3 ТБ. По рыночным оценкам, такой сервер стоит до 100 млн рублей на сегодняшний день, а его пиковое энергопотребление достигает 18 кВт.
Следующая ступень железа — это стойка, скомпонованная как один большой компьютер. В NVIDIA GB300 NVL72 стоят 72 GPU и 36 центральных процессоров: видеопамяти в ней около 20 ТБ, а потребление — примерно 140 кВт. Стоимость такой стойки примерно в 10 раз выше, чем у одного сервера B300.
Внутри систем уровня NVL72 чипы связаны шиной NVLink с пропускной способностью до 130 ТБ/с. Стойки между собой соединяет отдельная сеть: InfiniBand (800 Гбит/с на каждый GPU). Обычная серверная сеть для такого слишком медленная: когда модель «разложена» по нескольким GPU, чипы обмениваются промежуточными результатами на каждом шаге вычислений.
Видеопамять, которая осталась после загрузки модели, тоже не пустует — в ней хранятся промежуточные вычисления (или KV-кэш) для всех диалогов, которые эта копия модели обрабатывает параллельно. Разумеется, одной копии модели на всех пользователей не хватит. Чтобы отвечать миллионам людей, модель загружают во множество таких серверов и стоек, и каждая копия работает независимо от остальных. Балансировщик из первого слоя как раз и выбирает, какой копии отдать ваш запрос.
Как уже говорили выше, серверы размещают в дата-центрах. Это большое промышленное здание с рядами стоек, километрами кабелей, промышленными установками для охлаждения, источниками бесперебойного питания, резервными дизельными генераторами и системами пожаротушения. Отдельно стоит отметить охлаждение серверов в дата-центрах. Серверы с GPU выделяют огромное количество тепла, для отвода которого используют системы жидкостного охлаждения и даже иммерсивные схемы, в которых сервер полностью погружается в специальную жидкость.
Вернемся к инференсу и обучению моделей — это разные задачи, поэтому ИТ-инфраструктуру под них тоже проектируют по-разному. Для обучения нужно много серверов, тесно связанных в одном кластере. Инференс можно организовать на большом числе «одиноких» серверов с GPU.
Особенности процесса обучения модели:
- одна модель, которая занимает все чипы на недели и месяцы;
- важна суммарная мощность железа и связь между чипами;
- при сбое узла задача останавливается и перезапускается с сохраненной точки;
- ровная круглосуточная нагрузка.
А специфика инференса заключается в следующем:
- миллионы коротких независимых запросов;
- важна скорость ответа и цена одного токена;
- при сбое запросы уходят на соседние копии модели;
- нагрузка с суточными пиками, применяются лимиты.
Затраты на железо под подобные задачи впечатляют. В 2025 году OpenAI рассказали про кластер GB300, в котором содержится 64 стойки NVIDIA GB300 NVL72 (или более 4 600 GPU). В пересчете на рубли — миллиарды.
В мае 2026 года Anthropic арендовала у SpaceX весь дата-центр Colossus 1 с более чем 220 тысячами GPU NVIDIA (модель не уточнялась).
Четкой границы между железом для обучения и инференса пока что нет: GPU могут использоваться унифицировано. Однако производители заявляют о новых планах с разделением таких устройств по назначению.
Кэширование и оптимизации
Становится понятно, что нейросеть — дорогое удовольствие. Поэтому инженеры придумали способы не делать лишней работы.
Например, KV-кэш. Когда модель пишет ответ токен за токеном, ей каждый раз нужно учитывать весь предыдущий текст. Для каждого токена механизм внимания считает две служебные таблицы чисел — ключи и значения (key и value). Чтобы не вычислять их заново на каждом шаге, модель хранит уже посчитанные в памяти GPU и добавляет только новые. Плата за скорость здесь память: чем длиннее диалог, тем больше кэш. Это одна из причин, по которым у контекстного окна есть предел, а длинный контекст стоит дороже.
KV-кэш — хранилище промежуточных результатов механизма внимания (ключей и значений) для уже обработанных токенов. Благодаря ему при генерации каждого нового токена модель считает внимание только для него, а для остального текста берет готовые данные из кэша. Это резко ускоряет генерацию, но кэш растет вместе с длиной диалога и занимает память GPU, поэтому длинный контекст стоит дорого.
KV-кэш работает как оперативная память для контекста, избавляя модель от необходимости перечитывать весь текст заново. Побочный эффект: чем длиннее диалог, тем больше памяти занимает кэш. Отчасти поэтому у контекстного окна есть предел.
Еще один способ экономии ресурсов называется батчинг. При батчинге запросы от разных пользователей объединяются в группы и обрабатываются вместе. GPU эффективнее работает с большими объемами данных вместе, чем с маленькими поодиночке.
Батчинг — объединение запросов от разных пользователей в одну пачку (batch), которая проходит через модель за один проход. Веса модели загружаются из памяти GPU один раз и используются сразу для всех запросов в пачке. Это повышает загрузку вычислительных блоков и снижает стоимость обработки одного запроса. Цена вопроса: запрос может немного подождать, пока соберется пачка.
И еще один трюк — квантизация. Квантизация уменьшает «вес» модели. Параметры модели хранятся как числа с большой точностью, и каждое занимает много памяти. При квантизации их округляют до менее точных: например, вместо 16 бит на число оставляют 8 или даже 4 бита. Модель становится в разы компактнее и быстрее, но это влияет на качество ответов. Здесь уместно сравнение с фотографией в меньшем разрешении, которая весит гораздо меньше, а на глаз выглядит почти так же. Это позволяет запустить модель большего размера на том же железе и экономить дорогостоящие ресурсы GPU.
Именно из-за квантизации одна и та же модель может весить от 0,5 до 2 ТБ: триллион параметров по 4 бита занимает 0,5 ТБ, по 16 бит — уже 2 ТБ.
Квантизация — снижение точности, с которой хранятся и считаются параметры модели: например, переход от 16-битных чисел к 8- или 4-битным. Модель занимает в 2–4 раза меньше памяти и быстрее работает, потому что данных нужно передавать меньше. Платой становится небольшая потеря качества, которая обычно тем заметнее, чем агрессивнее сжатие.
С помощью батчинга и квантизации ресурсы провайдера тратятся эффективнее.
Мониторинг и надежность
За ИИ-сервисом постоянно следят автоматика и дежурные инженеры. Они отслеживают время ответа, долю ошибок, загрузку сети и состояние каждого GPU. Если сервер начинает сбоить, система сама уводит с него нагрузку. В кластере OpenAI, например, неисправный узел автоматически закрывается для новых задач. Это называется отказоустойчивостью. Хороший ориентир для облачных сервисов — доступность 99,99%, то есть не более 52 минут простоя за год.
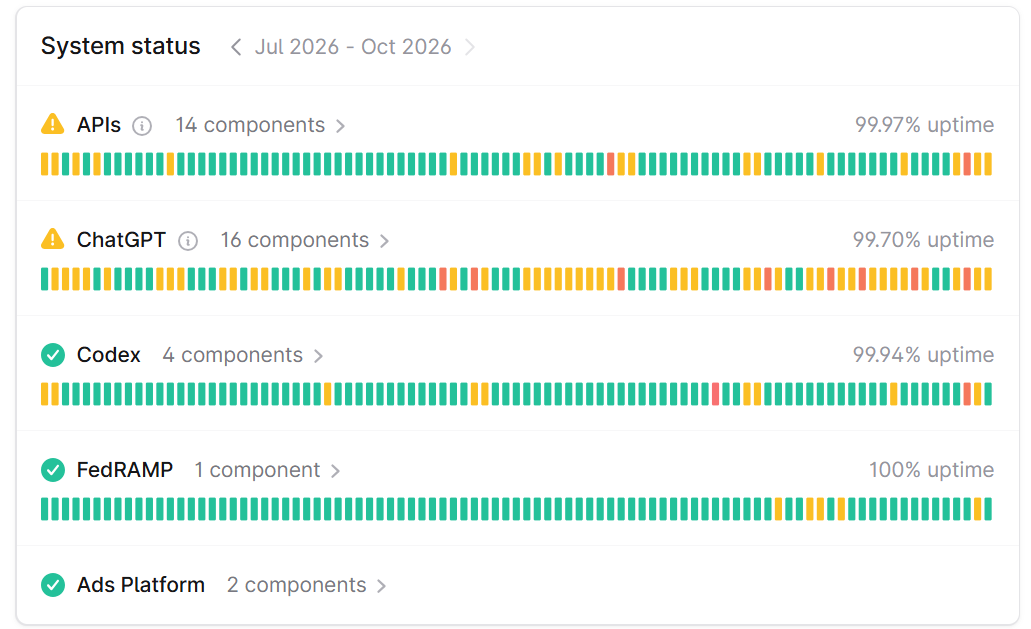
ИИ-чаты до этой планки пока не дотягивают. На странице статуса OpenAI за июль–октябрь 2026 года у ChatGPT значится 99,70%, у API 99,97%. У Claude 29 сентября 2026 года был сбой на 59 минут. Один такой случай уже больше годового запаса при четырех девятках.
Это молодые сервисы, которые растут в разы каждый год, и работают они на оборудовании, которое время от времени выходит из строя. Систему проектируют в расчете на то, что что-то сломано прямо сейчас: несколько дата-центров, несколько копий каждого сервиса, автоматическое переключение при сбое. Так ИИ-сервис становится надежнее и отказоустойчивее, что позволяет пользователю пользоваться им без задержек и простоев.
Заключение
За одним ответом в чате стоят шесть слоев: проверка на входе, хранение переписки, сама модель, ее копии на серверах, оптимизации и мониторинг. Дороже всего обходится железо. От него зависит то, что вы замечаете каждый день: скорость ответа, лимиты и доступность сервиса.