ИИ-ускорители без HBM, 2-нм процессор Fujitsu MONAKA, серверы ASUS с PCIe 6.0 — главные новинки сентября
Сентябрь снова радует нас анонсами железа. Huawei и Alibaba с разницей в пять дней показали планы по ИИ-ускорителям, Fujitsu представила ARM-процессоры MONAKA, а NVIDIA и AMD без пресс-релизов пополнили каталоги. Ниже обзор рынка за месяц: от модулей памяти на 512 ГБ до ускорителей, которые обходятся без HBM.
О чем писал Selectel
Micron показали модули RDIMM DDR5-9200 на 512 ГБ. Теперь в двухсокетный сервер с 24 слотами поместится до 12 ТБ памяти. Такой объем на одной планке дала вертикальная упаковка кристаллов с TSV. К тому же один модуль потребляет 16 Вт против 44,2 Вт у четырех планок по 128 ГБ. Массовое производство обещают только во второй половине 2027 года, и стоить новинки, судя по тому, как растет цена за гигабайт, будут немало.
NVIDIA добавила в линейку Blackwell™ карту RTX™ PRO 5500 с 84 ГБ памяти GDDR7. Модель на том же чипе GB202, что и RTX™ 5090. У нее необычная шина и два серверных вентилятора 40×40×56, так что это карта для стойки, а не «под стол». Ждем в серверах.
В каталоге AMD тихо, без анонсов, появились два бюджетных шестиядерника на старых линейках. Ryzen™ 5 7500 для AM5, по сути тот же 7500F, но со встроенной графикой RDNA 2. Ryzen™ 5 5500F для AM4 собран на чиплетах Vermeer: он получил PCIe 4.0, но L3-кэш урезали до 16 МБ.
Huawei представила Atlas 960E SuperPoD на 4 096 NPU с оптическими модулями Hi-ONE, а Alibaba — чип Zhenwu V900 с 216 ГБ HBM и интерконнектом на 1,2 ТБ/с. В статье — сравнение с решениями от NVIDIA и AMD, а заодно вспоминаем китайские Moore Threads MTT S5000 и Dongfang Suanxin DF1000. Почти все новинки выйдут только в 2027 году, зато компании ищут обходные пути: в топологии, вертикальной интеграции и архитектуре памяти.
Тестируем сервер на 16 ускорителях Alibaba PPU Zhenwu 810E с 1,5 ТБ HBM2e и разбираемся, можно ли встроить его в облако. В статье замер интерконнекта ICN (89 ГБ/с на двойном линке, 44 на одинарном и всего 14 через PCIe), запуск DeepSeek-V4-Flash и Kimi K2.6. Железо производительное, проблема наблюдается только в стеке.
Новости рынка
HyperAccel Bertha — инференс-ускоритель без HBM
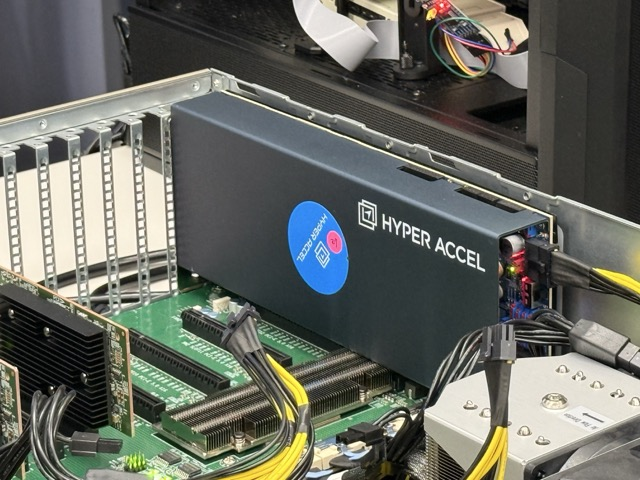
Южнокорейский стартап HyperAccel показал ускорители Bertha. Идея в том, что вместо дорогой HBM здесь стоит обычная LPDDR5X. За счет этого компания надеется выиграть у GPU по цене токена. Решение не новое и не прорывное, но рабочее.
Старшая двухслотовая модель Bertha 500 выпускается по 4-нм техпроцессу:
- 256 МБ SRAM и 128 ГБ LPDDR5X;
- пропускная способность памяти 546 ГБ/с;
- производительность 768 Тфлопс в формате FP8 и 384 Тфлопс в FP16;
- поддерживаются FP4, INT8 и INT4;
- TDP 250 Вт.
Позже обещают версию на 256 ГБ LPDDR5X.
Для сравнения: у достаточно старой NVIDIA® H100 пропускная способность памяти от 2 ТБ/с, то есть примерно в четыре раза выше. Но при этом TDP почти втрое больше.
HyperAccel делает ставку на загрузку железа: архитектура LPU подгоняет вычисления под пропускную способность памяти, и в среднем за время инференса удается держать около 90% утилизации.
Младшая Bertha 100 сделана в формате M.2:
- 16 ГБ LPDDR5X;
- пропускная способность 64 ГБ/с;
- производительность 32,8 Тфлопс FP8.
Ее появление обещано в IV квартале. Из софта поддерживаются PyTorch, ONNX и vLLM.
Против H100 на своем сайте компания приводит такие цифры: вдвое выше пропускная способность в токенах, в 19 раз больше токенов на доллар и в 12 раз больше на киловатт. Это собственные замеры вендора, так что с реальностью они могут не совпасть. Также для сравнения выбран очень старый игрок, NVIDIA ушли далеко вперед по серверным GPU.
Axelera Europa — AIPU пошел в серию
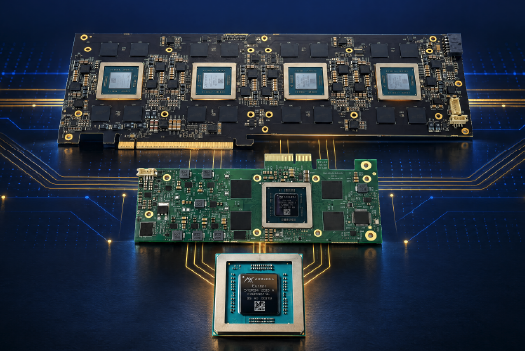
Нидерландская Axelera AI начала отгрузки чипов Europa для корпоративного инференса.
Устройство AIPU :
- восемь ИИ-ядер с цифровыми вычислениями в памяти (D-IMC);
- 16 векторных ядер RISC-V;
- 128 МБ L2 SRAM и 256-битный интерфейс LPDDR5 на 200 ГБ/с;
- в INT8 до 629 TOPS.
У прошлого поколения устройств Metis было 214 TOPS — заявлен трехкратный прирост.
Europa продается как отдельный чип для собственных плат, а также как низкопрофильная карта Edge 232p с одним процессором и как полноразмерная Server 250p с четырьмя чипами. Edge 232p уже валидирована в серверах Dell XE5 и Supermicro 111AD. Поддержку обещают также другие вендоры.
Axelera обещает больше токенов в секунду на ватт, чем у GPU-решений. Но и здесь это внутренние тесты, а не публичные бенчмарки. Компания заявляет о внедрении у 600 клиентов и портфель заказов в 1,5 млрд $. На поверку вторая цифра оказывается лишь воронкой продаж, то есть это потенциальные сделки, а не подписанные контракты.
Дорожная карта Huawei Ascend: железо для обучения и инференса
На конференции Connect компания Huawei раскрыла планы по ускорителям Ascend.
Они разделены по задачам. Первым выйдет Ascend™ 960DT, где «DT» означает decode/training. Чип появится в первом квартале 2027 года (на три квартала раньше первоначального графика).
Характеристики Ascend 960DT:
- 288 ГБ памяти, предположительно HBM собственной разработки под названием HiZQ;
- производительность 4 Пфлопс в FP4 и 2 Пфлопс в FP8;
- пропускная способность памяти на уровне 9,6 ТБ/с.
По памяти 960DT близок к NVIDIA® B300, но в FP8 уступает ему вдвое, а в FP4 — втрое. А до Rubin™ с его 35-50 Пфлопс FP4 и вовсе еще далеко.
Далее по плану идет Ascend 960PR для prefill-вычислений и рекомендательных систем. Его релиз намечен на третий квартал 2027 года.
Характеристики Ascend 960PR:
- 192 ГБ памяти;
- пропускная способность 2,4 ТБ/с;
- производительность 8 Пфлопс FP4.
Схема знакомая: prefill обрабатывается на одном чипе, decode — на другом.
В 2028 году ожидается Ascend 970: 288 ГБ, 14,4 ТБ/с, 3,6 Пфлопс FP8 и 14 Пфлопс FP4. В 2029-м запланирован Ascend 980: 384 ГБ, 38,4 ТБ/с, 7,2 и 28 Пфлопс. Дорожные карты на три года вперед выглядят неубедительно, но альтернатива Blackwell™ и Rubin™ с такими планами выглядит полезной для всего рынка.
Arm Neoverse CSS N4 для серверного CPU
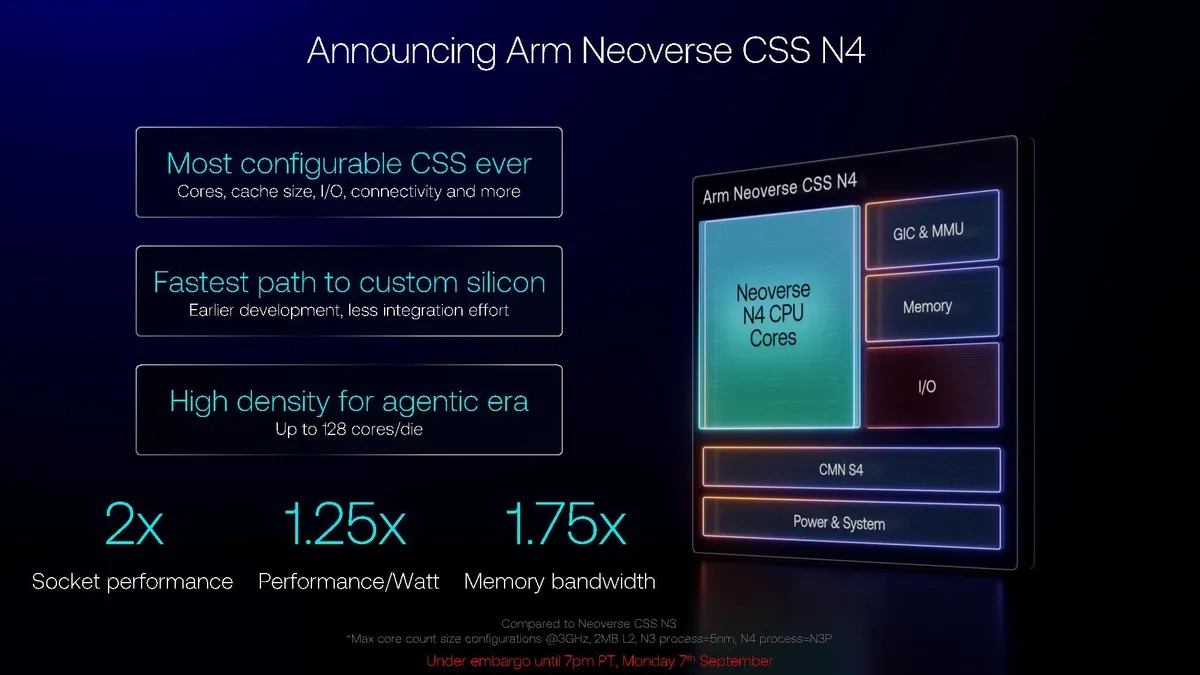
Arm показали свою вычислительную подсистему Neoverse CSS N4 под кодовым именем Ranger.
Это готовый RTL-блок (Register-Transfer Level, уровень регистровых передач) для компаний, которые хотят собственный серверный процессор или DPU:
- подсистема конфигурируется от 8 до 128 ядер Neoverse N4 на кристалл;
- частота достигает 3,8 ГГц — и это первый подобный показатель для N-серии;
- из памяти поддерживаются LPDDR6 и DDR5;
- ввод-вывод дает до 128 линий PCIe 7.0.
Внутри стоит mesh-интерконнект CMN S4 с когерентной связью между чиплетами. По сравнению с предыдущим поколением CSS N3 Arm обещает до двух раз больше производительности на сокет, в 1,25 раза лучшую производительность на ватт и в 1,75 раза большую пропускную способность памяти.
По словам Arm, технологиями компании уже пользуются OpenAI, Cloudflare, Oracle, SAP, Lenovo, Supermicro и Verda. Еще год назад x86-вендоры шутили, что Arm в ЦОДе нужен только гиперскейлерам. Теперь гиперскейлеры почти все и закупают.
Fujitsu MONAKA: 144 ядра Arm
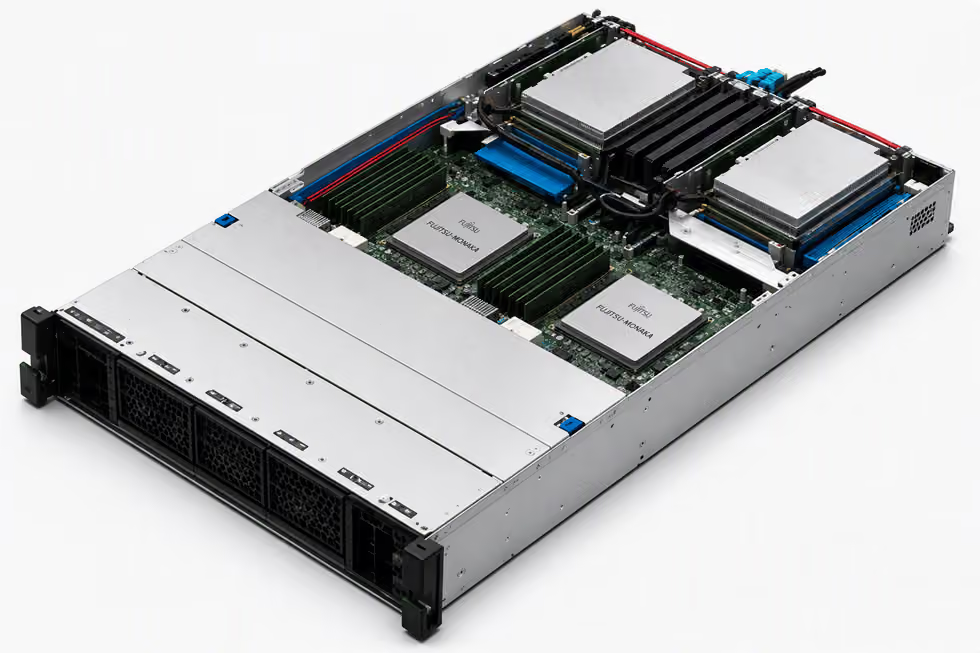
Fujitsu анонсировали старт глобальных продаж процессоров MONAKA. Его можно будет купить как отдельно, так и в составе серверов Fujitsu MONAKA Server.
MONAKA устроен как 3D-стек: вычислительные ядра сделаны по 2-нм процессу, кеш и I/O — по 5-нм. Характеристики:
- до 144 ядер,
- частота до 3,8 ГГц,
- память DDR5-8800.
Матричные операции ускоряются специальными инструкциями. Вместе с SVE2 это, по данным Fujitsu, дает вдвое большую пропускную способность ИИ-инференса, чем у других CPU.
Для конфиденциальных вычислений есть Arm CCA. Если вспомнить предшественника A64FX из суперкомпьютера Fugaku с его 48 ядрами и HBM2, очевидно, что Fujitsu сменила назначение железа с HPC-экзотики на массовый серверный чип.
Первые серверы выйдут в форматах 1U с одним или двумя сокетами и 2U с двумя сокетами. Память можно расширять через CXL-пулы. Для науки и HPC готовится многоузловая система 2U4N.
Unigen Cheetah: быстрый ярус и емкий ярус
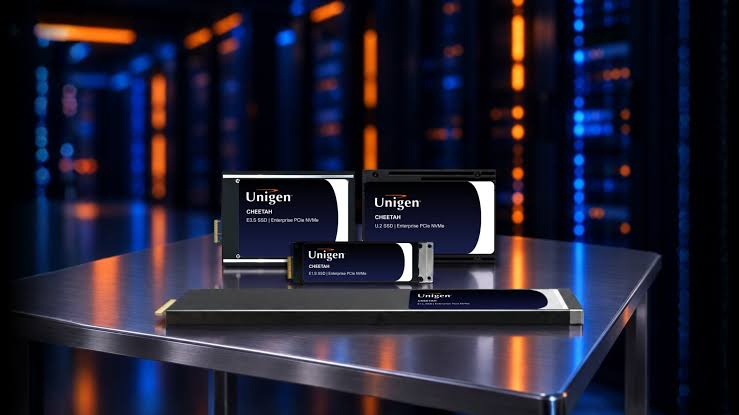
Unigen запустила в производство две серии корпоративных SSD с интерфейсом PCIe 5.0 x4 и NVMe 2.0. Обе серии построены на 16-канальных контроллерах с кешем DDR5.
Ярус (tier) — это уровень в многоуровневой системе хранения. Данные раскладываются по разным типам накопителей в зависимости от того, как часто к ним обращаются. Cheetah SCM — быстрый ярус на pSLC/eTLC емкостью 1,6 и 3,2 ТБ:
- форматы E1.L, E3.S, E1.S и U.2;
- последовательное чтение до 14,7 ГБ/с — почти упор в потолок PCIe 5.0 x4;
- случайное чтение блоками по 4 КБ до 3,37 млн IOPS;
- DWPD 60 на случайной нагрузке и 80 на последовательной.
Таким образом, для модели на 3,2 ТБ это около 192 ТБ записи ежедневно. Сюда отправляют scratch, кеши и журналы.
Cheetah HC — емкий ярус, склад на QLC или TLC объемом до 122,88 ТБ в форматах E1.L и U.2:
- чтение 14 ГБ/с,
- запись 2,4 ГБ/с,
- DWPD 0,3 при случайной нагрузке.
Для QLC небольшой показатель DWPD — это нормально. Пишут на такой диск редко, а читают много (например, веса моделей и датасеты). Unigen прямо предлагает связку «SCM спереди, HC сзади». Логика стандартная, еще удобнее получить оба яруса у одного вендора.
ASUS: пять серверов на Xeon 6, EPYC Venice и Turin
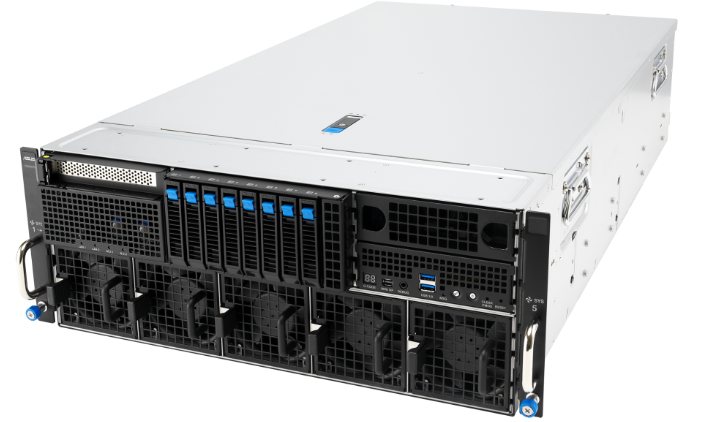
На мероприятии ASUS AI Tech 2026 в Сеуле показали пять новых серверов. Особого внимания заслуживает новинка для недавно анонсированных процессоров AMD.
Под Intel® Xeon® 6 предназначены 1U-модель RS700-E12-RS4U и 2U-модель RS720-E12-RS12U. Обе двухсокетные, с 32 слотами DDR5-6400 и объемом памяти до 8 ТБ. Младшая получила два слота PCIe 5.0 x16, два OCP 3.0 и четыре отсека SFF. Старшая дает до десяти слотов расширения и 12 отсеков SFF.
На новеньких AMD EPYC™ 9006 (Venice) построены RS720A-E14B-R32U и RS500A-E14B-R12U. Первая рассчитана на 32 накопителя E3.S. Вторая односокетная, на 16 модулей DDR5 общим объемом до 2 ТБ. Обе получили PCIe 6.0 и BMC AST2700.
Особняком стоит 4U-модель ESC8000A-E13P на двух EPYC™ 9005 (Turin). В нее помещаются восемь двухслотовых ускорителей: NVIDIA® H200, RTX™ PRO 6000 и 4500 Blackwell™ Server Edition или AMD Instinct™ MI350P. Ничего революционного здесь нет, особенно для тех, кто собирается на Venice, но это платформы уже с PCIe 6.0.
Заключение
Если свести месяц к одной теме, то это снова удешевление инференса. HyperAccel и Axelera обходятся LPDDR вместо HBM, Fujitsu переносит матричные операции на CPU, Huawei разводит prefill и decode по разным чипам. Многое из этого «доедет» до заказчиков только в 2027 году, а цифры пока дают сами вендоры. Будем ждать результатов реальной эксплуатации, и часть железа проверим сами, как это было с Zhenwu 810E.