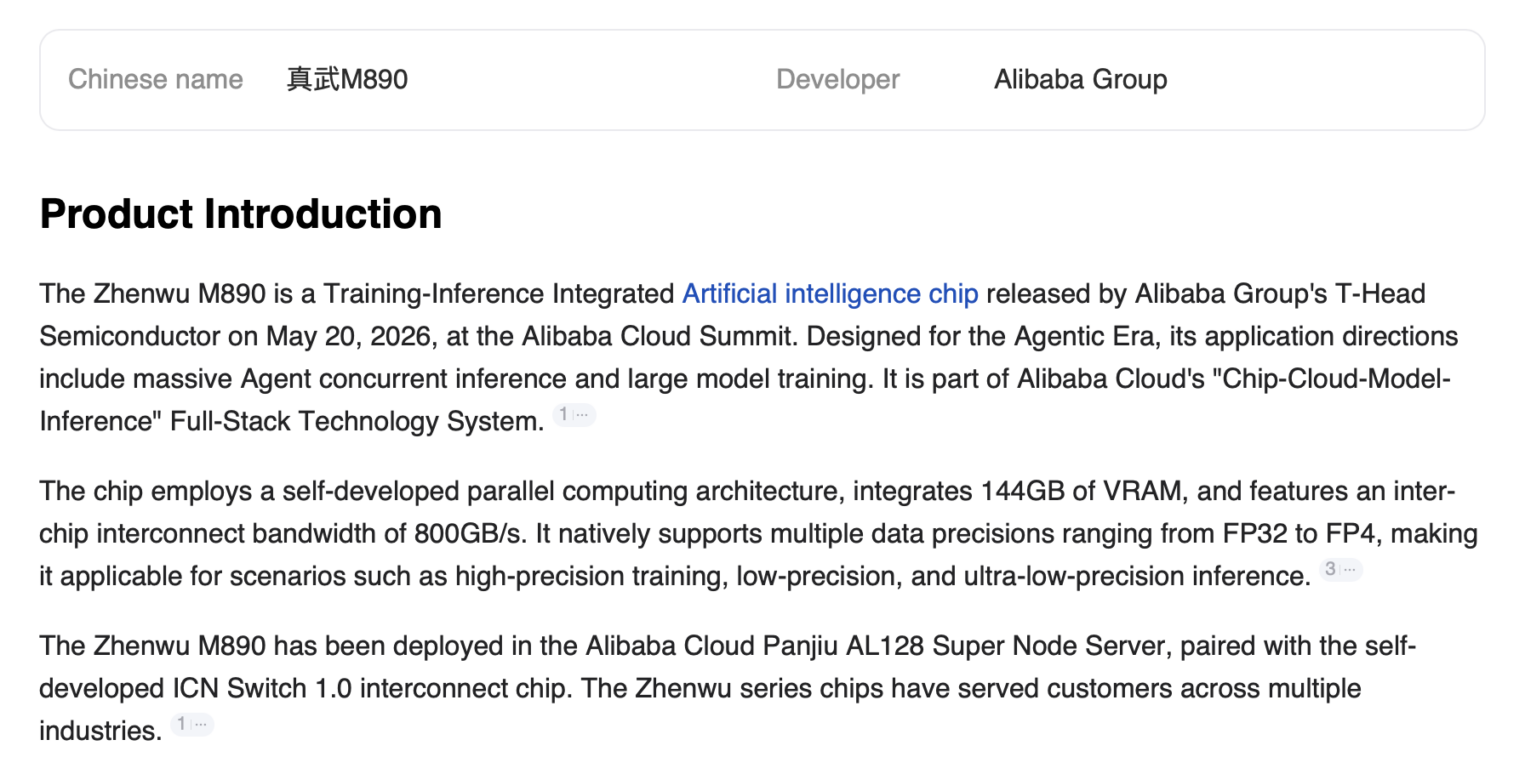
Современный ландшафт AI-ускорителей изобилует всевозможными устройствами: GPU, TPU, NPU, LPU и прочими удивительными аббревиатурами. Китайские компании активно участвуют в этой колоссальной гонке, и в данном материале я расскажу, как мы тестировали AI-ускоритель от Alibaba Group.
В первую очередь мы хотели понять, что за устройство перед нами и как его можно использовать в наших стандартных сценариях для инференса — прежде всего в качестве ноды для облачного Kubernetes или как самостоятельный dedicated-сервер. Что ж, давайте разбираться.
Пару слов про PPU
Компания Chaitex предоставила нам для тестирования сервер в виде AI-станции. Она поставляется с предустановленными драйверами и компонентами для работы через UI-интерфейс. Так как работа через UI — не наш целевой вариант использования, то все тесты касались потенциальной возможности интегрировать такой сервер в нашу облачную инфраструктуру.
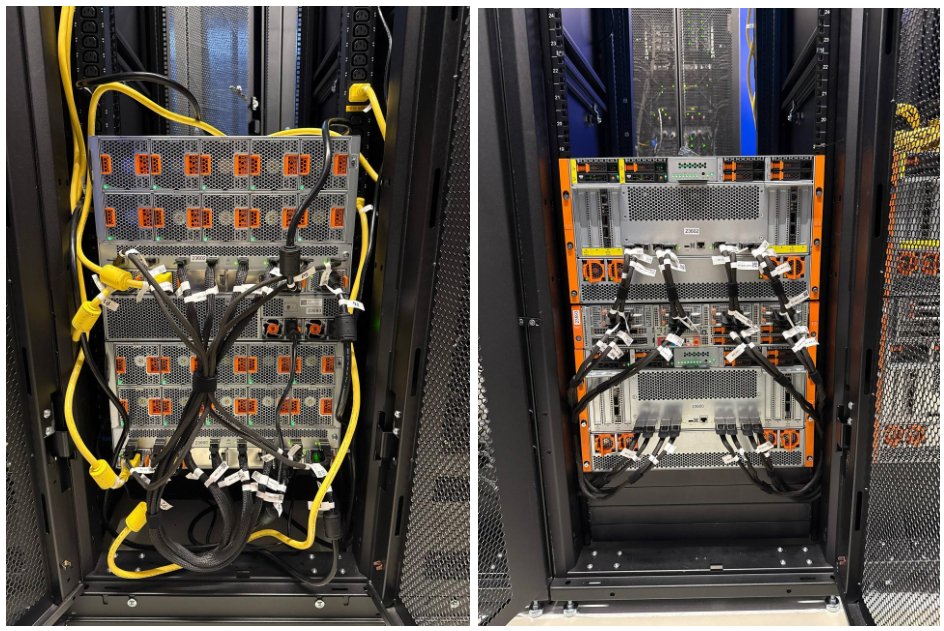
Возможности изменить ОС и драйверы не представилось, но тем не менее в официальной документации имеется ссылка на загрузку единственной доступной версии драйверов v2.1.2.
Конфигурация сервера включает в себя 16 PPU Zhenwu 810E. Их разрабатывает подразделение Alibaba — T-HEAD (Pingtou Ge Semiconductor Co., Ltd.). Сами Alibaba называют устройство Parallel Processing Unit. Можно воспринимать его как отдельный класс ускорителей, вроде TPU или GPU.
Zhenwu 810E, согласно характеристикам, оснащен 96GB HBM2e с заявленной пропускной способностью 2 765 ГБ/с (~2,77 ТБ/с), интерфейсом PCIe 5.0 x 16 и собственным межчиповым интерконнектом ICN с заявленной суммарной пропускной способностью до 700 ГБ/с на ускоритель. Суммарно на сервере мы имеем 1 536 ГБ HBM2e VRAM — довольно впечатляющий объем.
Документация и совместимость
Весь стек, связанный с PPU, — суверенный и локальный, нативные NVIDIA-библиотеки и инструменты не работают с PPU, хотя заявляется, что существует совместимость с исходниками для CUDA-кода. Но эти исходники нужно компилировать под PPU c помощью PPU SDK для портирования. Ниже приведена схема компиляции из документации.
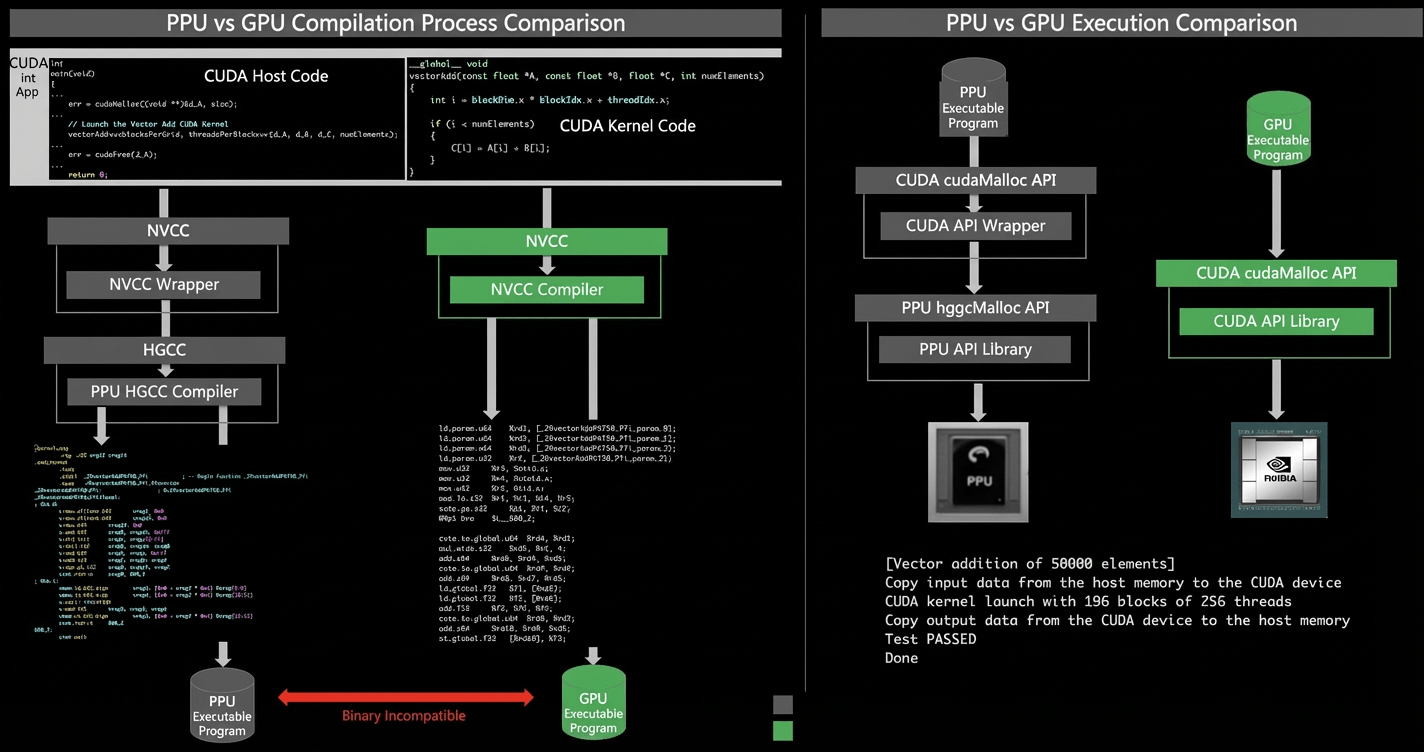
Таким образом, все привычные для трейнинга и инференса библиотеки и тулы — PyTorch, Transformers, flashattention, vLLM и прочие — должны быть портированы под PPU.
Адаптацией библиотек, тулов и квантизацией моделей занимается также компания T-HEAD. Что касается документации — она доступна на китайском языке и скорее предназначена разработчикам SDK. В комплекте с AI-станцией идет русскоязычная инструкция по работе с установленной на сервер инференс-платформой Alibaba AI Stack. Я же в своих исследованиях пользовался документацией по облачному сервису Alibaba Cloud Zhenwu PPU Service. Часть информации доступна на английском, но самая актуальная выглядит так:
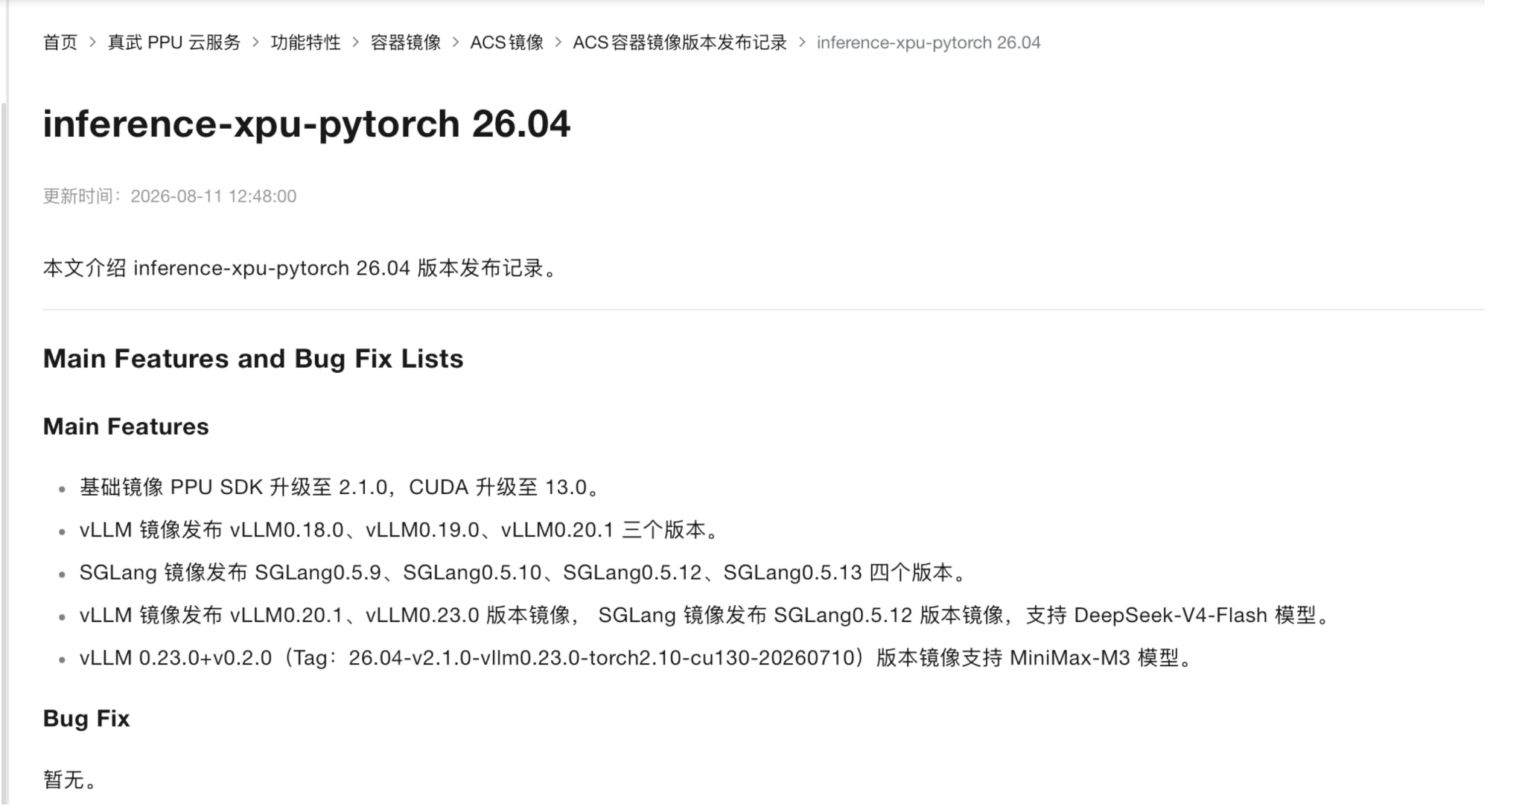
Если хотите на английском — будьте добры пройти на глобальный портал облака, но имейте в виду, что там документация доступна только в предыдущей итерации. А актуальность доступной информации для PPU имеет важное значение, и далее вы поймете, почему.
Так вот, портированный и скомпилированный стек для инференса предоставляется в виде собранного Docker-образа. Сам образ имеет определенный тег и в документации можно посмотреть конкретные версии библиотек и тулов, адаптированных под PPU.
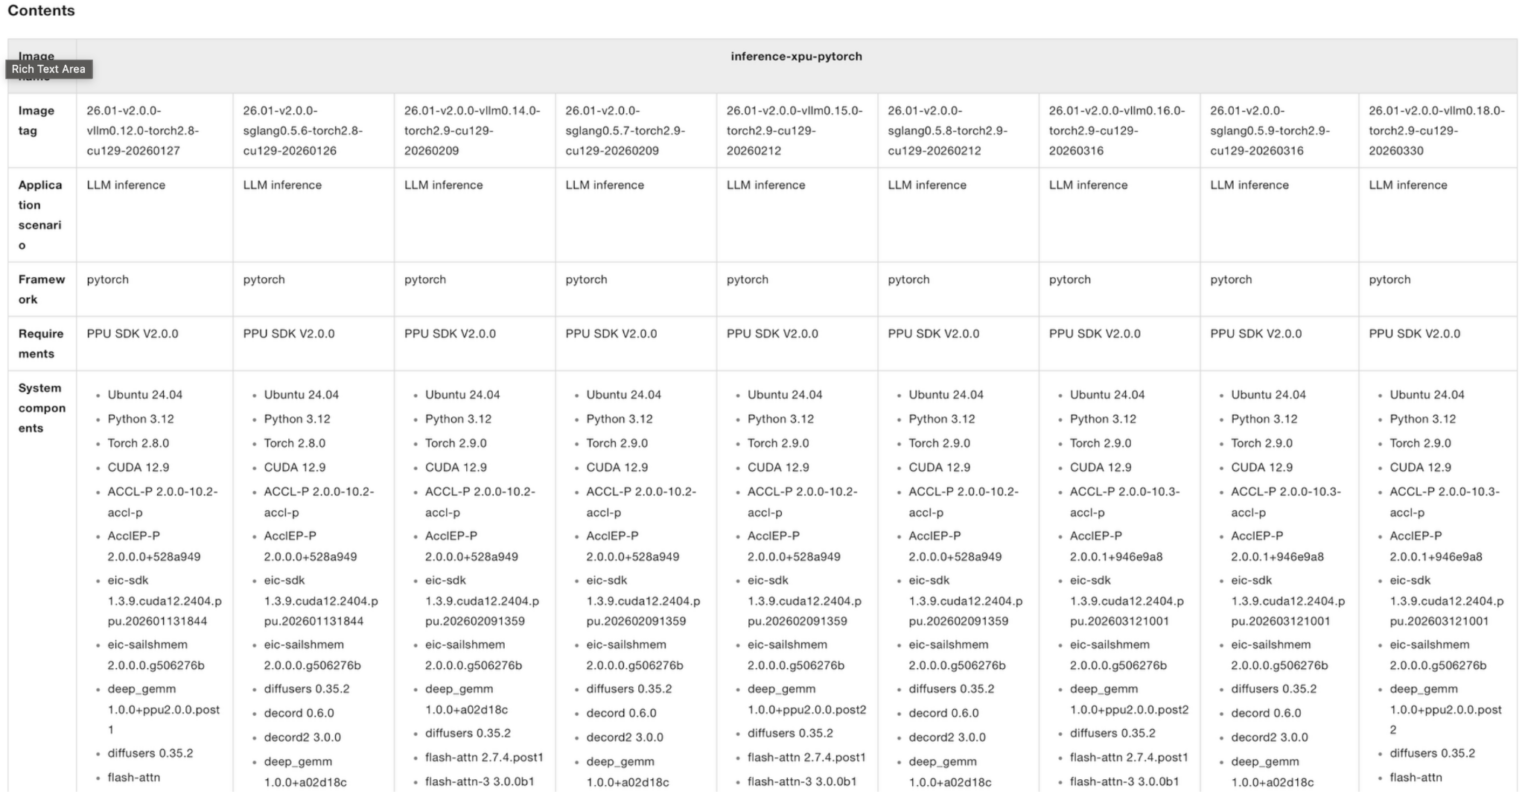
И вот тут проявляется основной риск использования этого стека. При появлении новой актуальной модели или новой версии инференс-сервера мы вынуждены дожидаться, пока команда T-HEAD портирует все это под PPU. Даже в текущей ситуации мы зачастую ждем поддержку архитектуры: например, в vLLM некоторое время и в особых случаях пользуемся nightly-образами.
C PPU эта итерация увеличивается на неопределенный срок — например, на 26.08.2026 актуальный образ vLLM имеет версию v0.27.0, а актуальная сборка для PPU, которую можно найти только на китайской версии Alibaba Cloud, имеет в своем составе vLLM v0.23.0. Плюс для PPU существуют рекомендуемые квантизации весов моделей — и их квантизацией занимается тоже команда T-HEAD.
Что касается квантования, здесь есть важный момент. PPU поддерживает FP32, BF16 и FP16, а также следующие схемы квантизации: W8A8 (INT8), AWQ (W4A16), и GPTQ (W4A16, W8A16). Сами Alibaba советуют для инференса использовать W8A8 квантизацию моделей: она компактнее полновесных, при этом нет критического падения качества. В частности, актуальные на текущий момент модели с такой квантизацией, которую советуют производители PPU, это DeepSeek R1, DeepSeek v3.2, Kimi-K2-Instruct, Qwen3-235B-A22B, GLM-5, MiniMax-M2.5 и Qwen3.5-397B-A17B:
      The following are examples of quantized models adapted for SDK 2.0. The system login credentials are the same as your PTG PIP credentials. If you do not have them, contact your account manager:

DeepSeek-R1: Supports per-token/per-channel a8w8 (int8) quantization.
DeepSeek v3.2: Supports per-token/per-channel a8w8 (int8) quantization.
Kimi-K2-Instruct: Supports per-token/per-channel a8w8 (int8) quantization.
Qwen3-235B-A22B: Supports per-token/per-channel a8w8 (int8) quantization.
GLM-5: Supports per-token/per-channel w8a8 (int8) quantization.
MiniMax-M2.5: Supports per-token/per-channel w8a8 (int8) quantization.
Qwen3.5-397B-A17B: Supports per-token/per-channel w8a8 (int8) quantization.
В самом же UI-интерфейсе AI-станции можно увидеть такой список предлагаемых моделей вендором:
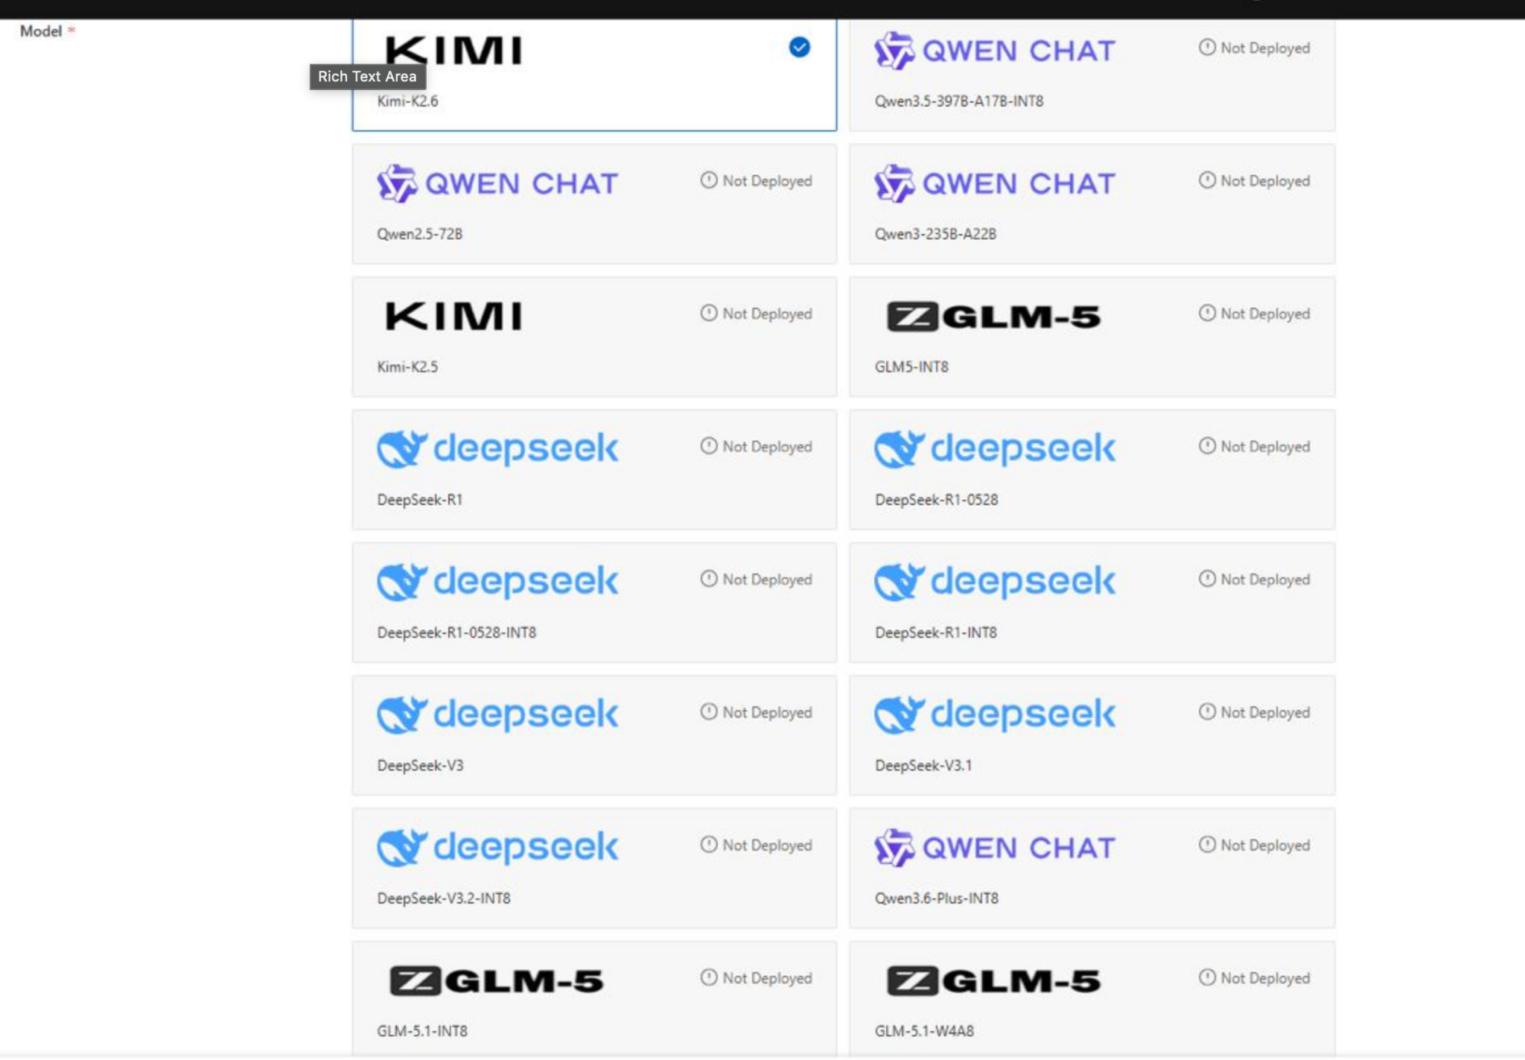
Можно оценить «свежесть» моделей и рекомендуемые квантизации. И раздобыть такие веса — та еще задача.
На Hugging Face T-HEAD не представлена — есть модели в W8A8, но от неверифицированных источников, официально не поддерживаемых T-HEAD. Сами T-HEAD выкладывают свои модели на китайском аналоге Hugging Face — Modelscope.cn (на глобальной версии Modelscope.ai их нет).
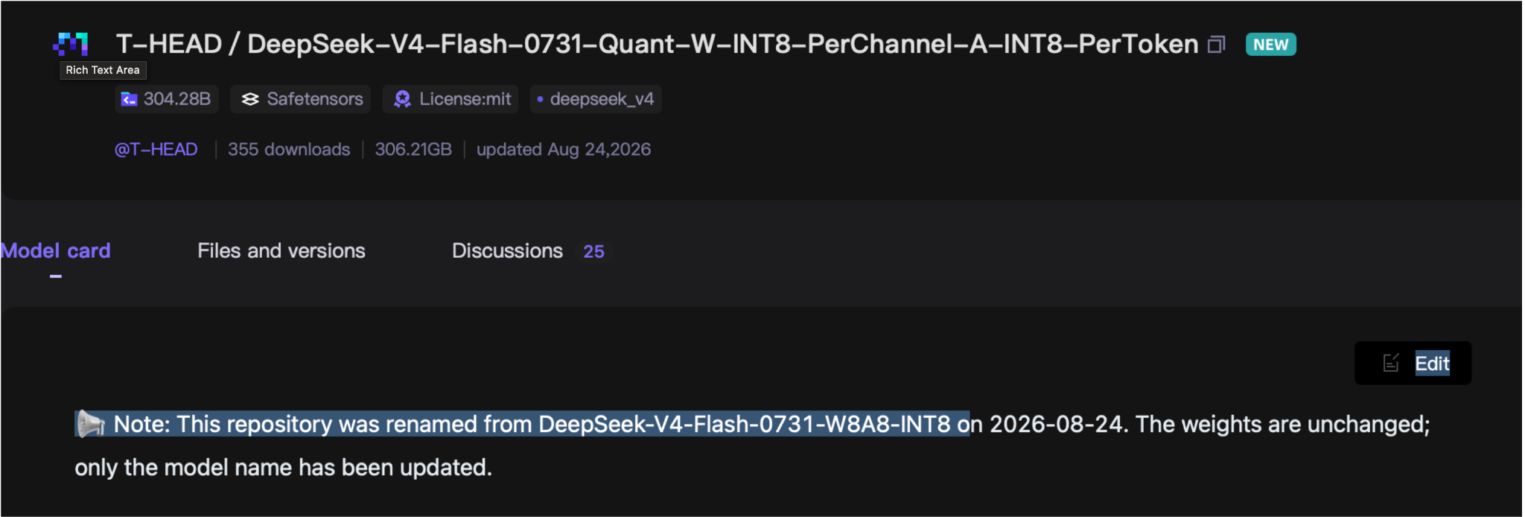
Внутри образа PPU SDK модель качается без авторизаций и токенов:
modelscope download --model T-HEAD/DeepSeek-V4-Flash-0731-W8A8-INT8 --local_dir deepseek
Для привычных NVIDIA-утилит есть аналоги: часть доступна на самом сервере, часть — внутри образа PPU SDK . Я делаю акцент на доступности тулов вот почему: согласно документации от cloud-сервиса PPU Zhenwu 810e, чтобы добыть deb- / rpm-пакет аналога DCGM, нужен какой-то аккаунт.
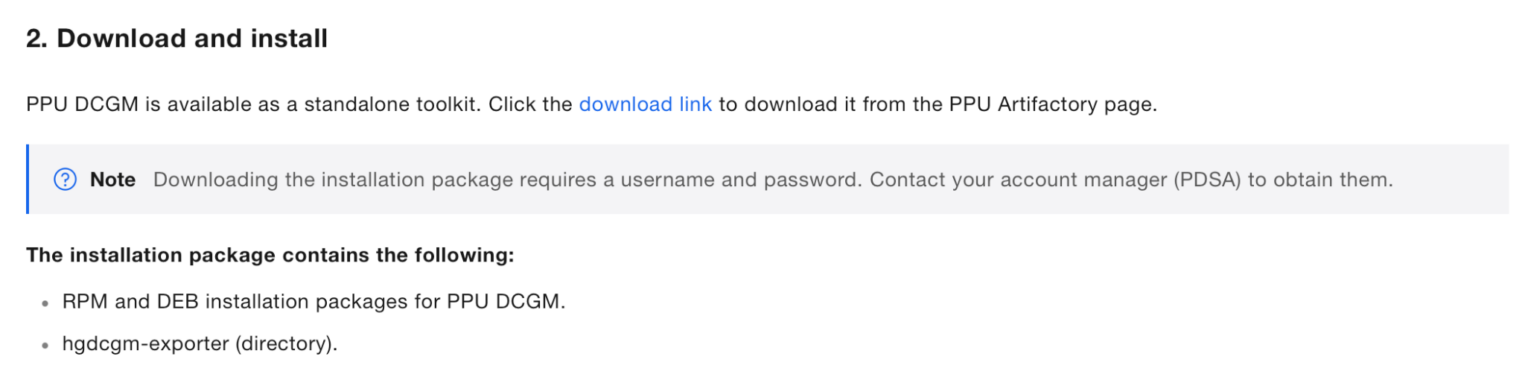
Речь идет только о cloud-сервисе, документацией которого я пользовался, или вообще о всей обвязке PPU — непонятно, но найти rpm-пакет для ppu-dcgm мне не удалось.
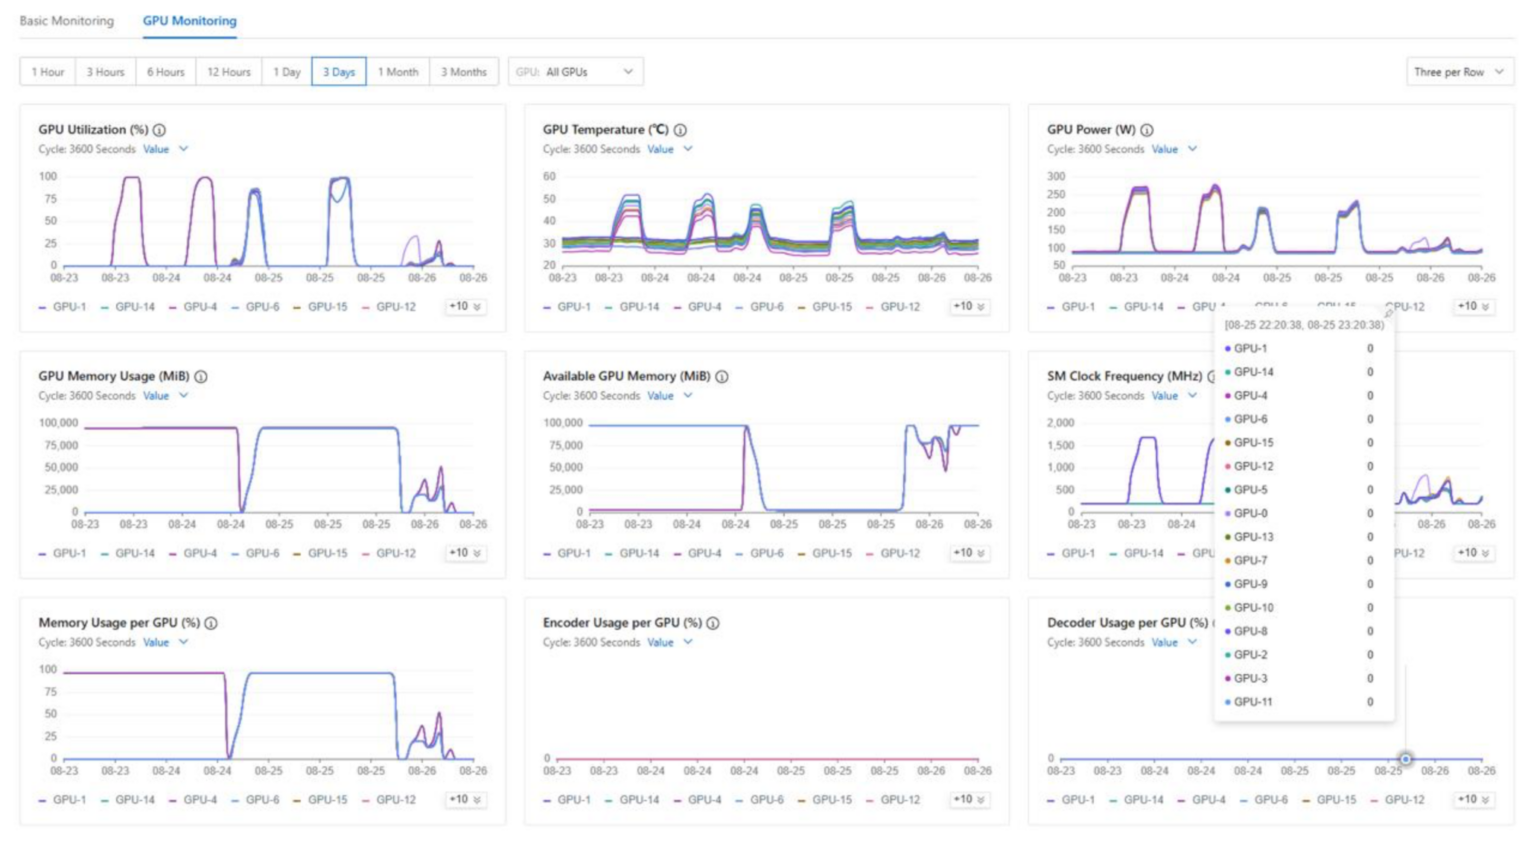
В UI-интерфейсе AI-станции меж тем метрики PPU отображены.
Обзор сервера
Итак, приступаем к практическим шагам. В первую очередь хотелось получить хоть какую-то знакомую информацию и я воспользовался ppu-smi — аналогом nvidia-smi. Он показывает 16 PPU-устройств с похожими метриками утилизации, возможным MIG-профилем (!), версией драйвера и возможной версией HGGC.
[root@ali117196 ~]# ppu-smi
Tue Aug 18 22:02:09 2026
+-------------------------------------------------------------------------------+
| PPU-SMI 1.18          Driver Version: 1.6.3-8ee7e7  HGGC Version: N/A         |
+---------------------------------+----------------------+----------------------+
| PPU  Name        Persistence M. | Bus-Id               | Volatile Uncorr. ECC |
| Fan  Temp  Perf   Pwr:Usage/Cap | Memory-Usage         | PPU-Util  Compute M. |
|                                 |                      |               MIG M. |
+=================================+======================+======================+
| 0  PPU-ZW810E        N/A        | 00000001:C9:00.0     |                    0 |
| N/A  31C   N/A       90W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 1  PPU-ZW810E        N/A        | 00000001:C8:00.0     |                    0 |
| N/A  33C   N/A       86W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 2  PPU-ZW810E        N/A        | 00000001:80:00.0     |                    0 |
| N/A  30C   N/A       87W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 3  PPU-ZW810E        N/A        | 00000001:81:00.0     |                    0 |
| N/A  28C   N/A       92W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 4  PPU-ZW810E        N/A        | 00000000:7E:00.0     |                    0 |
| N/A  27C   N/A       90W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 5  PPU-ZW810E        N/A        | 00000000:7F:00.0     |                    0 |
| N/A  29C   N/A       87W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 6  PPU-ZW810E        N/A        | 00000000:C7:00.0     |                    0 |
| N/A  31C   N/A       90W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 7  PPU-ZW810E        N/A        | 00000000:C6:00.0     |                    0 |
| N/A  31C   N/A       85W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 8  PPU-ZW810E        N/A        | 00000001:A5:00.0     |                    0 |
| N/A  32C   N/A       87W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 9  PPU-ZW810E        N/A        | 00000001:A4:00.0     |                    0 |
| N/A  32C   N/A       89W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 10  PPU-ZW810E        N/A       | 00000001:0A:00.0     |                    0 |
| N/A  30C   N/A       89W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 11  PPU-ZW810E        N/A       | 00000001:0B:00.0     |                    0 |
| N/A  28C   N/A       86W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 12  PPU-ZW810E        N/A       | 00000000:08:00.0     |                    0 |
| N/A  28C   N/A       87W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 13  PPU-ZW810E        N/A       | 00000000:09:00.0     |                    0 |
| N/A  31C   N/A       86W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 14  PPU-ZW810E        N/A       | 00000000:A3:00.0     |                    0 |
| N/A  33C   N/A       88W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 15  PPU-ZW810E        N/A       | 00000000:A2:00.0     |                    0 |
| N/A  32C   N/A       90W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+

+-------------------------------------------------------------------------------+
| Processes:                                                                    |
| PPU    GI   CI   PID      Type  Process name                       PPU Memory |
|        ID   ID                                                     Usage      |
+===============================================================================+
| No running processes found                                                    |
+-------------------------------------------------------------------------------+
PPU связаны между собой по хитрой физико-логической топологии.
[root@ali117196 ~]# ppu-smi topo -m
         PPU0    PPU1    PPU2    PPU3    PPU4    PPU5    PPU6    PPU7    PPU8    PPU9    PPU10   PPU11   PPU12   PPU13   PPU14   PPU15   NIC0    NIC1    NIC2    NIC3    NIC4    NIC5    CPU Affinity
NUMA Affinity
 PPU0    X       ICN2    ICN1    ICN2    ICN1    SYS     SYS     SYS     SYS     ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     48-95,144-191
2-3
 PPU1    ICN2    X       ICN2    ICN1    SYS     ICN1    SYS     SYS     ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     48-95,144-191
2-3
 PPU2    ICN1    ICN2    X       ICN1    SYS     SYS     ICN2    SYS     SYS     SYS     SYS     ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     PIX     48-95,144-191
2-3
 PPU3    ICN2    ICN1    ICN1    X       SYS     SYS     SYS     ICN2    SYS     SYS     ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     PIX     48-95,144-191
2-3
 PPU4    ICN1    SYS     SYS     SYS     X       ICN2    ICN1    ICN2    SYS     SYS     SYS     SYS     SYS     ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     0-47,96-143
0-1
 PPU5    SYS     ICN1    SYS     SYS     ICN2    X       ICN2    ICN1    SYS     SYS     SYS     SYS     ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     0-47,96-143
0-1
 PPU6    SYS     SYS     ICN2    SYS     ICN1    ICN2    X       ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     ICN1    SYS     SYS     SYS     PIX     SYS     SYS     0-47,96-143
0-1
 PPU7    SYS     SYS     SYS     ICN2    ICN2    ICN1    ICN1    X       SYS     SYS     SYS     SYS     SYS     SYS     ICN1    SYS     SYS     SYS     SYS     PIX     SYS     SYS     0-47,96-143
0-1
 PPU8    SYS     ICN1    SYS     SYS     SYS     SYS     SYS     SYS     X       ICN2    ICN1    ICN2    ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     48-95,144-191
2-3
 PPU9    ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     ICN2    X       ICN2    ICN1    SYS     ICN1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     48-95,144-191
2-3
 PPU10   SYS     SYS     SYS     ICN1    SYS     SYS     SYS     SYS     ICN1    ICN2    X       ICN1    SYS     SYS     ICN2    SYS     SYS     SYS     SYS     SYS     PIX     SYS     48-95,144-191
2-3
 PPU11   SYS     SYS     ICN1    SYS     SYS     SYS     SYS     SYS     ICN2    ICN1    ICN1    X       SYS     SYS     SYS     ICN2    SYS     SYS     SYS     SYS     PIX     SYS     48-95,144-191
2-3
 PPU12   SYS     SYS     SYS     SYS     SYS     ICN1    SYS     SYS     ICN1    SYS     SYS     SYS     X       ICN2    ICN1    ICN2    SYS     SYS     SYS     SYS     SYS     SYS     0-47,96-143
0-1
 PPU13   SYS     SYS     SYS     SYS     ICN1    SYS     SYS     SYS     SYS     ICN1    SYS     SYS     ICN2    X       ICN2    ICN1    SYS     SYS     SYS     SYS     SYS     SYS     0-47,96-143
0-1
 PPU14   SYS     SYS     SYS     SYS     SYS     SYS     SYS     ICN1    SYS     SYS     ICN2    SYS     ICN1    ICN2    X       ICN1    SYS     SYS     PIX     SYS     SYS     SYS     0-47,96-143
0-1
 PPU15   SYS     SYS     SYS     SYS     SYS     SYS     ICN1    SYS     SYS     SYS     SYS     ICN2    ICN2    ICN1    ICN1    X       SYS     SYS     PIX     SYS     SYS     SYS     0-47,96-143
0-1
 NIC0    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     X       SYS     SYS     SYS     SYS     SYS     48-95,144-191
2-3
 NIC1    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     X       SYS     SYS     SYS     SYS     0-47,96-143
0-1
 NIC2    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     PIX     PIX     SYS     SYS     X       SYS     SYS     SYS     0-47,96-143
0-1
 NIC3    SYS     SYS     SYS     SYS     SYS     SYS     PIX     PIX     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     X       SYS     SYS     0-47,96-143
0-1
 NIC4    SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     PIX     PIX     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     X       SYS     48-95,144-191
2-3
 NIC5    SYS     SYS     PIX     PIX     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     SYS     X       48-95,144-191
2-3

Legend:

  X    = Self
  SYS  = Connection traversing PCIe as well as the SMP interconnect between NUMA nodes (e.g., QPI/UPI)
  NODE = Connection traversing PCIe as well as the interconnect between PCIe Host Bridges within a NUMA node
  PHB  = Connection traversing PCIe as well as a PCIe Host Bridge (typically the CPU)
  PXB  = Connection traversing multiple PCIe bridges (without traversing the PCIe Host Bridge)
  PIX  = Connection traversing at most a single PCIe bridge
  ICN# = Connection traversing a bonded set of # ICN links

NIC Legend:

  NIC0: mlx5_bond_0
  NIC1: mlx5_bond_1
  NIC2: mlx5_bond_2
  NIC3: mlx5_bond_3
  NIC4: mlx5_bond_4
  NIC5: mlx5_bond_5

PPU Rear Group:

  Rear ID 0: PPU 0,1,2,3,4,5,6,7
  Rear ID 1: PPU 8,9,10,11,12,13,14,15
Например, в случае соединения через NVSwitch графические процессоры NVIDIA внутри узла связаны по принципу «все-со-всеми». В случае TPU — каждое устройство связано с соседом, и вместе они образуют многомерные кольца. Выглядит это примерно так:
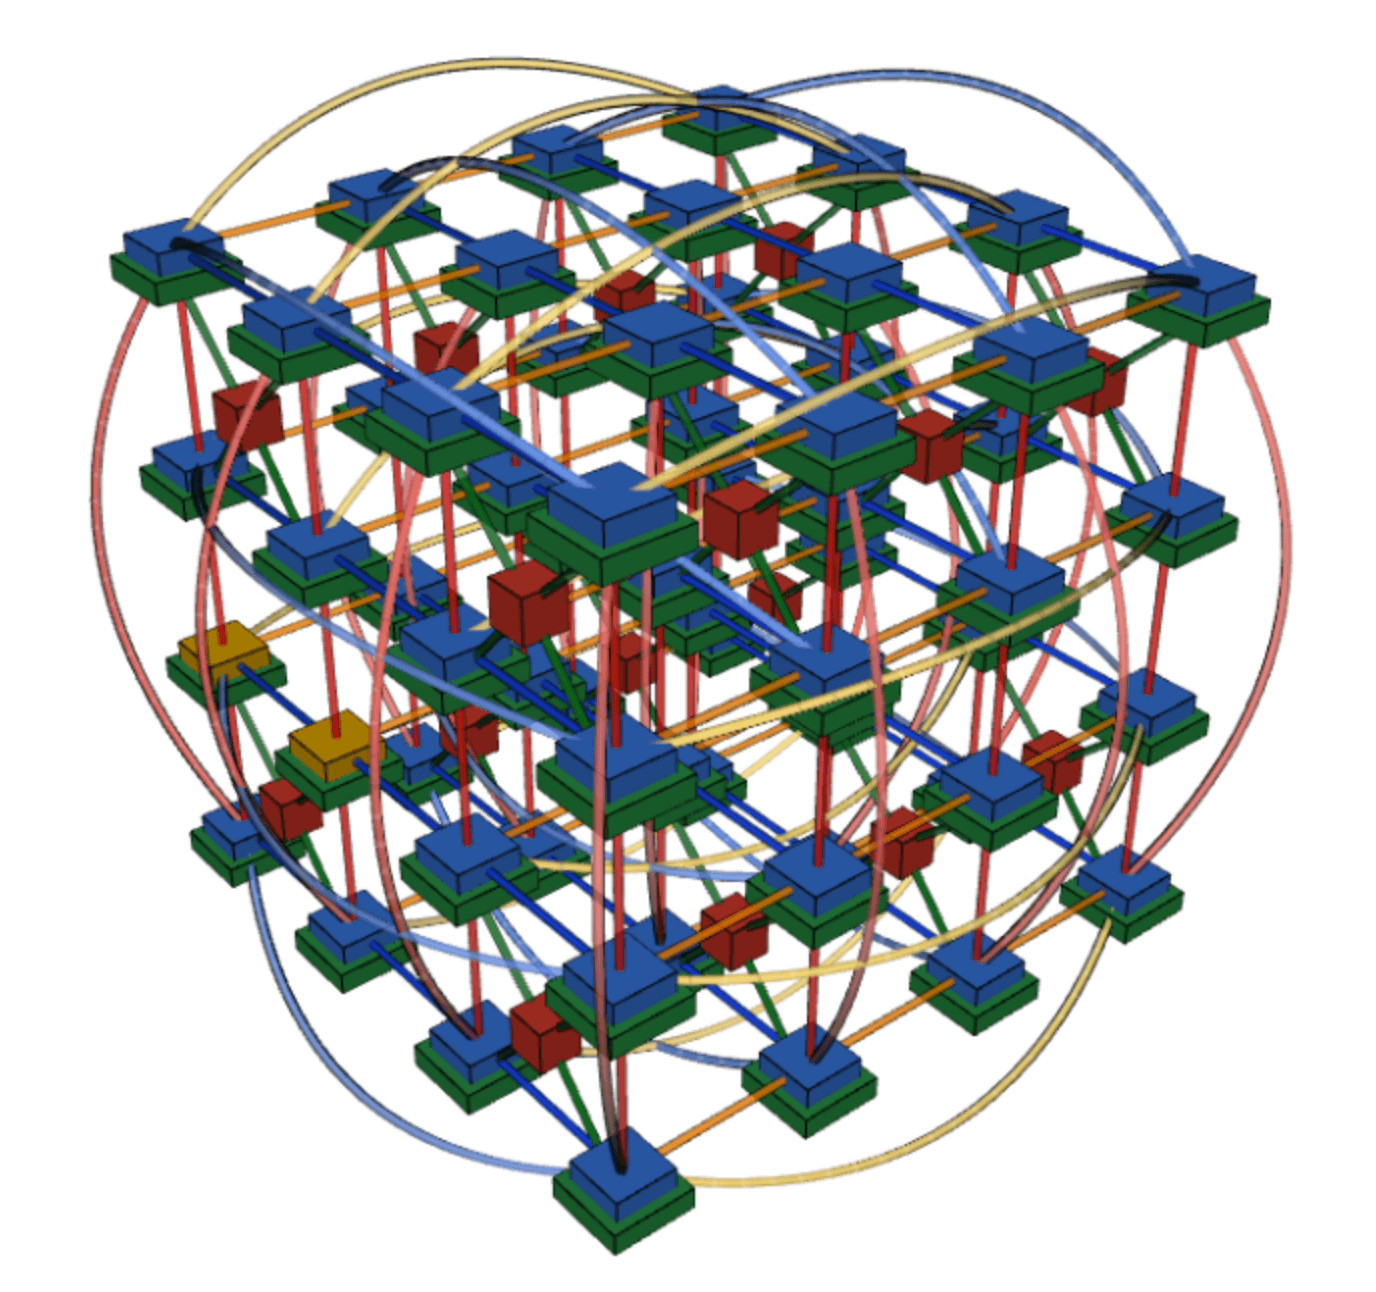
Каждый Zhenwu 810E имеет семь физических ICN-линий. В зависимости от расположения пары ускорителей между ними может быть задействован один ICN-линк (ICN1), два объединенных линка (ICN2), либо обмен идет через системные PCIe (SYS).
Маркетинговая картинка, похоже, пытается отразить эти связи на скриншоте:
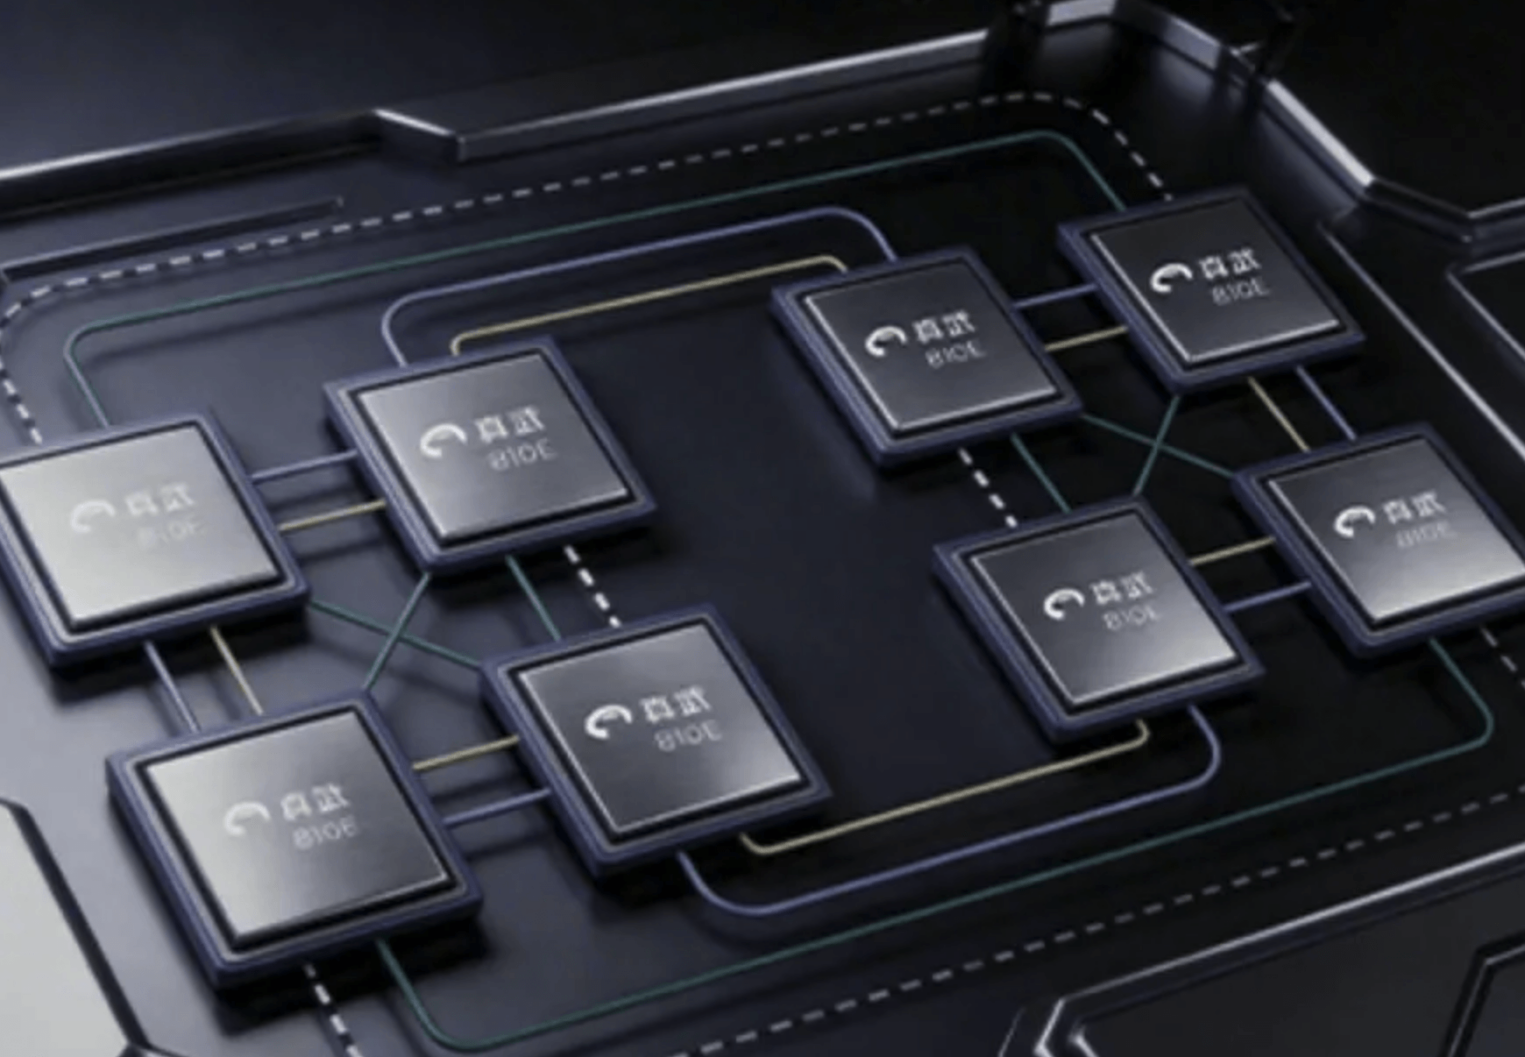
При этом восемь PPU образуют группу со своим оптимальным порядком взаимодействия между собой.
       Rear ID 0: PPU 0,1,2,3,4,5,6,7
 Rear ID 1: PPU 8,9,10,11,12,13,14,15
Этот порядок важно учитывать и прокидывать в переменной CUDA_VISIBLE_DEVICES при инференсе модели на нескольких картах. Для облачного K8s разработана библиотека ACCL (аналог NCCL). В ее документации можно встретить такую ремарку про порядок взаимодействия PPU:
      However, the PPU Inter-Connect Network (ICN) uses a non-fully connected topology. To achieve maximum performance with specific parallel strategies, manually configure the environment variables as needed. The core of this optimization is to allocate more ICN links to high-latency Communication Groups and reduce link sharing and contention between them. This improves the overall efficiency of interconnect communication.

# For TP=2:
export CUDA_VISIBLE_DEVICES=4,7,5,6,1,2,0,3,12,15,13,14,9,10,8,11
# For TP=4:
export CUDA_VISIBLE_DEVICES=4,5,7,6,0,1,3,2,9,8,10,11,13,12,14,15
# For TP=8:
export CUDA_VISIBLE_DEVICES=4,5,7,6,2,3,1,0,13,12,14,15,11,10,8,9
# No configuration needed for TP=1 or TP=16.
И хотя тут речь про связку Kubernetes + PPU и ACCL-библиотеки, для PCCL-библиотеки (тоже аналог NCCL) порядок также важен для оптимального интерконнекта.
Каждый ICN имеет пропускную способность примерно 53 ГБ/с.
      root@ali117196 ~]# ppu-smi icn -s
PPU 0: PPU-ZW810E (UUID: GPU-01de0211-0952-030e-0000-000060d7d05f)
    Link 0: 53 GB/s
    Link 1: 53 GB/s
    Link 2: 53 GB/s
    Link 3: 53 GB/s
    Link 4: 53 GB/s
    Link 5: 53 GB/s
    Link 6: 53 GB/s
PPU 1: PPU-ZW810E (UUID: GPU-019e2226-0480-0030-0000-000040937a19)
    Link 0: 53 GB/s
    Link 1: 53 GB/s
    Link 2: 53 GB/s
    Link 3: 53 GB/s
    Link 4: 53 GB/s
    Link 5: 53 GB/s
    Link 6: 53 GB/s
...
...
...
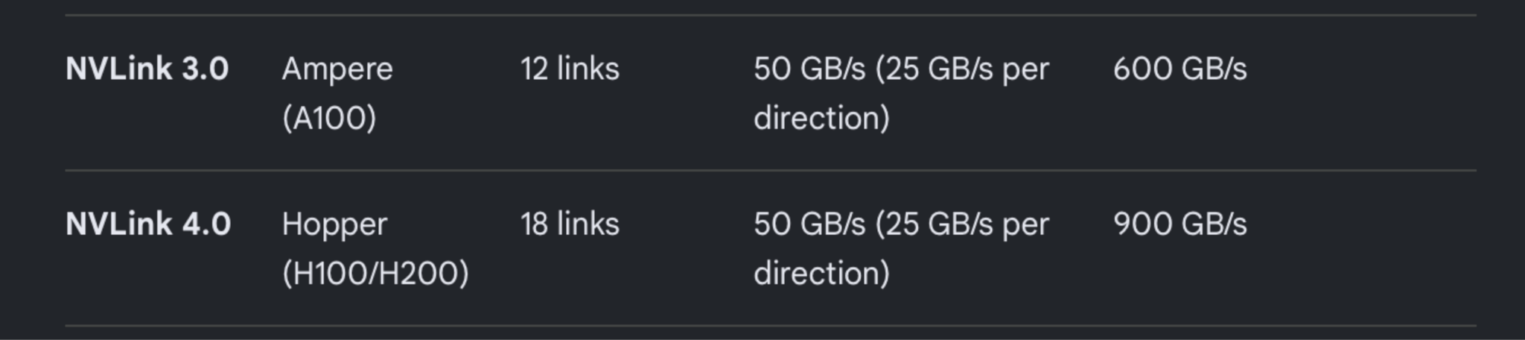
В документации не удалось найти, в одном или двух направлениях заявлено это значение, но вот у NVLink третьего и четвертого поколений (карты A100 и H100) пропускная способность одного линка — 50 ГБ/с в два направления.
Тесты интерконнектов ICN
Далее были попытки протестировать интерконнект по аналогии с nccl_perf_tests.
Зачем вообще эти тесты проводить? Дело в том, что при инференсе моделей на нескольких ускорителях вычисления одного прохода сквозь сеть нужно синхронизировать между устройствами, обменяться промежуточными результатами или переслать токены между экспертами. Для этого существуют алгоритмы коллективных коммуникаций, а с помощью тестов NCCL (или PCCL в данном случае) можно зафиксировать значения пропускной способности таких взаимодействий.
В собранном образе PPU SDK нашлись скрипты, похожие по назначению на NCCL-тесты:
      cd /usr/local/PPU_SDK/comm_tools/multi_process

ls
# all_reduce_perf
# alltoall_perf
# ...
Для типичных TP-сценариев критичны такие алгоритмы коммуникации, как AllReduce, AllGather и ReduceScatter, тогда как для экспертного параллелизма в моделях MoE важнее AlltoAll. В рамках нашего тестирования мы сфокусировались на операциях AllReduce и AlltoAll.
Попытка сразу запустить тест по аналогии с nccl-tests сразу завершилась ошибкой:
      root@ali117196:/usr/local/PPU_SDK/comm_tools/multi_process# CUDA_VISIBLE_DEVICES=4,5,7,6,2,3,1,0 ./all_reduce_perf -b 8M -e 1G -f 2 -g 8
# nThread 1 nGpus 8 minBytes 8388608 maxBytes 1073741824 offset <0>/<0> step: 2(factor) warmup iters: 5 iters: 20 validation: 1 single_test: 0 test_buffer_kind: both elapsed_type: cpu_time average: MIN register: 0
#
# Using devices
#   Rank  0 Group  0 Pid     168 on  ali117196 device  0 [0xc9] PPU-ZW810E
#   Rank  1 Group  0 Pid     168 on  ali117196 device  1 [0xc8] PPU-ZW810E
#   Rank  2 Group  0 Pid     168 on  ali117196 device  2 [0x80] PPU-ZW810E
#   Rank  3 Group  0 Pid     168 on  ali117196 device  3 [0xc7] PPU-ZW810E
#   Rank  4 Group  0 Pid     168 on  ali117196 device  4 [0x7f] PPU-ZW810E
#   Rank  5 Group  0 Pid     168 on  ali117196 device  5 [0x7e] PPU-ZW810E
#   Rank  6 Group  0 Pid     168 on  ali117196 device  6 [0xc6] PPU-ZW810E
#   Rank  7 Group  0 Pid     168 on  ali117196 device  7 [0x81] PPU-ZW810E

[ali117196][168:168][7][bootstrap.cc:93] NCCL ERROR Bootstrap : no socket interface found

[ali117196][168:168][7][net.cc:279] NCCL WARN net.cc:279 -> 3

[ali117196][168:168][7][init.cc:385] NCCL WARN init.cc:385 -> 3

[ali117196][168:168][7][init.cc:411] NCCL WARN init.cc:411 -> 3
ali117196: Test PCCL failure common.cu:1455 'internal error'
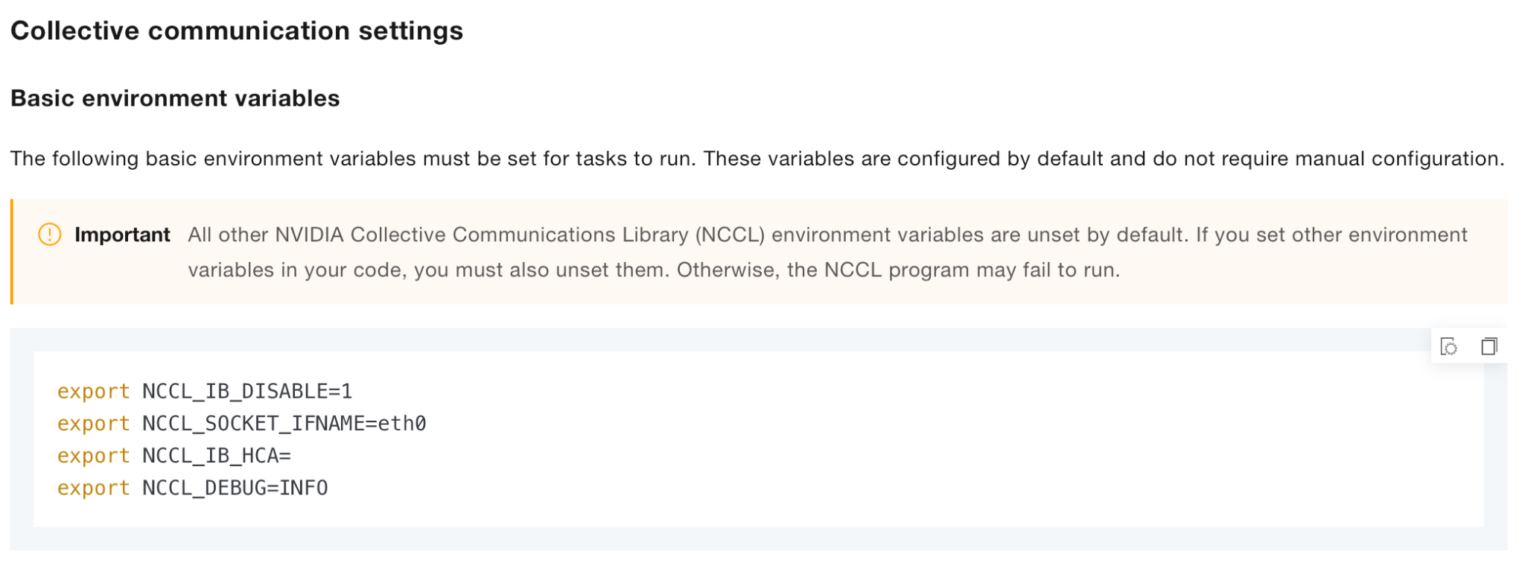
PCCL требовался сетевой интерфейс для инициализации и обмена служебной информацией. В моем случае это лечилось экспортом нужных env-переменных:
      export NCCL_SOCKET_IFNAME=lo
export NCCL_SOCKET_FAMILY=AF_INET
export NCCL_DEBUG=INFO
В документации вендора указано, какие переменные установлены по дефолту:
Первым тестом хотелось проверить базовый интерконнект разных типов соединений, указанных в матрице топологии ppu-smi topo между двумя PPU. Использовался AllReduce-тест с данными до 1 ГБ.
ICN2 для пары PPU0-PPU1
      CUDA_VISIBLE_DEVICES=0,1 \
./all_reduce_perf -b 4096 -e 1G -f 2 -w 10 -n 50 -g 2
Весь лог публиковать не буду, покажу только последние пять значений.
      size         time(us)    algbw     busbw
134217728     1544.41     86.91     86.91
268435456     3042.48     88.23     88.23
536870912     6034.78     88.96     88.96
1073741824   12014.10     89.37     89.37

# Out of bounds values : 0 OK
Получилось около 89,4 ГБ/с.
ICN1 для пары PPU0-PPU2
      CUDA_VISIBLE_DEVICES=0,2 \
./all_reduce_perf -b 4096 -e 1G -f 2 -w 10 -n 50 -g 2
      size         time(us)    algbw     busbw
134217728     3105.61     43.22     43.22
268435456     6136.45     43.74     43.74
536870912    12316.80     43.59     43.59
1073741824   24422.60     43.97     43.97

# Out of bounds values : 0 OK
Ожидаемо почти в два раза медленнее — около 44 ГБ/с.
SYS для пары PPU0-PPU5 без ICN
      CUDA_VISIBLE_DEVICES=0,5 \
./all_reduce_perf -b 4096 -e 1G -f 2 -w 10 -n 50 -g 2
      size         time(us)    algbw     busbw
134217728     9361.68     14.34     14.34
268435456    18748.80     14.32     14.32
536870912    37565.10     14.29     14.29
1073741824   75348.60     14.25     14.25

# Out of bounds values : 0 OK
Получилось около 14,3 ГБ/с.
Ранее я ссылался на информацию, что при инференсе на нескольких PPU очень важна топология размещения ускорителей — вот получили наглядное подтверждение. Если PPU подобраны не из одной локальной группы, то задержки при инференсе могут существенно вырасти.
Далее от пары PPU перейдем к тесту AllReduce между группой из восьми PPU одной ICN-группы.
      CUDA_VISIBLE_DEVICES=4,5,7,6,2,3,1,0 \
./all_reduce_perf -b 4096 -e 1G  -f 2  -w 10  -n 50  -g 8
      size            time(us)   algbw      busbw
67108864        560.70     119.69    209.45
134217728       1033.72    129.84    227.22
268435456       1957.16    137.16    240.02
536870912       3879.98    138.37    242.15
1073741824      7705.49    139.35    243.86
В сценарии AllReduce для восьми PPU общая нормализованная оценка эффективности коммуникационного слоя составляет 244 ГБ/с.
Для MoE-сценария используется другой алгоритм коммуникации — AlltoAll. Тут тест выполнялся на всех доступных 16 PPU.
./alltoall_perf -b 4096 -e 1G -f 2 -w 10 -n 50 -g 16
      size         time(us)    algbw     busbw
33554432       449.19     74.70     70.03
67108864       862.86     77.78     72.91
134217728     1690.93     79.38     74.41
268435456     3346.55     80.21     75.20
536870912     6674.53     80.44     75.41
1073741824   13376.00     80.27     75.26
На 16 PPU нормализованная оценка эффективности коммуникационного слоя составляет 75 ГБ/с.
Полученные результаты пропускной способности коммуникационного слоя мы оставим для сравнения с другим железом, а далее перейдем к более привычным бенчмаркам моделей.
Попытки стартовать инференс
Далее нам нужно было запустить, наконец, какую-то доступную модель. Напомню, целевой способ использования сервера планируется в составе Kubernetes, поэтому инференс необходимо было запустить в подготовленных контейнерных образах с PPU SDK.
В документации к Alibaba Cloud PPU Service образы указаны с учетом реджистри Alibaba Cloud, но, к счастью, существует возможность скачать их из глобального и доступного без регистрации реджистри:
egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/inference-xpu-pytorch:26.04-v2.1.0-vllm0.23.0-torch2.10-cu130-20260710
И вот после скачивания образа возник вопрос о том, как именно прокидывать PPU в запущенный контейнер. В случае с NVIDIA GPU мы устанавливаем прослойку — nvidia-container-toolkit и через нее прокидываем GPU в Docker-контейнеры. Для PPU такой прослойки нет, и нужно прокидывать каждое устройство как девайс.
Список девайсов смотрим в /dev.
      ls /dev

alixpu
alixpu-caps
alixpu-caps-imex-channels
alixpu_ctl
alixpu_ppu0
alixpu_ppu1
alixpu_ppu10
alixpu_ppu11
alixpu_ppu12
alixpu_ppu13
alixpu_ppu14
alixpu_ppu15
alixpu_ppu2
alixpu_ppu3
alixpu_ppu4
alixpu_ppu5
alixpu_ppu6
alixpu_ppu7
alixpu_ppu8
alixpu_ppu9
alixpu_sep
А далее прокидываем устройства через параметр --device и видим внутри контейнера только то, что прокинули.
      [root@ali117196 ~]# nerdctl run -it --device=/dev/alixpu_ppu0 --device=/dev/alixpu --device=/dev/alixpu_ctl egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/inference-xpu-pytorch:25.03-v1.4.3-hotfix-vllm0.7.3-torch2.5-cu123-20250331 -- bash
=================================
PPU SDK Version:    v1.4.3-hotfix
CUDA Wrapper:       cuda-12.3
PyTorch Version:    2.5.1
NGC Version:        pytorch:-py3
Python Version:     Python 3.10.13
=================================
Setup environment for CUDA
[INFO] Get Dockerfile at /Dockerfile
Driver Version                              : 1.6.3-8ee7e7
HGGC Version                                : 11.1
SDK Version                                 : 1.4.3-15e77a
PPU 00000001:C9:00.0
    VBIOS Version                           : 1.6.12-af69f0
[WARNING] shm-size 64M(docker default value) which may be not enough, add --shm-size=4g or bigger depend on your model
Внутри контейнера виден прокинутый девайс:
root@8d535cca6772:/workspace/pytorch# ppu-smi
Tue Aug 18 22:58:22 2026
+-------------------------------------------------------------------------------+
| PPU-SMI 1.13          Driver Version: 1.6.3-8ee7e7  HGGC Version: 11.1        |
+---------------------------------+----------------------+----------------------+
| PPU  Name        Persistence M. | Bus-Id               | Volatile Uncorr. ECC |
| Fan  Temp  Perf   Pwr:Usage/Cap | Memory-Usage         | PPU-Util  Compute M. |
|                                 |                      |               MIG M. |
+=================================+======================+======================+
| 0  PPU-ZW810E        N/A        | 00000001:C9:00.0     |                    0 |
| N/A  31C   N/A       90W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+

+-------------------------------------------------------------------------------+
| Processes:                                                                    |
| PPU    GI   CI   PID      Type  Process name                       PPU Memory |
|        ID   ID                                                     Usage      |
+===============================================================================+
| No running processes found                                                    |
+-------------------------------------------------------------------------------+
Есть небезопасный способ запускать контейнер через privileged-режим — так мы можем увидеть в контейнере все доступные на хосте PPU-устройства.
[root@ali117196 ~]# nerdctl run -it --privileged egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/inference-xpu-pytorch:25.03-v1.4.3-hotfix-vllm0.7.3-torch2.5-cu123-20250331 -- bash
=================================
PPU SDK Version:    v1.4.3-hotfix
CUDA Wrapper:       cuda-12.3
PyTorch Version:    2.5.1
NGC Version:        pytorch:-py3
Python Version:     Python 3.10.13
=================================
Setup environment for CUDA
[INFO] Get Dockerfile at /Dockerfile
Driver Version                              : 1.6.3-8ee7e7
HGGC Version                                : 11.1
SDK Version                                 : 1.4.3-15e77a
PPU 00000001:C9:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000001:C8:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000001:80:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000001:81:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000000:7E:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000000:7F:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000000:C7:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000000:C6:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000001:A5:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000001:A4:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000001:0A:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000001:0B:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000000:08:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000000:09:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000000:A3:00.0
    VBIOS Version                           : 1.6.12-af69f0
PPU 00000000:A2:00.0
    VBIOS Version                           : 1.6.12-af69f0
[WARNING] shm-size 64M(docker default value) which may be not enough, add --shm-size=4g or bigger depend on your model
root@813f06d4156e:/workspace/pytorch# nvidia-smi
Tue Aug 18 23:03:12 2026
+-------------------------------------------------------------------------------+
| PPU-SMI 1.13          Driver Version: 1.6.3-8ee7e7  HGGC Version: 11.1        |
+---------------------------------+----------------------+----------------------+
| PPU  Name        Persistence M. | Bus-Id               | Volatile Uncorr. ECC |
| Fan  Temp  Perf   Pwr:Usage/Cap | Memory-Usage         | PPU-Util  Compute M. |
|                                 |                      |               MIG M. |
+=================================+======================+======================+
| 0  PPU-ZW810E        N/A        | 00000001:C9:00.0     |                    0 |
| N/A  31C   N/A       90W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 1  PPU-ZW810E        N/A        | 00000001:C8:00.0     |                    0 |
| N/A  33C   N/A       86W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 2  PPU-ZW810E        N/A        | 00000001:80:00.0     |                    0 |
| N/A  29C   N/A       87W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 3  PPU-ZW810E        N/A        | 00000001:81:00.0     |                    0 |
| N/A  28C   N/A       91W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 4  PPU-ZW810E        N/A        | 00000000:7E:00.0     |                    0 |
| N/A  26C   N/A       90W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 5  PPU-ZW810E        N/A        | 00000000:7F:00.0     |                    0 |
| N/A  29C   N/A       87W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 6  PPU-ZW810E        N/A        | 00000000:C7:00.0     |                    0 |
| N/A  30C   N/A       89W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 7  PPU-ZW810E        N/A        | 00000000:C6:00.0     |                    0 |
| N/A  30C   N/A       85W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 8  PPU-ZW810E        N/A        | 00000001:A5:00.0     |                    0 |
| N/A  32C   N/A       88W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 9  PPU-ZW810E        N/A        | 00000001:A4:00.0     |                    0 |
| N/A  32C   N/A       89W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 10  PPU-ZW810E        N/A       | 00000001:0A:00.0     |                    0 |
| N/A  30C   N/A       89W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 11  PPU-ZW810E        N/A       | 00000001:0B:00.0     |                    0 |
| N/A  27C   N/A       86W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 12  PPU-ZW810E        N/A       | 00000000:08:00.0     |                    0 |
| N/A  28C   N/A       87W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 13  PPU-ZW810E        N/A       | 00000000:09:00.0     |                    0 |
| N/A  30C   N/A       86W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 14  PPU-ZW810E        N/A       | 00000000:A3:00.0     |                    0 |
| N/A  33C   N/A       88W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+
| 15  PPU-ZW810E        N/A       | 00000000:A2:00.0     |                    0 |
| N/A  32C   N/A       89W / 400W | 3MiB / 98304MiB      |   0%        Default  |
|                                 |                      |             Disabled |
+---------------------------------+----------------------+----------------------+

+-------------------------------------------------------------------------------+
| Processes:                                                                    |
| PPU    GI   CI   PID      Type  Process name                       PPU Memory |
|        ID   ID                                                     Usage      |
+===============================================================================+
| No running processes found                                                    |
+-------------------------------------------------------------------------------+
Стандартная проверка CUDA-вызовов и определения устройств из torch работает:
      root@813f06d4156e:/workspace/pytorch#  python
Python 3.10.13 (main, Mar 24 2025, 13:57:47) [GCC 11.4.0] on linux
Type "help", "copyright", "credits" or "license" for more information.
>>> import torch
>>> print("torch",torch.__version__)
torch 2.5.1
>>> print("cuda is available?",torch.cuda.is_available())
cuda is available? True
>>> print("device count", torch.cuda.device_count())
device count 16
В процессе попыток запуска контейнера возникало множество мелких, но поправимых багов вроде жестких ссылок и заранее определенных переменных, направленных на китайские ресурсы и зеркала. Жить можно, но нужно про это помнить.
После базовых тестов с контейнерами приступили к тестам моделей.
Тест DeepSeek-v4-Flash-0731-w8a8 (TP = 8)
В нашей команде при тестах новых моделей или железа мы используем стандартизированные профили нагрузки: так мы примерно понимаем, какой перформанс можно ожидать от модели и железа в различных сценариях. Мы определяем количество input-/output-токенов контекста и ступенчато поднимаем значение concurrency.
Для PPU и доступных моделей использовались три типовых сценария:
- Chat: соотношение 1024/512 токенов — это наш бейзлайн;
- RAG: соотношение 32k/1024 токенов — тяжелый prefill-сценарий;
- Batch: соотношение 8k/8k токенов — упор на тяжелый decode-сценарий.
Мы оцениваем метрики по медианным значениям, а для анализа «хвостов» распределения отдельно выводим 99-й перцентиль — это позволяет получить более наглядную картину происходящего.
Запустить на всех 16 PPU DeepSeek-v4-Flash-0731 не удалось — проблема связана с расчетом конфигурации vLLM для этой архитектуры. Удалось запустить только на восьми PPU:
nerdctl run -it --privileged -p 8000:8000 -v /bmcp_lvm_fs/weights:/weights egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/inference-xpu-pytorch:26.04-v2.1.0-vllm0.23.0-torch2.10-cu130-20260710 -- vllm serve /weights/deepseek --host 0.0.0.0 --port 8000 --tensor-parallel-size 8 --trust-remote-code --tool-call-parser deepseek_v4 --trust-remote-code --block-size 256 --served-model-name DeepSeek-V4-Flash-0731 --tokenizer-mode deepseek_v4 --reasoning-parser deepseek_v4 --enable-prefix-caching --enable-auto-tool-choice
Результаты получились следующие.
Chat-профиль — input 1024 / output 512:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50, s |
| 8 | 0.83 | 424.88 | 1274.64 | 774.89 | 924.53 | 17.20 | 20.72 | 17.16 | 49.18 | 9.56 |
| 16 | 1.29 | 659.04 | 1977.13 | 806.10 | 1254.69 | 22.65 | 25.19 | 19.85 | 60.08 | 12.38 |
| 32 | 1.78 | 893.16 | 2679.47 | 1260.78 | 2269.00 | 32.59 | 36.64 | 26.42 | 297.19 | 17.91 |
| 64 | 2.27 | 1159.61 | 3478.82 | 1282.25 | 4371.09 | 52.42 | 56.45 | 36.10 | 626.39 | 28.07 |
| 128 | 2.78 | 1423.99 | 4271.98 | 2016.53 | 9974.66 | 85.36 | 90.93 | 51.65 | 695.35 | 45.64 |
| 200 | 3.03 | 1549.99 | 4649.96 | 2105.21 | 16219.64 | 124.66 | 130.32 | 68.41 | 704.41 | 65.81 |
RAG-профиль — input 32000 / output 1024:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50, s |
| 8 | 0.17 | 170.38 | 5495.42 | 9732.87 | 25328.15 | 36.93 | 42.93 | 16.64 | 880.66 | 47.51 |
| 16 | 0.20 | 205.61 | 6631.78 | 9755.73 | 53255.65 | 66.41 | 72.35 | 22.62 | 934.93 | 77.69 |
| 32 | 0.22 | 229.16 | 7391.21 | 8073.62 | 105863.73 | 129.39 | 133.85 | 31.48 | 963.38 | 140.44 |
| 64 | 0.24 | 246.59 | 7953.47 | 8110.17 | 216192.78 | 245.58 | 248.55 | 48.29 | 980.98 | 259.34 |
| 128 | 0.25 | 256.12 | 8260.72 | 9920.58 | 343338.69 | 373.63 | 377.19 | 62.93 | 1002.25 | 392.14 |
Batch-профиль — input 8000 / output 8000:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50, s |
| 8 | 0.05 | 402.72 | 805.64 | 3030.07 | 4888.42 | 19.51 | 20.02 | 18.76 | 37.38 | 159.09 |
| 16 | 0.08 | 666.42 | 1333.17 | 3105.28 | 10945.77 | 22.97 | 22.35 | 21.26 | 42.62 | 186.64 |
| 32 | 0.12 | 920.59 | 1841.65 | 3117.59 | 23389.97 | 32.46 | 32.88 | 28.78 | 57.60 | 262.77 |
| 64 | 0.16 | 1241.58 | 2483.78 | 3134.78 | 47682.74 | 46.69 | 46.97 | 39.28 | 87.49 | 376.61 |
| 128 | 0.20 | 1589.40 | 3179.60 | 22254.10 | 98019.58 | 70.69 | 72.88 | 61.48 | 774.03 | 587.7 |
| 200 | 0.25 | 1983.44 | 3967.87 | 77924.09 | 154652.57 | 90.61 | 99.22 | 81.58 | 785.40 | 802.71 |
Тест DeepSeek-v4-Flash-0731-w8a8 (TP = 8, DP = 2)
Следующим этапом была попытка все-таки задействовать все PPU на сервере. Модель развернута с настройками TP = 8 и DP = 2: внутри vLLM поднимаются два инстанса модели, каждая модель — на своей Rear-группе, при этом веса дублируются для каждого инстанса.
nerdctl run -d --name deepseek-dp2 --privileged -p 8000:8000 --ipc host -e NCCL_SOCKET_IFNAME=lo -e NCCL_SOCKET_FAMILY=AF_INET -e CUDA_VISIBLE_DEVICES=0,1,2,6,5,4,7,3,9,8,11,15,12,13,14,10 -e NCCL_DEBUG=INFO -v /bmcp_lvm_fs/weights:/weights egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/inference-xpu-pytorch:26.04-v2.1.0-vllm0.23.0-torch2.10-cu130-20260710 vllm serve /weights/deepest --host 0.0.0.0 --port 8000 --tensor-parallel-size 8 --data-parallel-size 2 --api-server-count 1 --trust-remote-code --tool-call-parser deepseek_v4 --block-size 256 --served-model-name DeepSeek-V4-Flash-0731 --tokenizer-mode deepseek_v4 --reasoning-parser deepseek_v4 --enable-prefix-caching --enable-auto-tool-choice
Chat-профиль — input 1024 / output 512:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50, s |
| 8 | 0.40 | 204.43 | 614.89 | 585.31 | 30441.69 | 33.18 | 45.61 | 32.61 | 66.62 | 17.54 |
| 16 | 0.82 | 421.7 | 1268.50 | 588.36 | 1622.51 | 34.78 | 43.43 | 33.39 | 72.05 | 18.36 |
| 32 | 1.27 | 651.36 | 1959.16 | 922.80 | 11111.10 | 35.81 | 51.26 | 33.14 | 70.81 | 19.22 |
| 64 | 2.34 | 1198.35 | 3604.42 | 598.80 | 3888.74 | 44.75 | 46.54 | 36.77 | 85.69 | 23.47 |
| 128 | 3.46 | 1772.74 | 5332.06 | 9922.66 | 9943.59 | 54.05 | 62.01 | 36.51 | 79.77 | 37.54 |
| 200 | 4.44 | 2271.28 | 6831.59 | 2243.70 | 2310.39 | 83.75 | 86.85 | 45.34 | 140.94 | 45.04 |
RAG-профиль — input 32000 / output 1024:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50, s |
| 8 | 0.15 | 154.15 | 4971.87 | 9428.09 | 15486.22 | 42.34 | 51.69 | 32.40 | 678.93 | 52.74 |
| 16 | 0.23 | 231.28 | 7459.73 | 10477.13 | 35403.48 | 56.29 | 65.38 | 32.48 | 1049.86 | 68.06 |
| 32 | 0.30 | 309.07 | 9968.70 | 10547.06 | 70376.56 | 88.09 | 98.98 | 32.89 | 1088.70 | 100.86 |
| 64 | 0.33 | 341.41 | 11011.86 | 11085.03 | 171970.61 | 156.24 | 195.07 | 36.41 | 1104.02 | 170.92 |
| 128 | 0.35 | 358.76 | 11571.30 | 61363.78 | 319504.48 | 290.26 | 363.80 | 46.59 | 2127.90 | 358.30 |
| 200 | 0.34 | 345.90 | 11156.70 | 211045.88 | 500653.61 | 352.76 | 529.64 | 61.71 | 4571.02 | 571.92 |
Batch-профиль — input 8000 / output 8000:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50, s |
| 8 | 0.03 | 239.88 | 479.88 | 2664.73 | 4117.08 | 33.08 | 33.70 | 32.33 | 64.47 | 267.27 |
| 16 | 0.06 | 455.60 | 911.42 | 2841.76 | 7376.09 | 33.45 | 34.25 | 32.86 | 65.93 | 270.41 |
| 32 | 0.10 | 785.25 | 1570.90 | 3700.71 | 14680.93 | 36.77 | 37.39 | 35.29 | 70.72 | 297.82 |
| 64 | 0.16 | 1283.54 | 2567.72 | 4458.39 | 35348.15 | 40.36 | 40.85 | 36.56 | 73.27 | 327.30 |
| 128 | 0.27 | 2138.02 | 4277.11 | 14419.98 | 58887.38 | 50.78 | 52.03 | 41.82 | 100.73 | 420.61 |
| 200 | 0.37 | 2973.57 | 5948.62 | 46438.41 | 91203.03 | 61.22 | 66.50 | 54.04 | 109.97 | 536.14 |
Если сравнить результаты, то в этом эксперименте эффект от data parallelism появляется при большом батче. По графикам видно, что примерно с concurrency от 64 второй инстанс модели начинает влиять на метрики производительности. Возможно, два независимых инстанса с роутером перед ними будут давать совершенно другой перформанс, но такую гипотезу проверить не удалось.
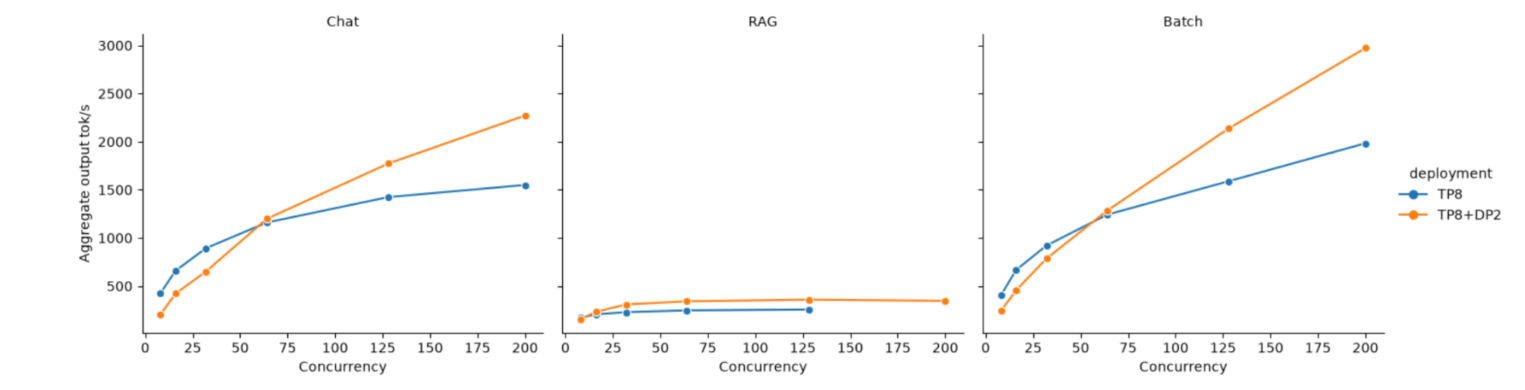
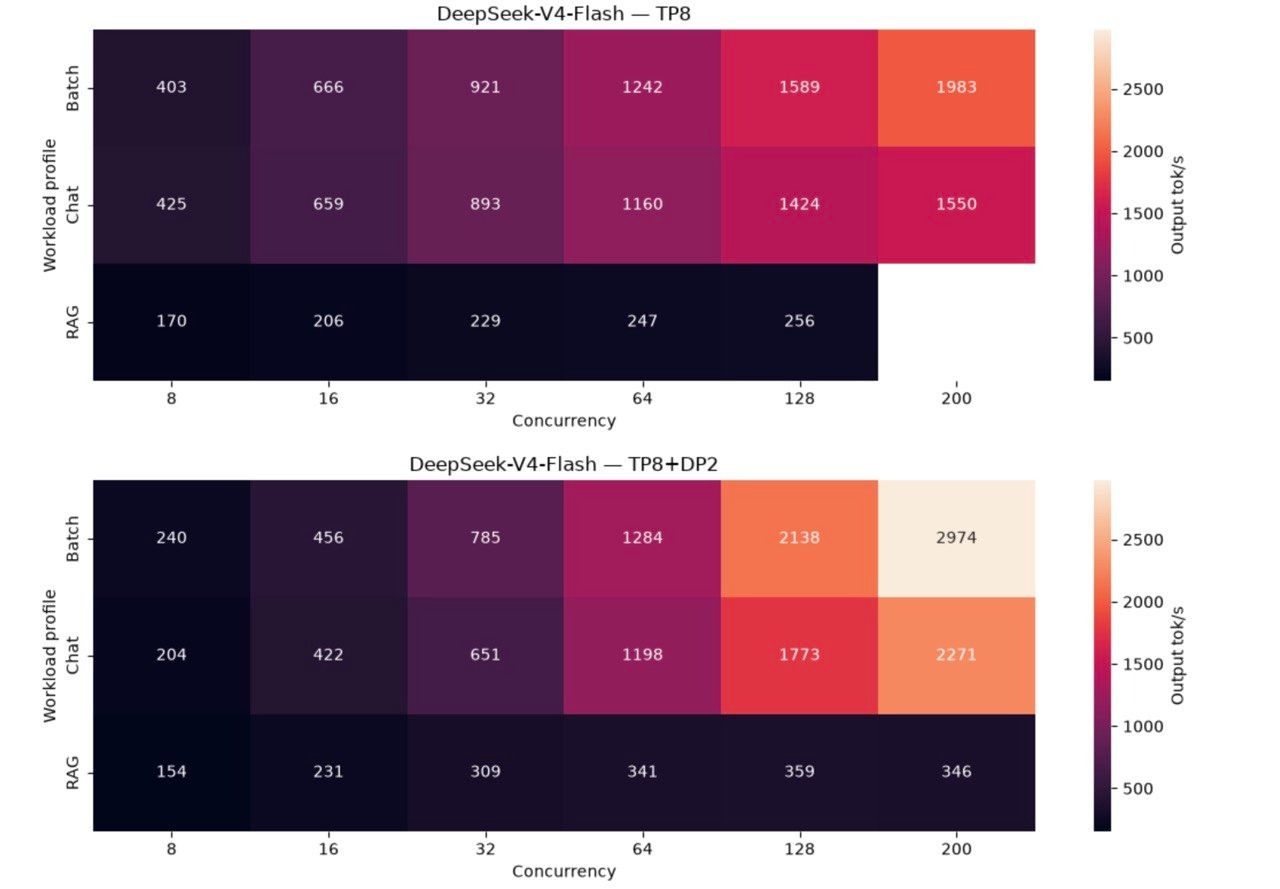
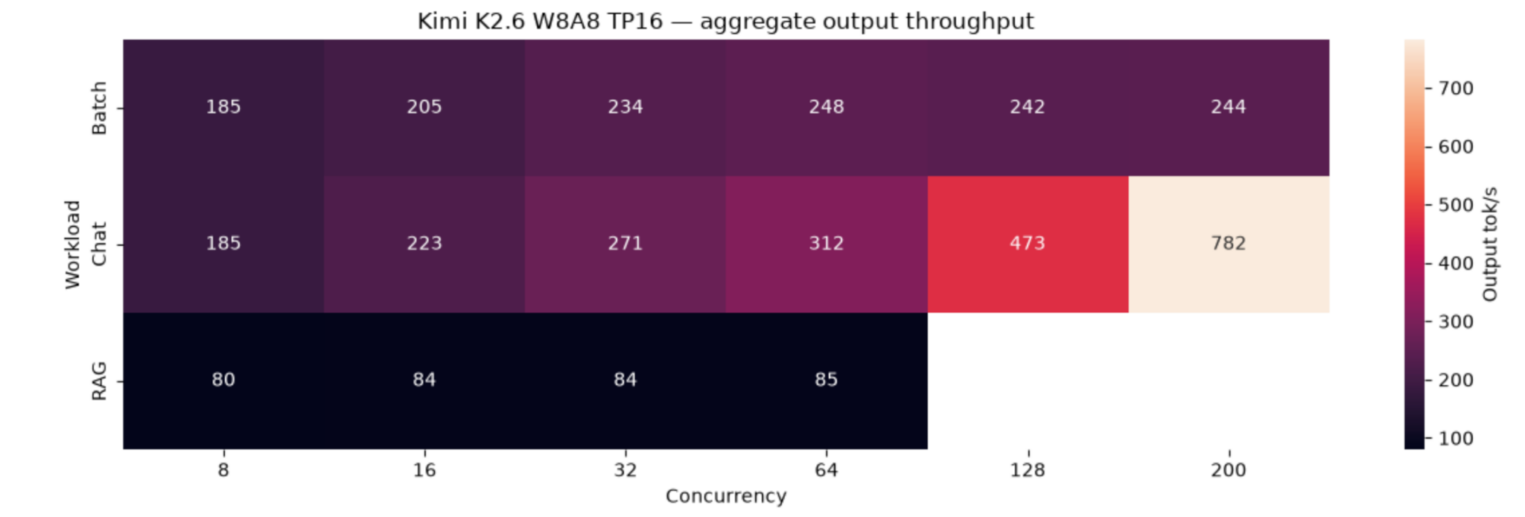
На тепловой карте наглядно можно увидеть ситуацию с плато по перформансу для prefill-нагруженного сценария — RAG.
Тест GLM-5.2 (TP = 16)
На самом сервере оказались полные веса GLM-5.2. При попытке запустить модель по вышеуказанному сценарию она свалилась — форк vLLM для PPU неправильно понимает чекпоинты и не может их загрузить.
      ValueError: Following weights were not initialized from checkpoint:
{
  model.layers.47.self_attn.indexer.k_norm.weight,
  model.layers.4.self_attn.indexer.k_norm.bias,
  model.layers.37.self_attn.indexer.k_norm.bias,
  ...
}

Engine core initialization failed
Тест Kimi K2.6
Также на сервере находятся подготовленные веса Kimi K2.6 в квантизации W8A8 от T-HEAD. Эту модель удалось запустить без проблем. Результаты бенчмарков получились следующие.
Chat-профиль — input 1024 / output 512:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50, s |
| 8 | 0.36 | 184.57 | 556.59 | 1647.36 | 7980.40 | 36.61 | 60.87 | 34.57 | 40.30 | 20.36 |
| 16 | 0.44 | 222.93 | 672.29 | 360.34 | 4737.80 | 69.94 | 85.57 | 63.62 | 83.91 | 36.10 |
| 32 | 0.53 | 271.12 | 817.61 | 531.96 | 2427.35 | 115.08 | 126.36 | 109.83 | 138.87 | 59.34 |
| 64 | 0.61 | 311.62 | 939.74 | 755.21 | 3790.68 | 195.57 | 213.23 | 173.71 | 287.22 | 100.69 |
| 128 | 0.92 | 473.10 | 1426.70 | 1302.72 | 2276.01 | 216.62 | 216.78 | 205.71 | 232.72 | 112 |
| 200 | 1.53 | 781.78 | 2357.56 | 1975.01 | 2599.19 | 251.81 | 252.12 | 240.92 | 475.16 | 130.65 |
RAG-профиль — input 32000 / output 1024:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50, s |
| 8 | 0.04 | 80.30 | 1335.35 | 30431.34 | 62256.68 | 84.92 | 94.18 | 54.54 | 2289.76 | 117.30 |
| 16 | 0.04 | 84.23 | 1400.68 | 25154.27 | 150411.03 | 179.88 | 185.90 | 101.73 | 2536.83 | 209.17 |
| 32 | 0.04 | 83.87 | 1394.60 | 172385.76 | 622842 | 246.15 | 335.81 | 134.67 | 2563.79 | 424.2 |
| 64 | 0.04 | 84.92 | 1412.21 | 1047058.01 | 1203970.53 | 242.08 | 330.91 | 134.38 | 2551.54 | 1294.71 |
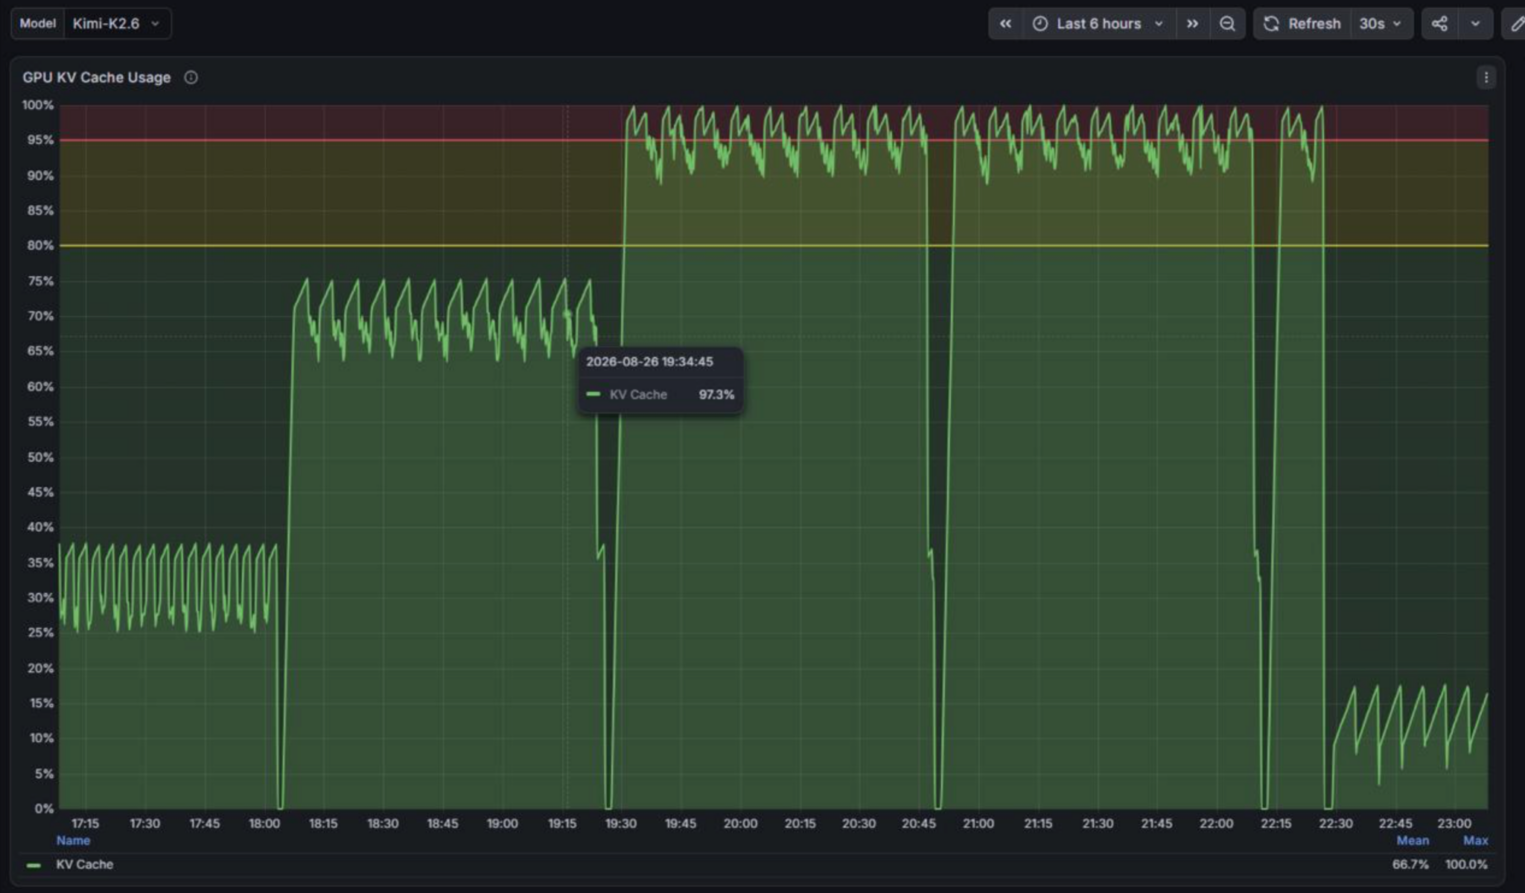
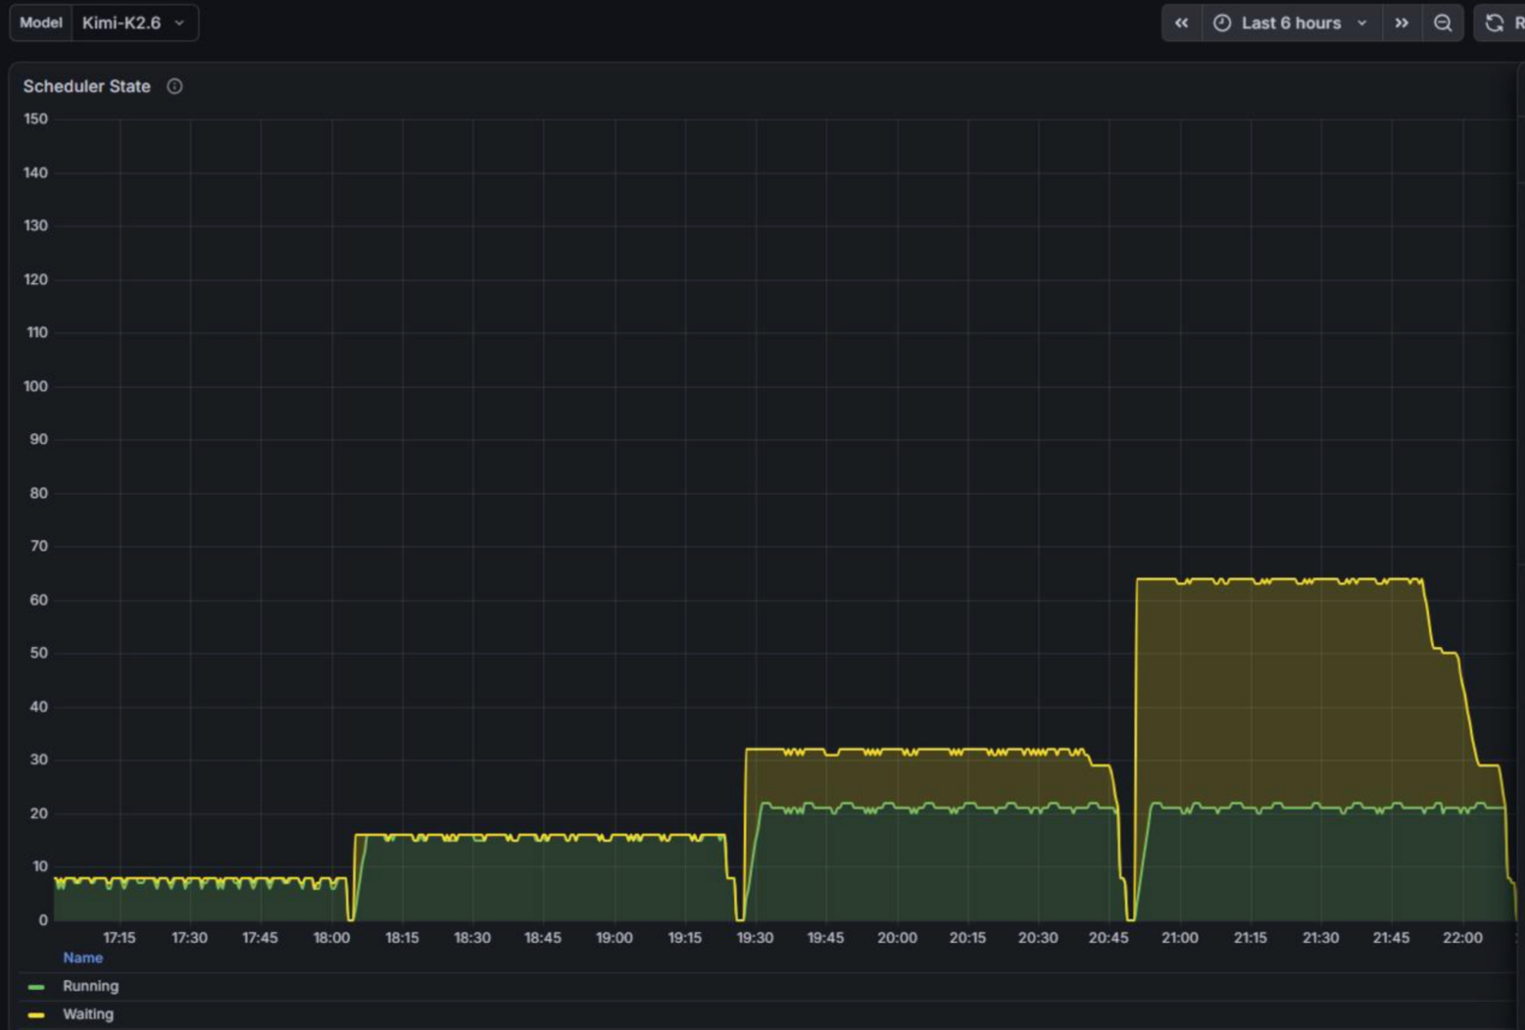
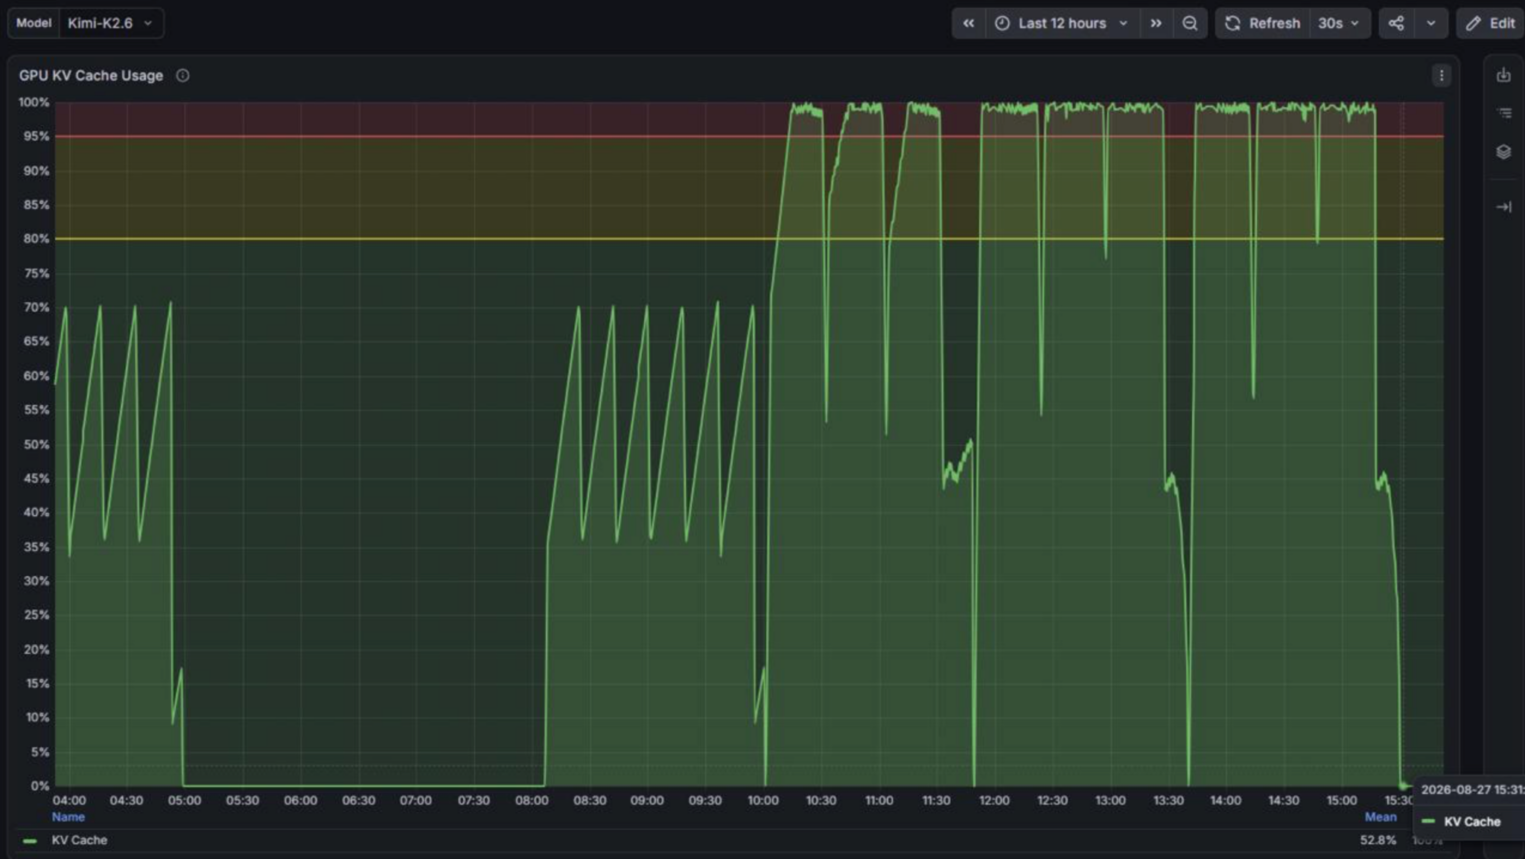
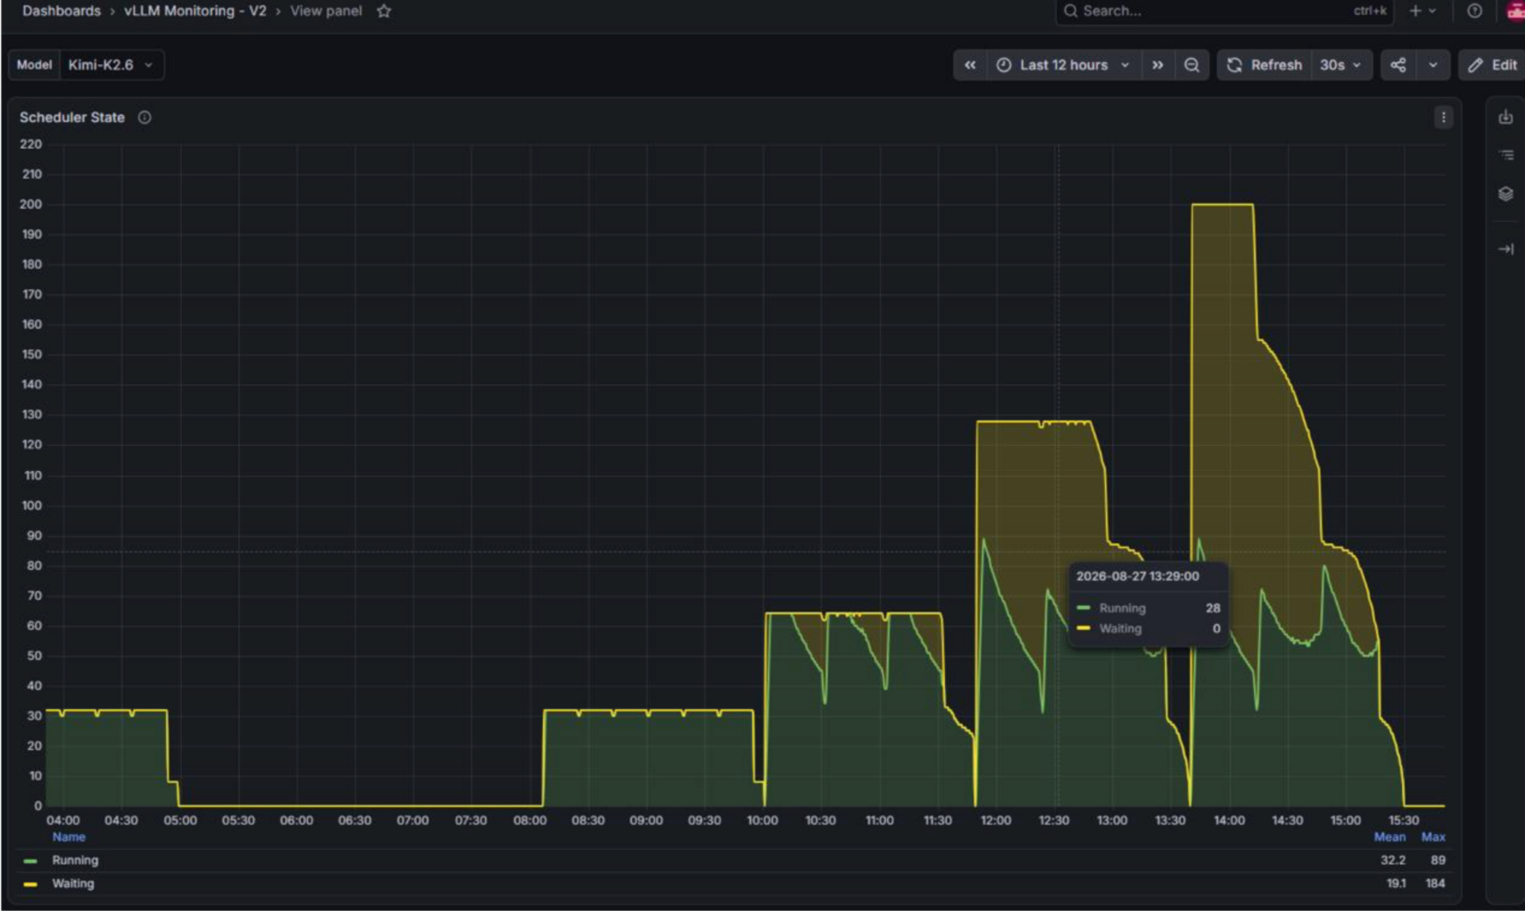
С ростом concurrency с таким контекстом емкость KV-Cache переполнена и сервер вышел на плато: 20 запросов в работе, остальные — в очереди.
Batch-профиль — input 8000 / output 8000:
| concurrency | rps | Output tok/s | Total tok/s | TTFT p50, ms | TTFT p99, ms | TPOT p50, ms | TPOT p99, ms | ITL p50, ms | ITL p99, ms | E2E p50 |
| 8 | 0.02 | 185.14 | 370.46 | 8856.09 | 17130.81 | 42.24 | 43.59 | 40.20 | 43.81 | ~ 5 m |
| 16 | 0.03 | 204.9 | 410 | 9188.22 | 33908 | 76.73 | 77.79 | 71.92 | 84.20 | ~ 10 m |
| 32 | 0.03 | 234.05 | 468 | 8488.17 | 73560.41 | 133.88 | 137.05 | 123.85 | 242.47 | ~ 17m |
| 64 | 0.03 | 247.81 | 495.86 | 77351.28 | 805702.39 | 220.30 | 345.21 | 199.34 | 407.01 | ~ 30 m |
| 128 | 0.03 | 241.55 | 483.34 | 1236760.05 | 3498485.51 | 245.52 | 465.25 | 199.37 | 2126.91 | ~ 53 m |
| 200 | 0.03 | 244.03 | 488.03 | 2098643.76 | 5769940.37 | 238.92 | 456.35 | 199.26 | 2061.37 | ~ 66 m |
С ростом concurrency также уперлись в KV-Cache и очередь.
Также для наглядности прикладываю график по E2E на 8k/8k-сценария.
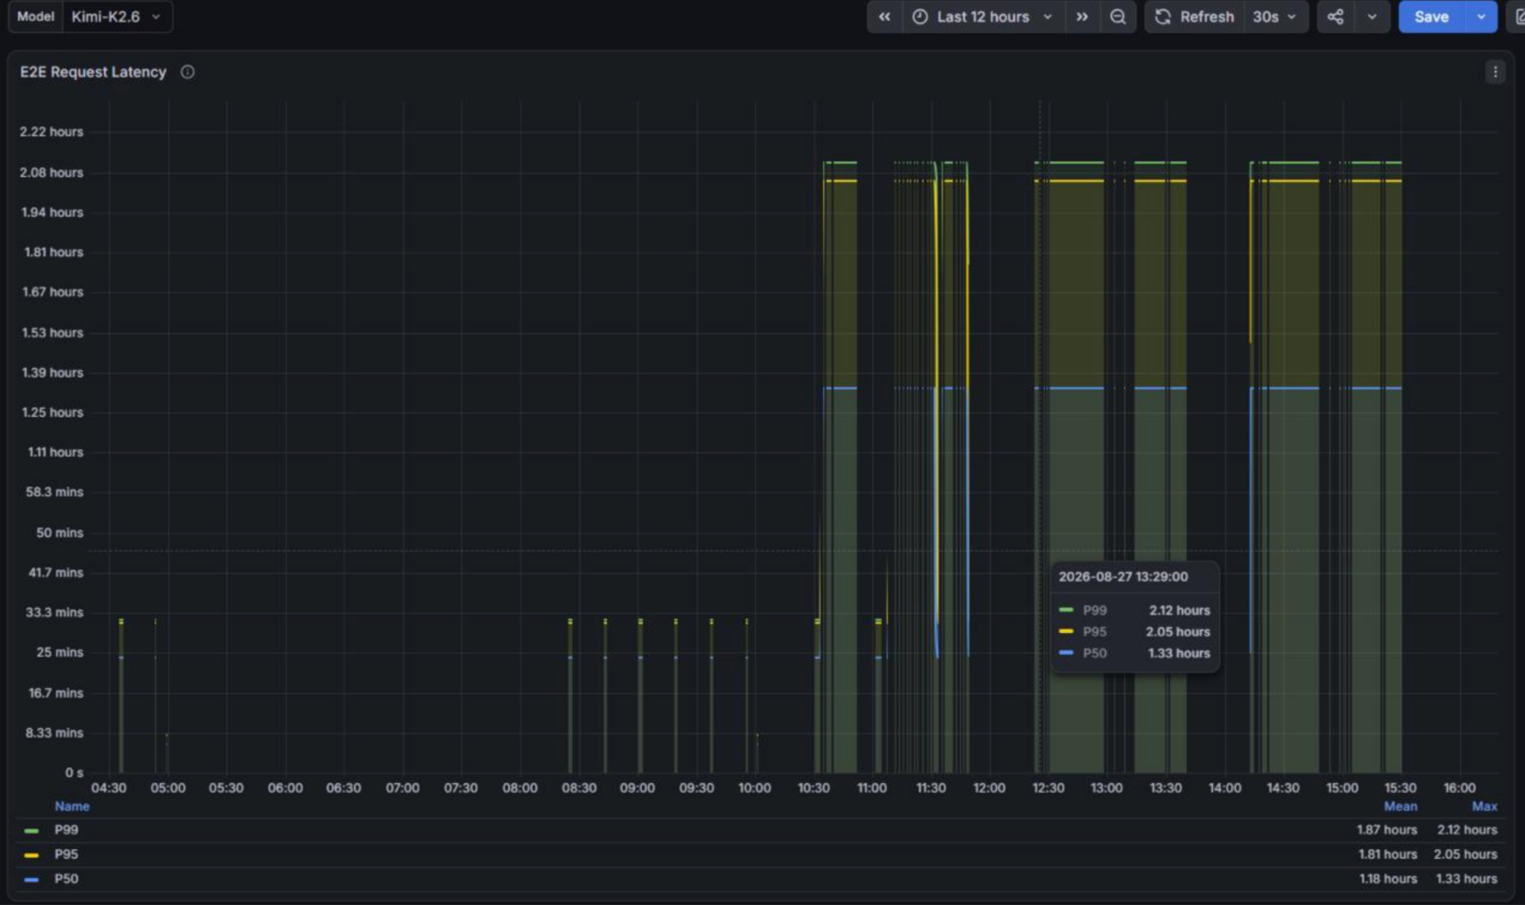
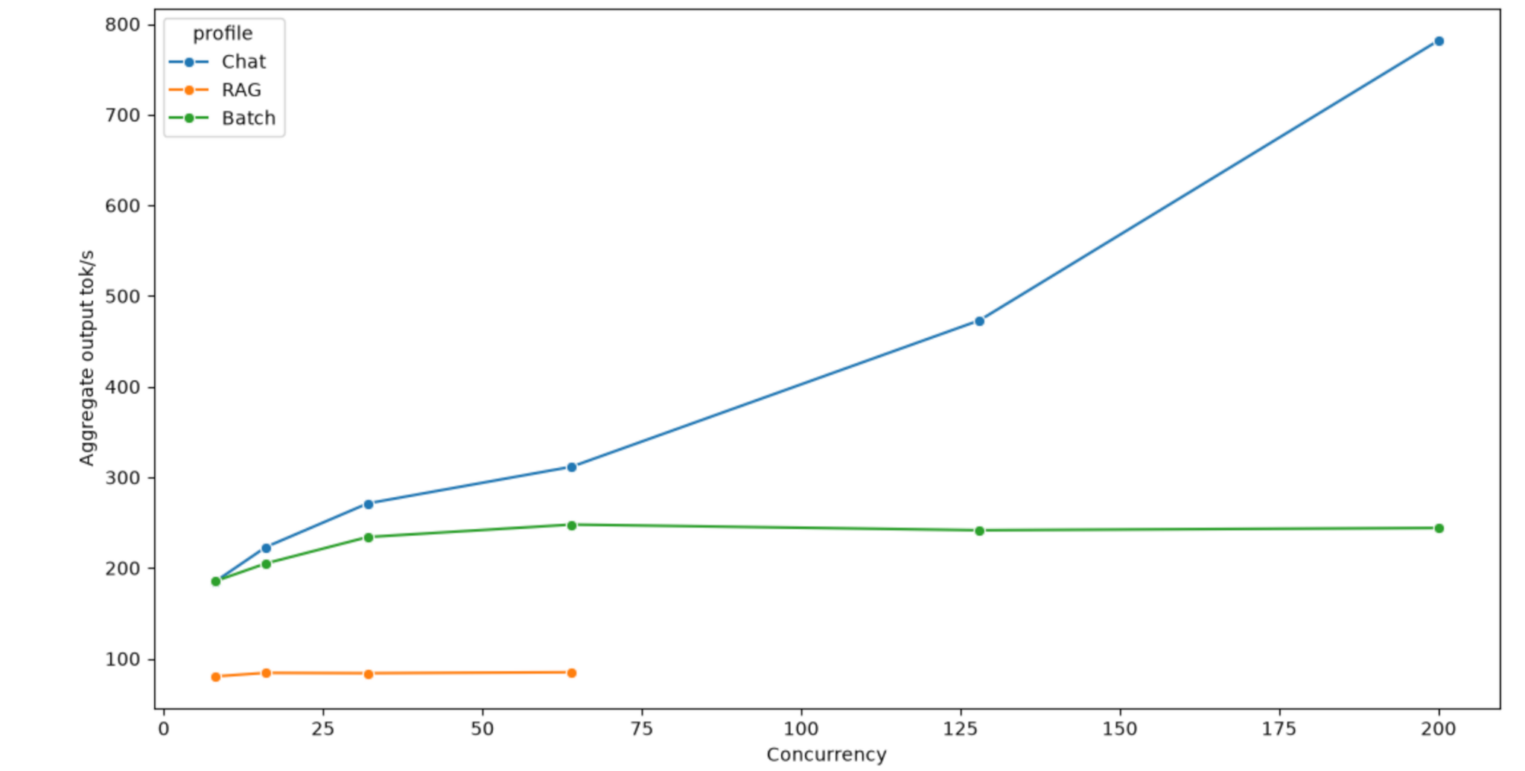
Результирующие графики и тепловая карта также показывают выход на плато по перформансу для тяжелых prefill- и decode-сценариев.
Выводы
Справедливости ради, бейзлайна для сравнения у меня не оказалось под рукой. По идее, для адекватного сравнения нужен аналогичный сервер (например, конфигурация с 16 ускорителями A100). Между тем, с технической точки зрения AI-станция на базе 16 PPU имеет достойную пропускную способность ICN-интерконнекта и огромный объем VRAM — 1,5 ТБ. Подозреваю, что если глубже закопаться в документацию по настройке инференса для каждой доступной модели, можно выбить более интересные показатели на бенчмарках. Тем более что при поставке такого сервера в виде ПАК можно дополнительно получить от вендора дооптимизированные варианты open-source моделей семейства Qwen.
Полноценную интеграцию с Kubernetes в рамках теста мы не выполняли, хотя тесты показали возможность работать с контейнерами на специально подготовленных образах и с пробрасыванием PPU внутрь. Основной же блокер — стек на базе PPU SDK:
- нет достаточного объема документации для эксплуатации. А та, что есть, скорее относится к облачному сервису Alibaba Cloud;
- нет коммьюнити и экспертизы — даже в мировом масштабе. Любые нетривиальные проблемы могут обернуться блокером. Одна надежда на коммуникацию с T-HEAD;
- неконтролируемый и непрогнозируемый лаг доработки PPU SDK для новых инструментов и моделей;
- особенности квантизации — добыть модели в нужной квантизации непросто. И хотя сервер обладает огромным объемом VRAM, полновесные модели будут забирать значительную часть этого объема. Это, конечно, глобальная проблема, но тут адаптированные небольшие веса найти сложнее.
На мой взгляд, железо подходит под запуск согласованных, адаптированных и проверенных моделей. Это актуально для проектов в государственном и бигтех-секторах, где итерация обновлений моделей может быть долгой. Проект активно развивается, поэтому в будущем имеет смысл рассмотреть следующее поколение устройства — PPU Zhenwu M890.