Когда разработчик решает заняться машинным обучением, он сталкивается с выбором инструмента для создания и обучения нейронных сетей. Писать вычисления с нуля на чистом Python неэффективно, а считать вручную градиенты для сложных моделей — практически нереальная задача. Поэтому для работы с нейросетями используют специализированные библиотеки, и одна из самых популярных среди них — PyTorch.
PyTorch — это открытый фреймворк для машинного обучения, с помощью которого вы можете создавать, обучать и запускать нейронные сети любой сложности. Его выбирают за понятный синтаксис, близкий к обычному Python и NumPy, а также за динамический вычислительный граф, который упрощает отладку и эксперименты с архитектурой модели.
В этой статье детально разберем, что такое PyTorch и из каких модулей он состоит, чем он отличается от других фреймворков для машинного обучения, а также рассмотрим главные преимущества и недостатки инструмента.
Общая информация о Pytorch
PyTorch — фреймворк с открытым исходным кодом. В его основе — тензорные вычисления с поддержкой GPU и автоматическое дифференцирование. Это значит, что PyTorch сам отслеживает операции над данными и вычисляет градиенты, нужные для обновления весов модели.
Еще одна особенность PyTorch — это динамический вычислительный граф. Благодаря нему можно быстро изменять архитектуру модели и отлаживать ее обычными инструментами Python. Из-за этого PyTorch называют Pythonic-фреймворком: код на нем читается как обычный Python-скрипт. Например, тензоры и операции с ними в PyTorch выглядят так же лаконично, как в NumPy:
import torch
x = torch.tensor([1.0, 2.0, 3.0])
y = torch.tensor([4.0, 5.0, 6.0])
print(x + y)  # tensor([5., 7., 9.])
Для чего применяется
PyTorch используют для решения практически любых задач ML, где требуется построение, обучение и развертывание нейронных сетей. Среди основных областей применения:
- компьютерное зрение (CV),
- обработка естественного языка (NLP),
- распознавание и обработка речи,
- рекомендательные системы,
- обучение с подкреплением (Deep Q-Networks и другие алгоритмы, которые применяют в робототехнике и автономных системах),
- генеративные модели.
Из чего состоит PyTorch
PyTorch — экосистема модулей, которая состоит из более чем 30 подмодулей, не считая отдельных библиотек экосистемы вроде torchvision или torchaudio. Каждый модуль отвечает за свою часть процесса разработки нейросетей: от базовых вычислений до загрузки данных и обучения на GPU. В этой статье мы разберем ключевые компоненты. Полный список модулей можно изучить в официальной документации.
Тензоры: torch.tensor
В основе PyTorch лежат тензоры — многомерные массивы чисел, которые используются для представления любых данных: изображений, текста, аудио и т. д. Тензор можно представить в виде таблицы чисел любой размерности.
Модуль torch предоставляет десятки операций для работы с тензорами: линейная алгебра, индексирование, изменение формы, статистические функции. Практически любая другая часть фреймворка построена поверх этой базовой структуры. Чтобы использовать модуль torch, его нужно импортировать в код:
import torchТензор похож на обычный список в Python или на массив в NumPy, но вычисления с ним можно выполнять не на процессоре, а на видеокарте, чтобы их ускорить. Создается тензор функцией torch.tensor:
x = torch.tensor([1.0, 2.0, 3.0])Вычислительные графы: grad_fn
grad_fn — это атрибут тензора, который хранит ссылку на функцию (узел вычислительного графа), создавшую тензор. Когда PyTorch делает вычисления с тензорами, он запоминает, какие именно действия были выполнены и в каком порядке.
Например, сложили, потом умножили, потом передали в функцию активации. Эта цепочка действий и называется вычислительным графом. Он дает возможность пройти по этой цепочке в обратную сторону и посчитать, как каждое число повлияло на итоговый результат — это и есть основа обучения нейросети. PyTorch строит такой граф автоматически, прямо по ходу выполнения кода (подход define-by-run).
Рассмотрим на примере, как работает построение простого графа:
a = torch.tensor([2.0], requires_grad=True)
b = torch.tensor([3.0], requires_grad=True)
c = a * b
d = c + 1
print(d.grad_fn)
print(d.grad_fn.next_functions)
В результате выполнения кода получим вывод:
<AddBackward0 object at 0x000001B9B1420520>
((<MulBackward0 object at 0x000001B980C350C0>, 0), (None, 0))
PyTorch запоминает цепочку операций (умножение, потом сложение), которая образует вычислительный граф. d.grad_fn показывает, что тензор d был получен операцией сложения (AddBackward), а next_functions показывает, что перед этим было умножение (MulBackward).
Этот пример демонстрирует, что граф строится автоматически по ходу вычислений: каждый новый тензор помнит, из какой операции и из каких предыдущих тензоров он появился. Именно по этой цепочке затем проходит метод .backward(), когда вычисляет градиенты.
Автоматическое дифференцирование: torch.autograd
torch.autograd — модуль, который отвечает за автоматический расчет градиентов. Он отслеживает все операции над тензорами, у которых включен параметр requires_grad=True. Градиент — это число, которое показывает, в какую сторону и насколько сильно нужно изменить параметр модели, чтобы модель ошибалась меньше. Autograd смотрит на вычислительный граф и сам вычисляет все нужные градиенты командой .backward().
Рассмотрим простой пример кода расчета градиента на примере операции b=a*3. Сначала включим отслеживание градиентов, добавив к функции torch.tensor параметр requires_grad=True.Команда b.backward() запускает обратный проход, а PyTorch вычисляет, как сильно изменение a повлияло на b. В данном случае b = 3a, поэтому производная равна 3, и print(a.grad) выведет tensor([3.]):
a = torch.tensor([2.0], requires_grad=True)
b = a * 3
b.backward()
print(a.grad)
Построение нейронных сетей: torch.nn
torch.nn — это модуль, из которого берут компоненты для нейросети: готовые слои, функции активации, функции ошибки. Модель в PyTorch собирается как конструктор: нужные компоненты соединяются между собой. Архитектура сети обычно описывается классом: в методе __init__ задаются слои, а в методе forward — то, как данные проходят через них.
Для примера построим класс SimpleNet, который описывает архитектуру нейросети из двух слоев с помощью модуля torch.nn. В методе __init__ перечисляются слои, которые будут использоваться: layer1 принимает десять чисел на входе и выдает пять; relu — функция активации, которая добавляет нелинейность (без нее нейросеть могла бы решать только линейные задачи); layer2 сжимает пять чисел в одно на выходе.
Метод forward описывает сам путь данных через модель: сначала данные проходят через layer1, затем через relu, а результат передается в layer2. Именно forward вызывается каждый раз, когда мы подаем данные в модель.
class SimpleNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.layer1 = nn.Linear(10, 5)
        self.relu = nn.ReLU()
        self.layer2 = nn.Linear(5, 1)
    def forward(self, x):
        x = self.relu(self.layer1(x))
        return self.layer2(x)
Рядом с torch.nn часто используют torch.nn.functional — функциональные аналоги слоев и операций, которые удобно вызывать прямо внутри метода forward, без создания отдельного объекта слоя.
class SimpleNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.layer1 = nn.Linear(10, 5)
        self.layer2 = nn.Linear(5, 1)
    def forward(self, x):
        x = torch.nn.functional.relu(self.layer1(x))
        return self.layer2(x)
В первом примере с torch.nn для ReLU создавался отдельный объект self.relu = nn.ReLU(), который затем вызывался в forward. В этом примере используется F.relu(…) — та же самая операция, но в виде обычной функции, которую можно вызвать сразу, без создания и хранения отдельного объекта слоя. Разницы в результате нет: обе записи одинаково правильные и дают одинаковый ответ. Это просто два разных стиля написания кода.
Оптимизаторы: torch.optim
torch.optim — модуль с реализацией алгоритмов оптимизации, которые обновляют веса модели на основе градиентов, посчитанных autograd. Среди самых используемых оптимизаторов — SGD (стохастический градиентный спуск), Adam, RMSprop.
Рассмотрим пример использования модуля:
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
optimizer.zero_grad()
loss.backward()
optimizer.step()
В примере optim.Adam создает оптимизатор, который будет обновлять веса модели. В model.parameters() передаются все обучаемые параметры модели, а lr=0.001 — это скорость обучения (learning rate): насколько сильно веса будут меняться на каждом шаге.
Дальше идет стандартная последовательность из трех строк, которая повторяется в каждом цикле обучения: zero_grad() обнуляет градиенты, оставшиеся с прошлого шага (иначе они будут накапливаться), loss.backward() считает новые градиенты, а optimizer.step() использует эти градиенты, чтобы подправить веса модели в сторону уменьшения ошибки. Связка: autograd, nn и optim и есть стандартный цикл обучения любой модели в PyTorch.
Работа с данными: torch.utils.data
Для подготовки и загрузки данных используется модуль torch.utils.data, в котором ключевую роль играют два класса:
- Dataset — описывает, как получить один элемент данных (например, изображение и метку класса);
- DataLoader — организует загрузку данных батчами, их перемешивание и параллельную подгрузку в несколько потоков, что ускоряет обучение на больших объемах данных.
Чтобы импортировать эти классы, используем команду:
from torch.utils.data import DataLoader
from torch.utils.data import Dataset
Рассмотрим пример работы с данными через DataLoader:
loader = DataLoader(dataset, batch_size=32, shuffle=True)
for batch in loader:
    inputs, labels = batch
В примере параметр batch_size=32 означает, что за один раз модель получит 32 примера, чтобы ускорить обучение. shuffle=True перемешивает порядок данных перед каждой эпохой, чтобы модель не подстраивалась под конкретную последовательность примеров. В цикле for batch in loader мы поочередно достаем готовые батчи и разбираем их на входные данные (inputs) и правильные ответы (labels).
Вычисления с GPU: torch.cuda
torch.cuda — модуль, который отвечает за перенос вычислений на видеокарту NVIDIA. С его помощью можно проверить доступность видеокарты и переместить на нее модель и данные, чтобы ускорить обучение. Именно поддержка CUDA — одна из причин, по которым PyTorch способен обучать большие модели значительно быстрее, чем на обычном процессоре.
Рассмотрим пример работы с модулем:
device = "cuda" if torch.cuda.is_available() else "cpu"
model.to(device)
Первая строка проверяет, доступна ли видеокарта: torch.cuda.is_available(). Она возвращает True, если PyTorch видит GPU с поддержкой CUDA, и False, если нет. В зависимости от результата переменная device принимает значение “cuda” или “cpu”. Команда model.to(device) переносит модель на выбранное устройство. Если это видеокарта, то все дальнейшие вычисления будут выполняться на ней и пройдут значительно быстрее.
torchvision, torchaudio, torchtext: библиотеки экосистемы
Помимо ядра, в экосистему PyTorch входят специализированные библиотеки под конкретные типы данных:
- torchvision — для работы с изображениями: готовые датасеты, предобученные модели и инструменты для обработки изображений;
- torchaudio — для работы со звуком, например для распознавания речи;
- torchtext — для работы с текстом; сейчас для этого чаще используют библиотеку Transformers от Hugging Face, но torchtext по-прежнему официально входит в экосистему PyTorch.
Дополнительные инструменты
Отдельно стоит упомянуть еще несколько модулей, которые используются реже, чем перечисленные выше, но играют важную роль в промышленном применении PyTorch:
- TorchScript (torch.jit) — позволяет сериализовать модель и оптимизировать ее для запуска в продакшене, в том числе без интерпретатора Python;
- torch.compile — инструмент компиляции модели, который ускоряет ее выполнение за счет оптимизации графа вычислений;
- torch.distributed — модуль для распределенного обучения на нескольких GPU или нескольких машинах одновременно, необходимый при работе с крупными моделями.
Отличия от похожих фреймворков
Основными конкурентами PyTorch в 2026 году стали TensorFlow и JAX.
PyTorch vs TensorFlow
Основное отличие фреймворков заключается в способе построения графа вычислений. PyTorch с самого начала работает по принципу eager execution: код выполняется сразу, строчка за строчкой, как обычный Python-скрипт, а граф вычислений строится динамически.
TensorFlow строится на основе статического графа. Сначала архитектура модели полностью описывается, а затем компилируется и запускается в отдельной сессии. Кроме того, экосистема TensorFlow оказывается заметно сложнее для новичка.
Из-за динамического графа PyTorch проще отлаживать, так как ошибки видно сразу на той строке кода, где они возникли, а модель можно менять на лету, используя обычные циклы и условия Python.
PyTorch vs Jax
JAX — библиотека, построенная на принципе функционального программирования поверх NumPy. Вместо классов и объектов, как в PyTorch, в JAX модель описывается чистыми функциями без побочных эффектов, а операции вроде компиляции, дифференцирования и векторизации применяются как трансформации к этим функциям.
JAX показывает более высокую производительность на TPU и в задачах масштабного распределенного обучения (кластеры от 128 GPU и выше), где дает прирост скорости 10–15% по сравнению с PyTorch. Однако, у него меньше сообщество, более крутая кривая обучения из-за требований функционального стиля и заметно меньше готовых предобученных моделей.
Установка PyTorch
Для установки библиотеки PyTorch используются менеджеры пакетов pip или conda. Способ установки зависит не только от выбранного менеджера пакетов, но и от наличия CPU или GPU, так как необходимо установить совместимую версию PyTorch. Чтобы не запутаться в совместимости версий и настроить все с первого раза, переходите к пошаговой инструкции по установке PyTorch в Академии Selectel. Там мы разобрали все тонкости и подводные камни работы с фреймворком.
Преимущества и недостатки
Главным преимуществом является простой синтаксис, благодаря которому код на PyTorch читается как обычный Python-скрипт. Тензоры работают почти как массивы NumPy, поэтому тем, кто уже писал на Python, не нужно учить фреймворк с нуля. Также важную роль играет динамический граф вычислений. Архитектуру модели можно менять прямо во время работы кода, а ошибки видно сразу на той строке, где они возникли. Это очень удобно и для экспериментов, и для отладки.
Другой важный фактор — гибкость инструмента. PyTorch дает прямой доступ к математическим функциям и позволяет писать собственные операции, поэтому на нем можно собирать нестандартные архитектуры моделей, а не только типовые решения. Быстрому освоению способствуют подробная официальная документация и большое сообщество разработчиков, которое постоянно пополняет ее туториалами и примерами, а это снижает порог входа для новичков.
Кроме того, разработчики ценят развитую экосистему. Большинство современных открытых моделей, таких как LlaMA, Mistral и Stable Diffusion, выходят в первую очередь для PyTorch. Библиотека Hugging Face Transformers тоже построена на PyTorch, поэтому работать с готовыми моделями удобнее именно с этим инструментом. Наконец, сильной стороной является поддержка распределенного обучения. PyTorch умеет обучать модели сразу на нескольких GPU или нескольких машинах, что важно при работе с большими моделями.
При этом у фреймворка есть и недостатки, среди которых можно выделить отсутствие встроенных инструментов визуализации. В отличие от TensorFlow с его TensorBoard, у PyTorch нет собственного визуального интерфейса для отслеживания процесса обучения. Также отмечается менее развитая мобильная экосистема. Инструменты для запуска моделей на телефонах, такие как PyTorch Mobile и ExecuTorch, пока менее зрелые, чем TensorFlow Lite.
Вдобавок к этому наблюдается нехватка готовых решений для продакшена. У PyTorch не такая развитая инфраструктура для промышленного развертывания моделей, как у TensorFlow, поэтому иногда приходится дописывать недостающие инструменты самостоятельно.
Наконец, фреймворк слабее показывает себя на TPU. Для обучения на специализированных ускорителях Google TensorFlow и JAX все еще подходят немного лучше, чем PyTorch, который в первую очередь заточен под GPU.
Чем может помочь Selectel
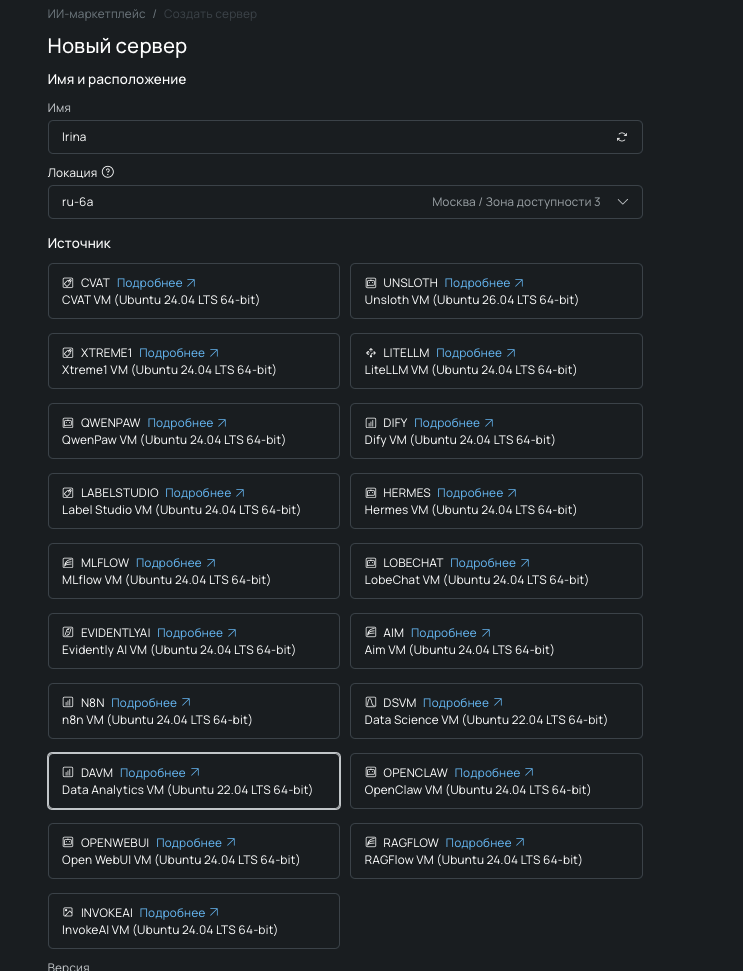
Если вы занимаетесь задачами, связанными с машинным обучением, вам будет полезен DAVM — готовый облачный сервер с предустановленными и настроенными инструментами. Он подходит для разработки и обучения ML-моделей, тестирования LLM, создания небольшой платформы обработки данных и BI-аналитики. Среди доступных и готовых к работе инструментов — популярные фреймворки и библиотеки, включая Keras, TensorFlow, Hugging Face, OpenCV, PyTorch, Pandas и другие.
Образ DAVM разворачивается за несколько минут из панели управления. Мы уже настроили авторизацию через Keycloak, установили CUDA Toolkit для работы с GPU и привязали домен, с помощью которого вы сможете подключаться к инструментам через интернет.
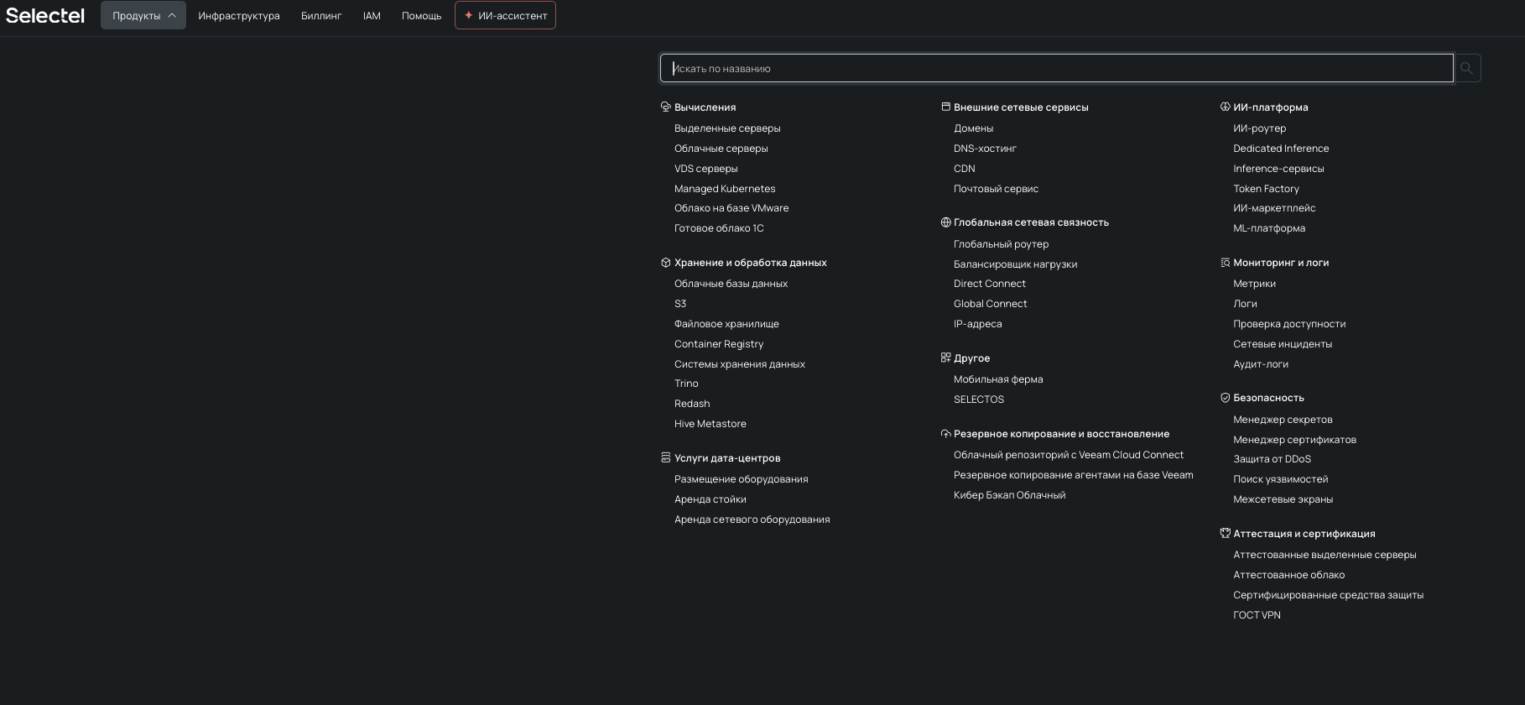
Внутри панели нажимаем Продукты, во вкладке ИИ-платформа, находим и нажимаем на ИИ-маркетплейс.
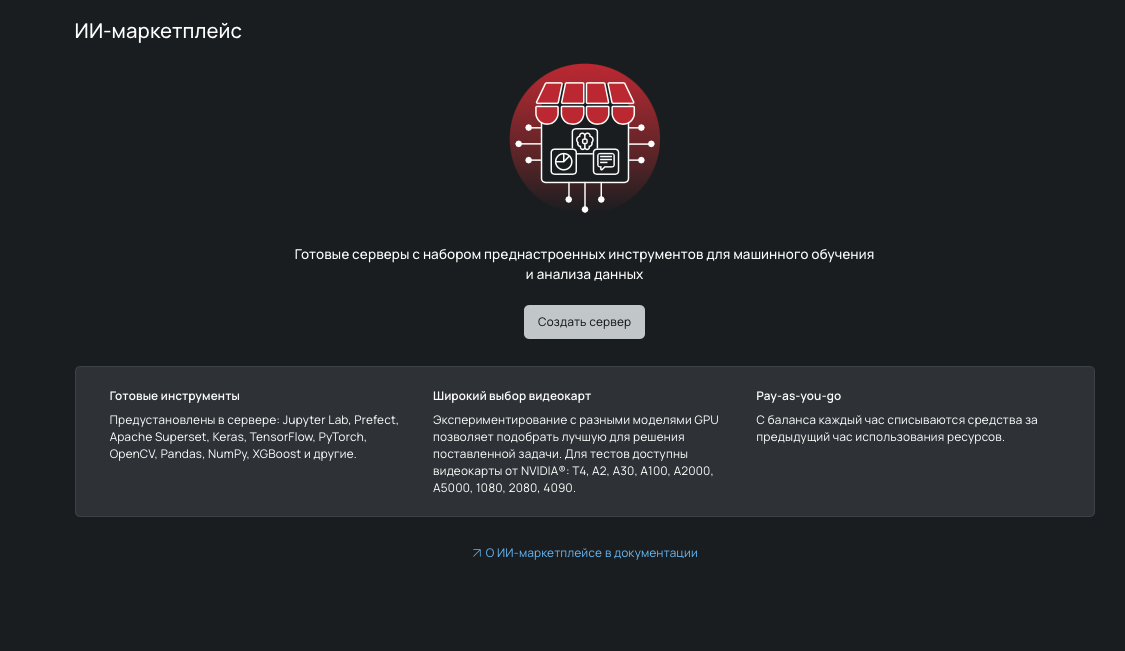
Открывается страница ИИ-маркетплейса на которой нужно нажать Создать сервер.
Вам остается выбрать готовую конфигурацию DAVM или собрать свою.
Выбирайте любую конфигурацию облачного сервера с RAM от 4 ГБ и объемом загрузочного диска от 100 ГБ. Если ваша задача — обучение ML-моделей, рекомендуем использовать конфигурации линейки GPU Line.