В прошлый раз мы развернули RAGFlow, а сегодня поговорим о огромной разнице между тем, чтобы просто достать информацию из базы данных, и тем, чтобы извлечь из нее реальный смысл для пользователя. Классический RAG находит чанки, но не умеет сопоставлять данные из разных файлов и собирать аналитику. Поиск контекста — решенная задача, теперь нужно научить систему думать над ним.
Эволюция RAG
Классический, или RAG Naive, работает по простой схеме:
- пользователь задает вопрос;
- система эмбеддит запрос и ищет top-k чанков в векторной базе;
- найденные фрагменты подставляются в промпт;
- LLM генерирует ответ.
Этот подход быстро работает на простых фактологических вопросах: «Какой у нас SLA по тикетам?» или «Где лежит инструкция по настройке firewall?».
Ограничения становятся заметны, когда вопрос: требует нескольких переходов по данным, опирается на несколько источников, неоднозначен или плохо сформулирован, или требует проверки качества найденного контекста. На этих задачах классический RAG либо возвращает нерелевантные чанки, либо галлюцинирует, когда информации недостаточно.
В RAG 2.0 поиск и генерация уже не являются основополагающими, а сам термин появился в компании Contextual AI. RAG 2.0 — так называют систему, где ретривер и языковая модель обучаются и настраиваются совместно, а процесс извлечения становится управляемым и итеративным. В некоторых трактовках RAG 2.0 подразумевает end‑to‑end обучение и согласование компонентов, чтобы максимизировать итоговое качество, а не только качество отдельных шагов.
Сравнение RAG и RAG 2.0
Для сравнения традиционных систем RAG и архитектур нового поколения 2.0 на базе контекстных языковых моделей (CLM) в исследовании Contextual.ai использовали набор бенчмарков.
Системы RAG 2.0 сравнивали с «замороженными» RAG-системами на GPT-4 или Mixtral с ручной настройкой промптов. Использовали бенчмарки Natural Questions и TriviaQA для оценки способности каждой архитектуры извлекать релевантные знания и генерировать точные ответы. Дополнительно модели тестировались на наборе HotpotQA (HPQA) в режиме одношагового поиска. Во всех случаях основной метрикой служила точность точного совпадения (Exact Match, EM).
Достоверность и устойчивость к галлюцинациям
Для измерения способности системы оставаться верной полученным данным и минимизировать выдуманные факты использовались бенчмарки HaluEvalQA и TruthfulQA. Эти тесты критически важны для производственных сценариев, где ошибка в фактах недопустима.
Чтобы оценить адаптивность к быстро меняющимся мировым событиям, исследователи тестировали способность каждой системы RAG к обобщению на актуальных данных с использованием поискового индекса в интернете. Точность работы с недавними фактами показывалась на тесте FreshQA.
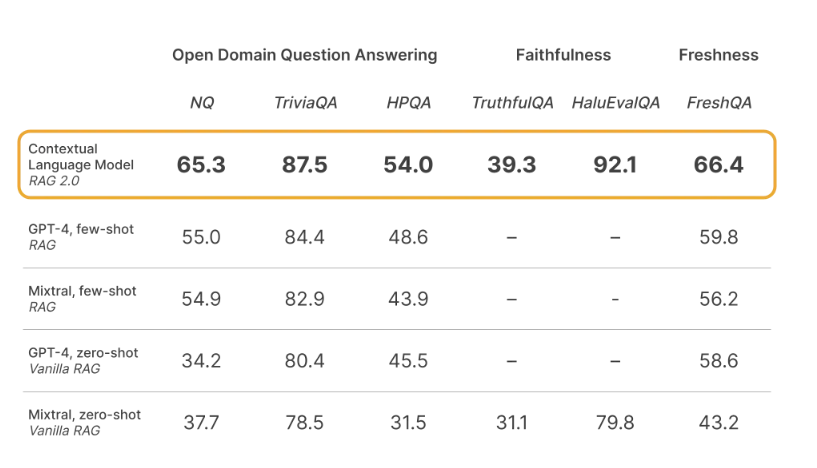
Применение CLM-систем к производственным данным уже показало преимущество. В качестве примера использовали бенчмарк FinanceBench, имитирующий задачи из финансовой предметной области. Результаты показали, что CLM-системы превосходят «замороженные» архитектуры RAG даже в узкоспециализированных сценариях вопросно-ответной работы с финансовыми документами.
Что такое Agentic RAG
RAG 2.0 и Agentic RAG часто упоминают рядом, но это разные вещи. RAG 2.0 отвечает на вопрос, как обучены компоненты системы: совместно или по отдельности. Agentic RAG отвечает на вопрос, как управляется поиск: одним проходом или циклом с планированием и проверкой результата. Эти подходы не исключают друг друга.
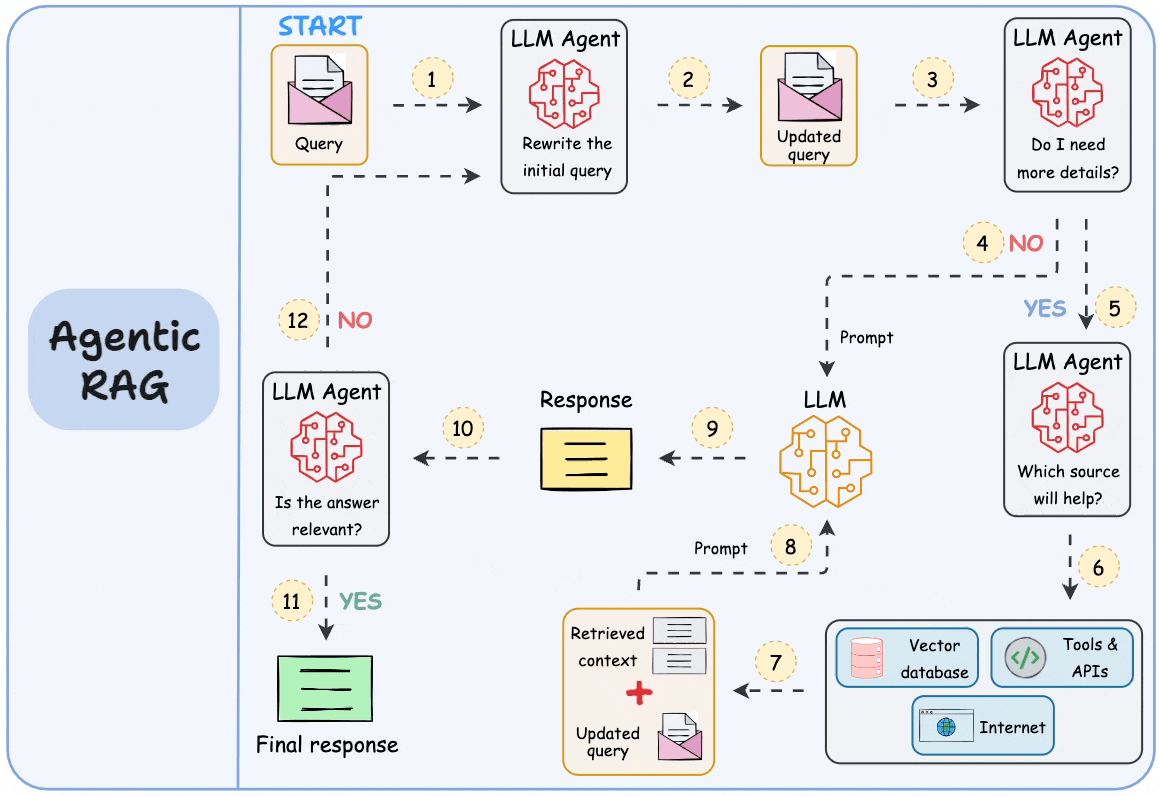
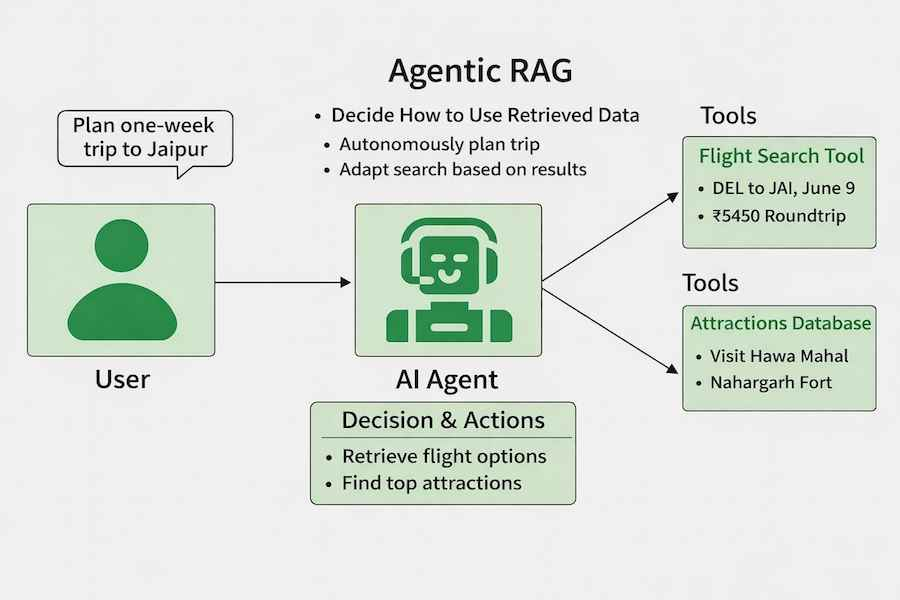
Agentic Retrieval-Augmented Generation (Agentic RAG) — это архитектура нового поколения, в которой большая языковая модель выступает в роли автономного агента, самостоятельно планирующего свои действия для извлечения информации из внешних источников.
В отличие от традиционных RAG-систем со статичным шаблоном «извлечь-затем-прочитать», Agentic RAG реализует итеративный цикл, в котором вызовы LLM перемежаются вызовами инструментов или функций и структурированными выводами. Система оценивает промежуточные результаты, уточняет запросы, при необходимости привлекает дополнительные инструменты и продолжает этот цикл до достижения удовлетворительного решения.
Этот стиль работы по принципу «создание — проверка» повышает корректность ответов, позволяет обрабатывать некорректные или неоднозначные запросы и помогает получать более качественные результаты.
Ключевая особенность агентной системы — способность самостоятельно управлять процессом рассуждения.
Система самостоятельно:
- переписывает неудачные запросы при получении слабых результатов;
- выбирает различные методы поиска в зависимости от типа задачи;
- интегрирует несколько инструментов — векторный поиск (например, Azure AI Search), SQL-запросы к базам данных, кастомные API и другие источники;
- завершает поиск, когда собрано достаточно данных для ответа.
Архитектура Agentic RAG
Архитектура Agentic RAG строится вокруг агента-оркестратора, который управляет не только генерацией ответа, но и всем процессом извлечения знаний: планированием, выбором источников, вызовом инструментов, проверкой результатов и при необходимости — повторными итерациями. В отличие от классического RAG, где путь запроса жестко задан, здесь retrieval становится одним из инструментов, доступных агенту.
| Компонент | Роль в архитектуре |
| Planning Agent | Разбирает запрос пользователя, определяет тип задачи и строит план из подзадач. |
| Agent Controller (Reasoning Engine) | Исполняет текущий шаг плана, выбирает инструмент, оценивает результат и решает, продолжать ли цикл. |
| Tool Library | Набор инструментов: retrieval (векторный/ключевой поиск), API, SQL, выполнение кода, работа с тикет‑системой. |
| Retriever + Knowledge Base | Возвращает релевантные документы/фрагменты по запросу агента (векторные индексы, keyword‑индексы, при необходимости — графы/реляционные БД). |
| Generator LLM | Синтезирует финальный ответ на основе накопленного контекста. |
| Memory (краткосрочная/долгосрочная) | Хранит текущий план и промежуточные результаты (краткосрочная) либо проверенные факты, шаблоны, предпочтения (долгосрочная). |
| Security and Access Layer | Аутентификация агентов, авторизация действий, аудит вызовов инструментов. |
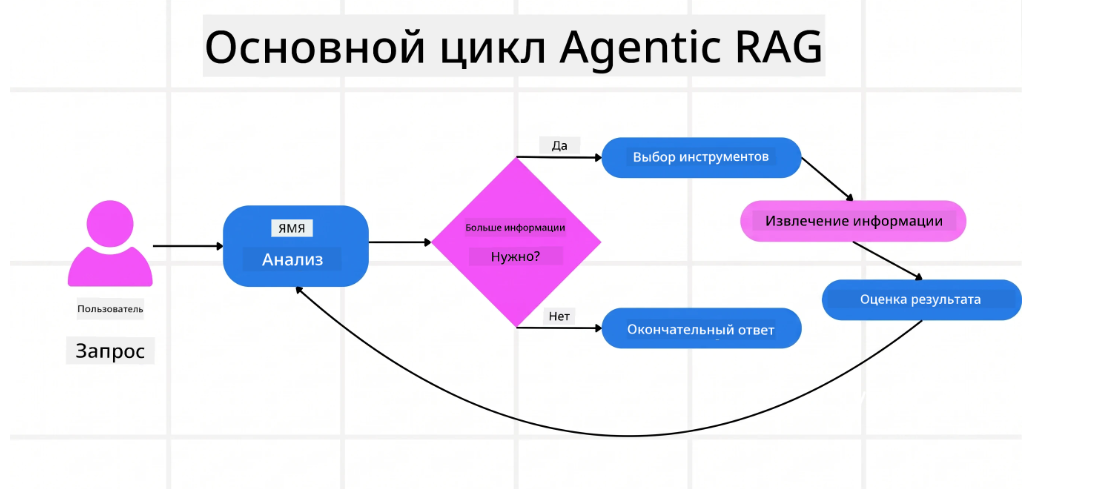
В мультиагентных реализациях эти функции иногда разделяют между отдельными агентами (планировщик, исполнитель, оркестратор), но единого стандарта такого разделения нет.
Жизненный цикл запроса
Давайте возьмем пример запроса пользователя и посмотрим, через какие этапы он пройдет:
Почему под в Kubernetes не стартует и как это исправить?
1. Прием запроса
Пользователь формулирует вопрос (в чате поддержки, через API или другой интерфейс). Агент получает запрос вместе с контекстом сессии.
2. Планирование
Planning Agent анализирует запрос, определяет тип задачи (справка, диагностика, сравнение версий, расследование инцидента) и строит план из подзадач.
Пример: для вопроса «Почему под не стартует?» план может быть следующим: проверить статус, посмотреть события, сверить с известными инцидентами и сформировать рекомендации.
3. Выбор инструментов
Controller (Reasoning Engine) выбирает инструменты для текущего шага плана:
- retrieval по внутренней базе знаний;
- вызовы API;
- SQL‑запросы к логам или метрикам;
- выполнение безопасных скриптов для проверки гипотез.
4. Извлечение и оценка
Инструменты возвращают результаты. Агент оценивает, достаточно ли доказательств, есть ли противоречия, какие пробелы остались. При необходимости — переформулирует запрос, меняет источник или добавляет новый шаг. яВ нашем примере по запросу «под не стартует» находится только общая статья про жизненный цикл пода — для диагностики этого недостаточно.
5. Итерация или завершение
Если информации недостаточно — цикл повторяется. Если достаточно — переход к генерации ответа. Ограничители: максимальное число шагов, таймауты, пороги уверенности. В примере агент переформулирует запрос («CrashLoopBackOff причины и диагностика»), находит инструкцию по диагностике и признает информацию достаточной, после чего цикл завершается. Классический RAG ответил бы по первой, общей статье.
6. Генерация ответа
Generator LLM формирует финальный ответ, используя накопленный контекст, цитаты и ссылки на источники. При необходимости добавляет рекомендации, чек‑листы, команды для проверки.
7. Обучение и обратная связь
Результат может записываться в долгосрочную память и использоваться для дообучения/настройки агентов и пайплайнов.
Ключевой момент здесь — этапы 4 и 5. Первая выдача оказалась слабой, и агент не стал отвечать по ней, а оценил результат, переформулировал запрос и повторил поиск. Классический RAG на этом месте ответил бы по общей статье про жизненный цикл пода.
Сравнение классического и агентного RAG
Давайте сравним, в чем именно разница классического RAG и RAG агентного
| Критерий | Классический RAG | Агентный RAG |
| Управление потоком | Фиксированный пайплайн | Управляемый цикл |
| Извлечение | Однократное, по одному запросу. | Многократное, адаптивное, из нескольких источников, с переформулировками. |
| Сложные запросы | Плохо справляется с multi‑hop и неоднозначными вопросами. | Специализируется на многошаговых задачах и рассуждениях. |
| Гибкость | Низкая: сложно менять логику под тип запроса | Высокая: агент выбирает источники и инструменты под задачу. |
| Стоимость | Ниже (меньше вызовов LLM и инструментов). | Выше (больше шагов, больше токенов и вызовов). |
| Архитектура | Проще: один проход, понятный лог. | Сложнее: нужно логировать план, шаги, решения агента |
| Сценарии | FAQ, простые справки, одношаговые вопросы. | Техподдержка, расследование инцидентов, комплексные инструкции, работа с несколькими системами |
Классический RAG лучше подходит, если большинство запросов простые и однозначные, а от системы требуется низкая и предсказуемая задержка. Такой подход также предпочтителен при высоком объеме обращений, где важен контроль стоимости, и когда база знаний достаточно чистая и хорошо покрывает типовые вопросы.
Agentic RAG оправдан, когда запросы требуют нескольких последовательных обращений к данным или синтеза информации из разных источников. Он особенно полезен при неоднозначных или плохо сформулированных запросах. Потенциальное преимущество агентного подхода — возможность проверить, достаточно ли найденного контекста, и сообщить об этом вместо генерации правдоподобного, но неверного ответа. Гарантий это не дает.
У агентного подхода есть и обратная сторона — ошибки накапливаются по шагам. Если агент неверно оценил промежуточный результат, цикл может уйти в сторону. Каждая итерация добавляет задержку и расходы на токены. Агент с доступом к SQL и API должен работать с минимально необходимыми правами, а его действия нужно логировать. Поэтому качество стоит измерять отдельно: по числу шагов на запрос, стоимости, доле ответов «информации недостаточно».
Заключение
RAG 2.0 и Agentic RAG — логичная эволюция проверенного инструмента. Разумная стратегия — начать с простого RAG для FAQ и типовых справок, а затем постепенно добавлять агентные сценарии: маршрутизацию запросов, планирование, вызовы внешних инструментов и контроль качества ответов. Собрал для вас небольшой чек-лист по применению.
Что из этого забрать себе:
- если большинство запросов простые и однозначные, достаточно классического RAG (он быстрее и дешевле);
- если для ответов на вопросы нужны несколько источников и проверка результата, добавляйте агентный цикл, но с лимитом шагов, логированием и ограничением прав;
- начинайте с простого RAG для FAQ и постепенно добавляйте маршрутизацию, планирование и вызов инструментов.