
В эпоху развития ИИ мы в Selectel с особым вниманием наблюдаем за новинками рынка, которые потенциально могут заменить или дополнить имеющийся арсенал железа для инференса или обучения моделей. Почти каждый месяц очередной стартап объявляет о своих ноу-хау. И пусть до реального использования доходит лишь малая их часть, но мой подход в том, что лучше обозревать десять новинок из десяти и не пропустить ту одну, которая, возможно, изменит рынок. С вами Сергей Ковалёв, менеджер продукта Selectel, а ниже — подробный разбор очередной многообещающей ИИ-архитектуры.
Что появилось
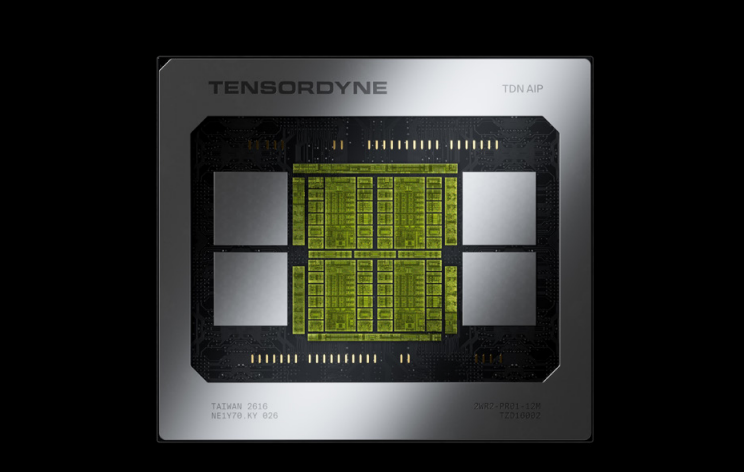
Стартап Tensordyne представил чип Napier™ и стоечную систему на его основе.
Партнерами проекта выступают Broadcom по части кремния и HPE® Juniper Networks® по сетевой части. Производство заявлено на 3-нанометровом процессе TSMC. Из важных заявлений — пройден тейп-аут, то есть финальная версия дизайна чипа отправлена на заводское производство.
Суть архитектуры: логарифмы превращают умножение в сложение. Сумматоры компактнее и экономичнее умножителей, освободившаяся площадь идет под SRAM.
По заявлению компании, на чипе в пять раз больше SRAM, чем у NVIDIA® Blackwell™.
Static Random-Access Memory (SRAM) — это быстрая память прямо на кристалле чипа. В отличие от HBM, которая стоит отдельно рядом с процессором, SRAM «живет» внутри него и работает на порядок быстрее. Производство такой памяти стоит дорого, а на чипе она занимает много площади, поэтому ее объем зачастую небольшой.
В контексте инференса это важно: модель постоянно обращается к весам и KV-кэшу (рабочая память токенов). Чем «ближе» эти данные к вычислительным ядрам, тем быстрее инференс. HBM быстрее обычной DDR-памяти, но все равно медленнее SRAM. Поэтому заявление Tensordyne о пятикратном перевесе SRAM над NVIDIA® Blackwell™ очень похоже на правду. Чем больше SRAM, тем меньше обращений к HBM и потенциально выше реальная пропускная способность на токен.
Характеристики устройств
Чип:
- 138 млрд транзисторов;
- вычислительная мощность: 2,1 петафлопс в формате FP8;
- память: 144 ГБ HBM3E, 256 МБ SRAM на кристалле;
- потребление — 300 Вт (против 1 200 Вт у NVIDIA® B300).
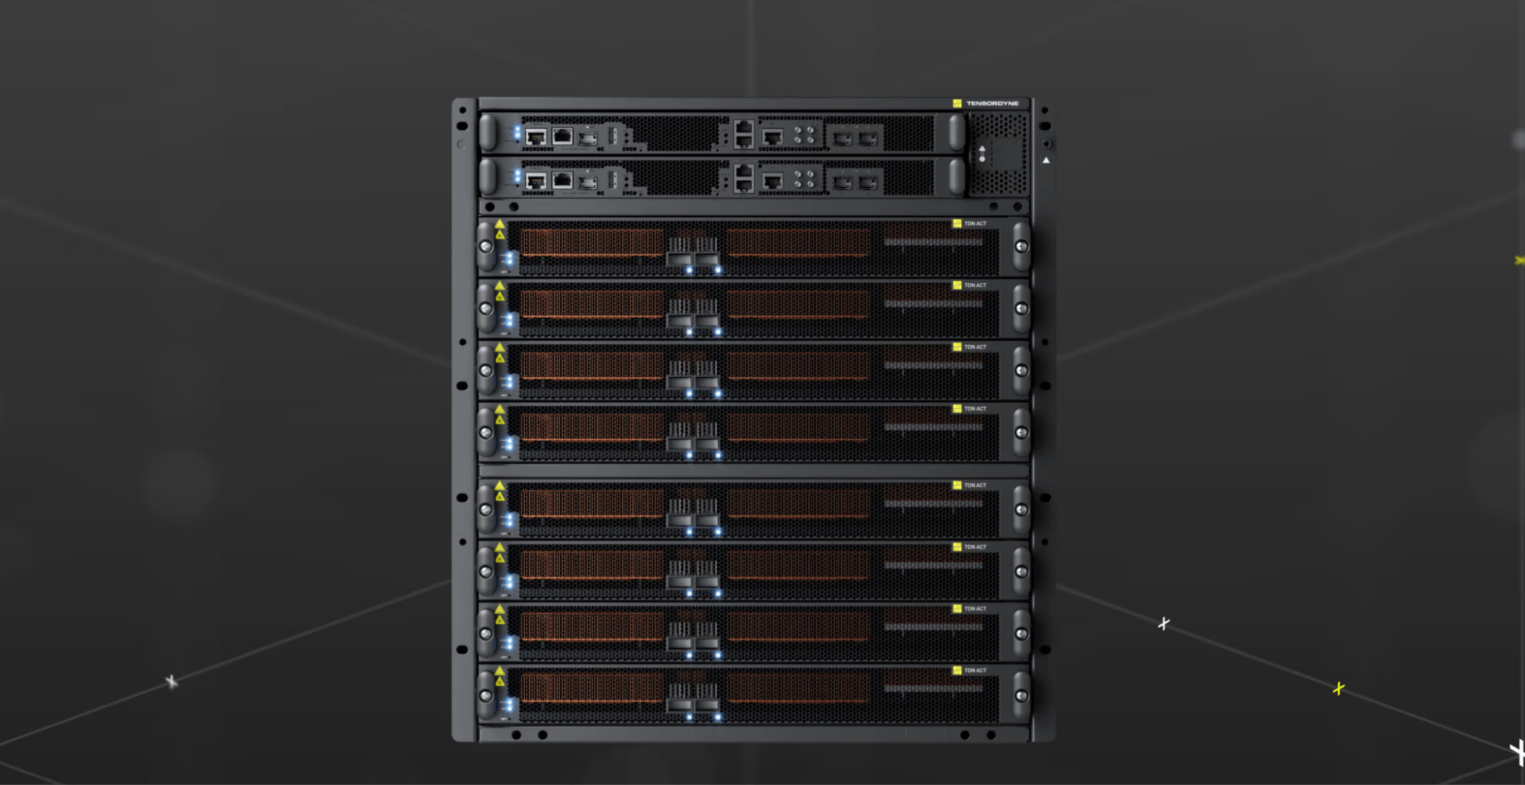
Девять чипов составляют один одноюнитовый узел в паре с 40-ядерным процессором Intel® Xeon® и 8 ТБ NVMe диском.
Восемь таких узлов составляют под TDN72.
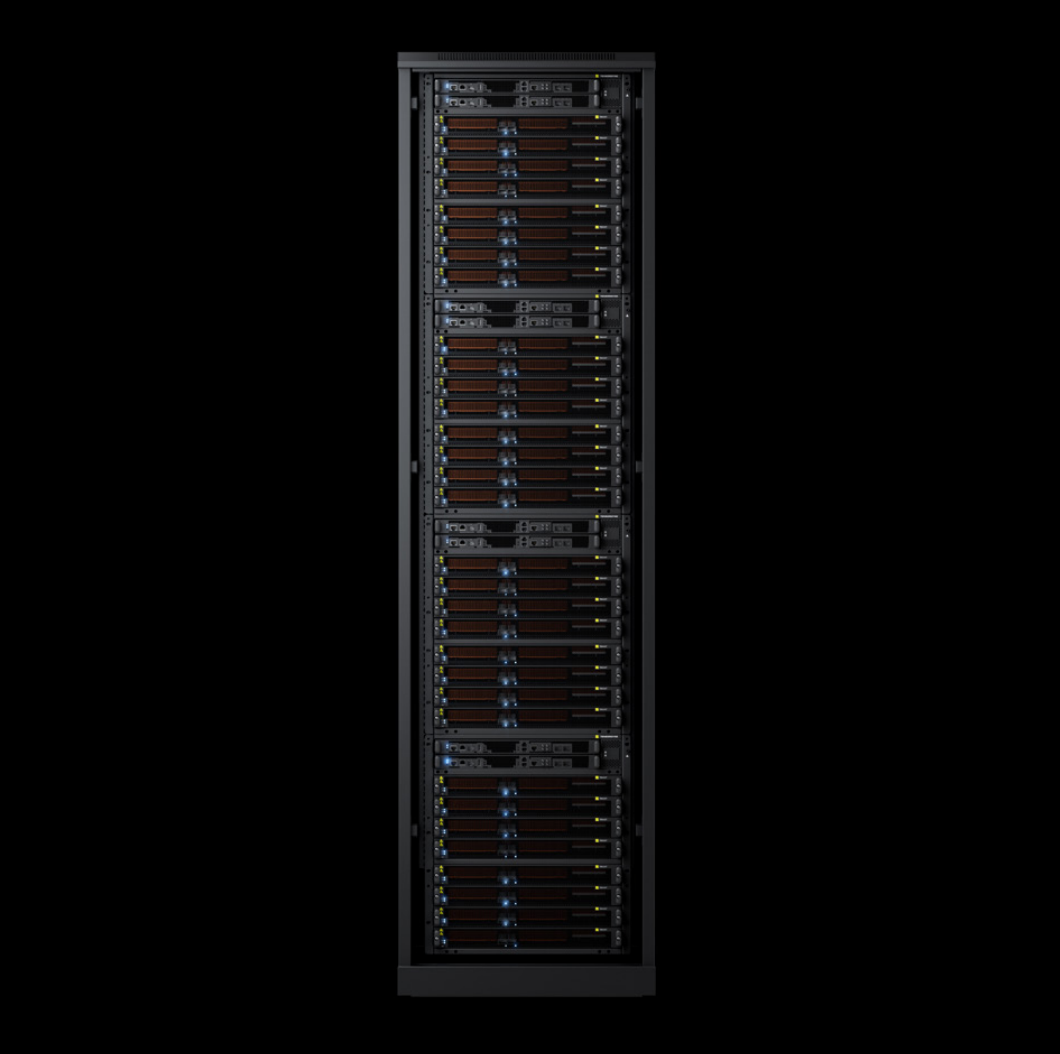
Четыре пода — это полная стойка на 52 юнита:
- вычислительная мощность: 608 петафлопс в формате FP8;
- память:42 ТБ HBM, 74 ГБ SRAM;
- потребление стойки: 120 кВт;
- охлаждение: воздушное, без жидкостного контура.
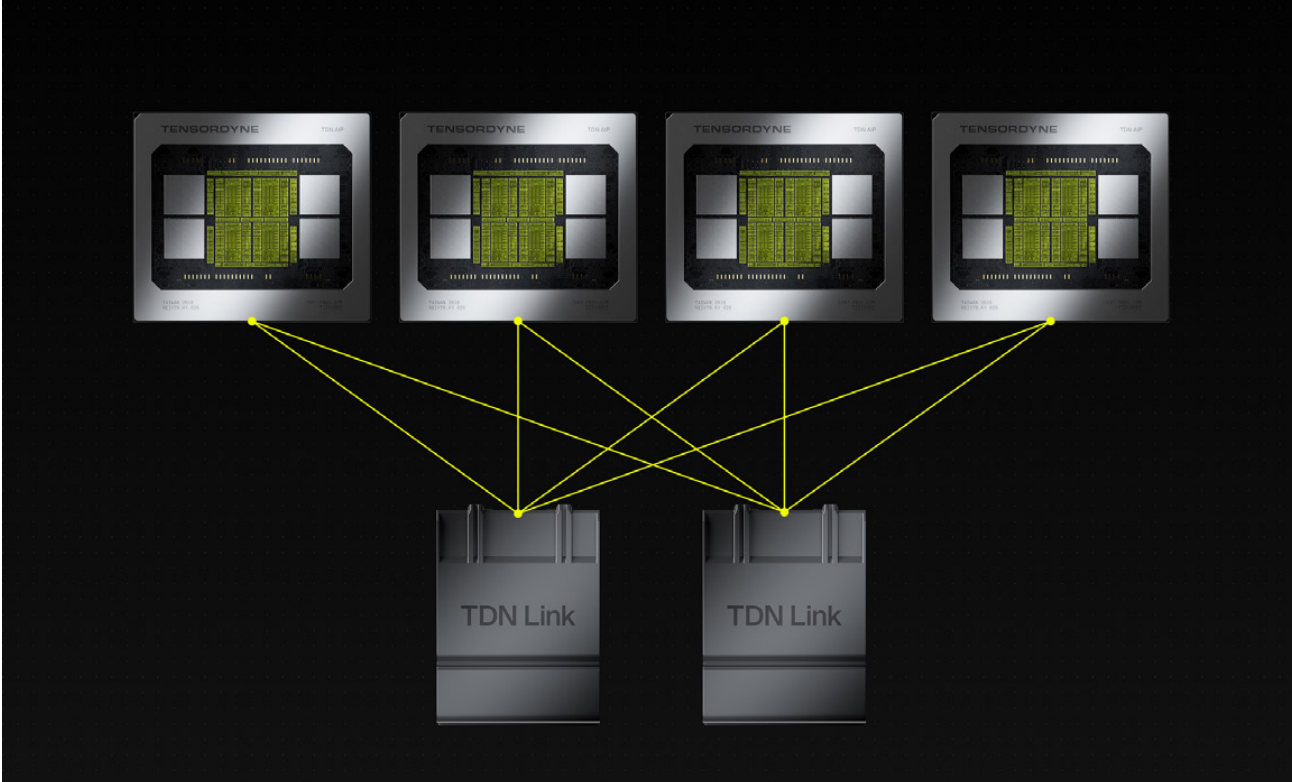
Чипы между собой связывает фирменный интерконнект TDNLink™ с задержкой менее микросекунды и пропускной способностью 1 ТБ/с.
Немного истории
Tensordyne в прошлом назывались Recogni. Они делали чипы для автомобильного компьютерного зрения. Впоследствии компания переключилась на железо для дата-центров и сменила название.
Идея логарифмической математики в нейросетях не нова, такое представление чисел в вычислениях известно как минимум с 1970-х годов. Однако до коммерческого проекта идею никто не доводил. Tensordyne еще под именем Recogni занялся этим в 2019-м, запатентовал собственную аппроксимацию и назвал систему Pareto. В 2021-м прошли tape-out первого чипа Scorpio на 7 нм у TSMC. Napier™ — следующий шаг: уже на архитектуре 3 нм для дата-центров и коммерческого использования.
При написании этих строк вспоминается недавняя новость про Bolt Graphics™ Zeus™. Этот стартап аналогично начинал производить несколько итераций устройств и также обещал новинку, способную отчасти изменить рынок. Пожелаем им всем удачи!
Бенчмарки и цены
Меня, как менеджера продукта, который участвует в выборе железа для наших клиентов, интересует только показатель price/performance (производительность на один рубль затрат). Однако и здесь история похожа на типичную стартаперскую.
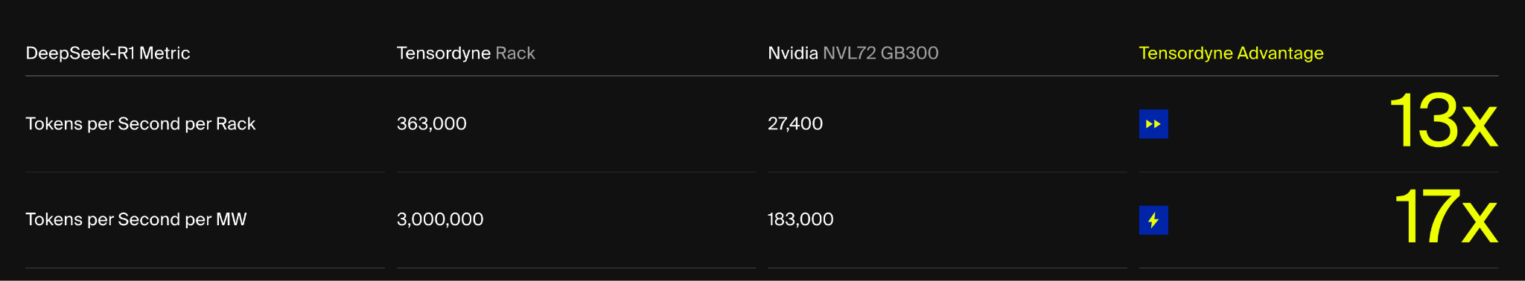
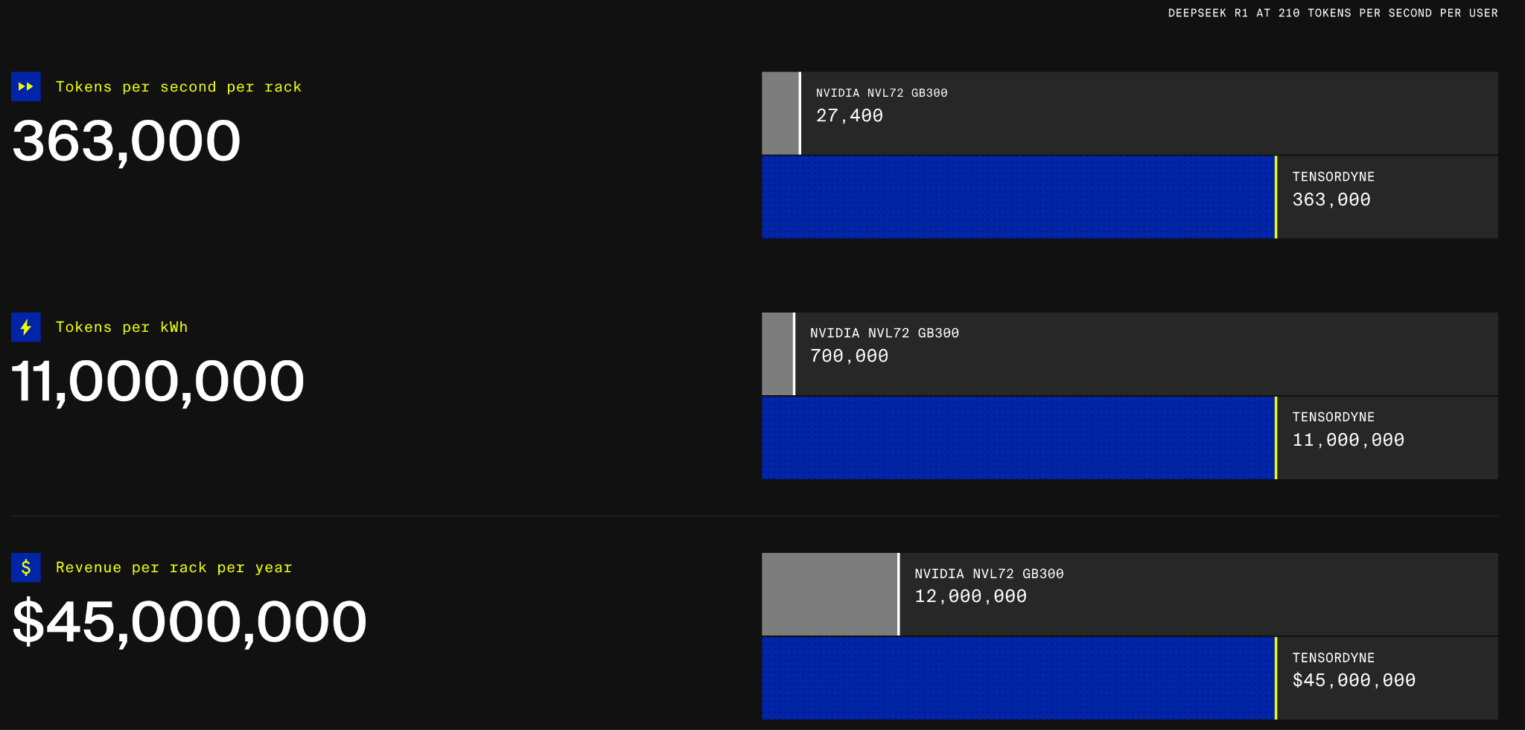
Все цифры пока только от самой Tensordyne, независимого тестирования нет.
Рабочая задача для сравнения — это инференс DeepSeek-R1. На ней компания заявляет 363 000 токенов в секунду на стойку против 27 400 у NVIDIA® GB300 NVL72. Отсюда 13-кратный отрыв по токенам в секунду и 17-кратный по токенам на ватт.
На модели в 2 трлн параметров одна стойка дает 1 300 токенов в секунду на пользователя при 120 кВт. Для сопоставимого результата на Rubin™ + Groq® потребовалось бы девять стоек и 1,5 МВт.
Значительный риск — смена численного подхода с floating point на логарифмическую математику. Это может влиять на точность моделей, и без реального железа это не проверить. Компания утверждает, что программный стек берет конвертацию на себя и дообучать модели не нужно. Независимая верификация должна появиться к первым поставкам.
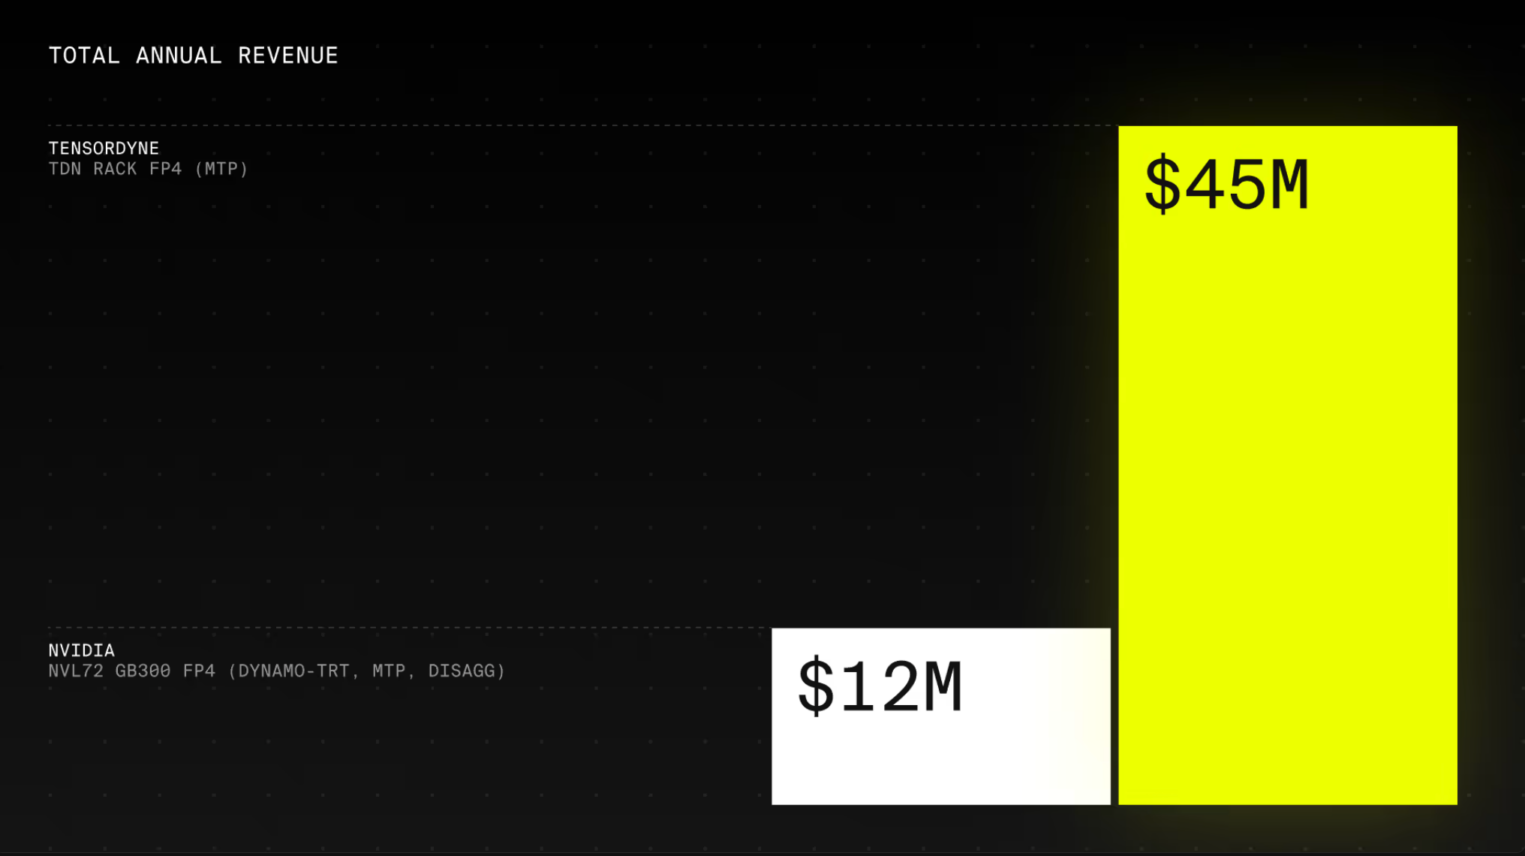
Стоимость стойки публично не называлась и, судя по всему, не будет. Tensordyne позиционирует себя как продавца «экономики», а не железа. Основной аргумент: 11 $ за миллион токенов против 150 $ на стойках NVIDIA. Отсюда появляется тезис про 33 млн $ дополнительной выручки на стойку в год. Реальные прайсы появятся не раньше конца 2026 года при старте продаж проекта, если он, конечно, состоится.
Кто еще в этой нише
- Cerebras — с чипом размером с обеденную тарелку на 850 000 ядер. Заточен под decode, заявляет до 2 000 токенов в секунду. AWS® использует CS-3™ в связке со своим Trainium®.
- Groq® — LPU специально под decode, лицензию которых купила NVIDIA. Tensordyne сравнивает свою стойку именно с комбо NVIDIA® Rubin™ + Groq®.
- Tenstorrent — RISC-V архитектура, последний анонс Galaxy Blackhole™. CEO Джим Келлер считает разделение prefill и decode на разное железо тупиком и строит универсальный ускоритель.
- SambaNova — в феврале 2026-го показала SN50™, заявляет пять иксов для агентных задач. Intel ведет переговоры о покупке стартапа.
- Positron — никакой гибкости, зато заявляют в три раза меньшие задержки и треть энергопотребления против H100 на специализированных задачах.
- Majestic Labs Prometheus — израильско-американский стартап, заходит с другой стороны. Упор сделан не на вычисления, а на память. В одном сервере Prometheus™ умещается до 128 ТБ LPDDR6 — примерно в 100 раз больше, чем у DGX B200. Внутри собственный чип Ignite™ на ARM® + RISC-V, который разделяет единое адресное пространство памяти со всеми вычислительными элементами. Поддерживает PyTorch®, vLLM и Triton™ без изменений в коде.
- Lumai Iris — оксфордский стартап, спин-офф университетской лаборатории оптики. Iris заменяет электронные вычисления оптическими: операции выполняются светом, за счет пространственного параллелизма одновременно обрабатываются миллионы операций. Заявляют до 90% снижения энергопотребления против обычных архитектур. Пока тянет только модели до 70 млрд параметров. Изделие целится в prefill-стадию дизагрегированного инференса.
Заключение
Итак, Tensordyne меняет саму математику внутри чипа и строит новую архитектуру устройств. Пройден tape-out и запущено производство, а значит привлечены инвестиции. На лендинге всё выглядит убедительно.
Но остаются риски: из очевидного — стартап есть стартап. Между tape-out и коммерческими поставками — длинная дорога, на которой как раз и пропал не один стартап. Graphcore прошла путь от громких анонсов до поглощения SoftBank. Untether AI купил AMD. SambaNova продается Intel по цене, которую аналитики называют отличной для покупателя, с учетом вложенных в проект 1,1 млрд $.
Если железо все-таки доедет до заказчиков, то вопросы все еще не заканчиваются. Логарифмическая математика меняет то, как чип считает числа, и последствия этого для точности моделей на реальных нагрузках пока неизвестны. Компания говорит, что программный стек берет конвертацию на себя и дообучать модели не нужно, но насколько это правда для нестандартной архитектуры, квантизованных весов и всего разнообразия форматов, которые используются в индустрии, покажет только практика. Заявленные SDK на Hugging Face и поддержка PyTorch/Triton будут хорошим началом. Но CUDA — это накопленная годами экосистема инструментов, паттернов и экспертизы у команд. Порог входа для клиентов, которые сегодня запускают инференс на NVIDIA, может оказаться выше, чем позитивно обещает маркетинг Tensordyne.
Отдельный вопрос — цена адаптации. Даже если модели не нужно переобучать, инфраструктуру, мониторинг, деплой-пайплайны и отладочные инструменты придется переписывать или адаптировать.
При всем этом мы продолжаем следить за такими проектами и хотим их видеть. Рынок серверного инференса слишком долго жил в условиях фактической монополии одного вендора. Любая серьезная альтернатива — это хорошо. Для цен, для разнообразия архитектур, для инженерной мысли в целом. Ждем запуска проекта, цен и первого продового железа, успеха им всем!