LLM стали привычным инструментом: кто-то использует их как продвинутый поиск, кто-то просит объяснить сложную тему, написать код или накидать идей. Часто можно услышать, как ИИ-агенты самостоятельно решают ту или иную практическую задачу.
Сегодня мы не будем использовать фреймворки для создания агентов или готовые решения по типу OpenCode, материал рассчитан на тех, кто только начинает погружаться в тему и не обладает глубокими техническими знаниями. Мы пошагово пройдем путь от теории до создания вашего первого работающего агента.
Зачем создавать своего агента, если есть готовые решения? Во-первых, это позволит разобраться в вопросе и при необходимости гибко настроить логику под свои процессы. Во-вторых, в свете недавних блокировок сервисов собственная независимая разработка — это самый надежный способ сохранить доступ.
План на сегодня:
- кратко разберем, что такое ИИ-агент;
- научим модель вызывать инструменты;
- соберем все вместе в CLI-приложение.
Что такое ИИ-агент
Прежде чем мы начнем писать код и автоматизировать все подряд, давайте определимся с матчастью, чтобы случайно не собрать скрипт, который просто очень вежливо будет спамить нас ошибками.
Не раз слышал сравнение: LLM — это как хороший стажер: много знает, не устает, быстро разбирается в задаче, но результат его работы лучше перепроверять.
Продолжая эту аналогию, я бы добавил, что LLM — это стажер в закрытой комнате. Ему можно дать описание задачи или кусок кода — и он попробует предположить, что происходит. А агент — это стажер, которому дали ноутбук с доступами.
Теперь он может не только «рассуждать», но и взаимодействовать с внешним миром: подключиться к базе, обратиться к API, прочитать документацию, запустить заранее подготовленный скрипт.
В буквальном смысле агент — это обычная программа, которая может сходить в базу, отправить запрос в API, и так далее. По сути, это посредник между LLM и внешними инструментами, но в отличие от обычного скрипта с заранее заданной последовательностью действий, он использует LLM для выбора следующих шагов в зависимости от задачи и полученных результатов.
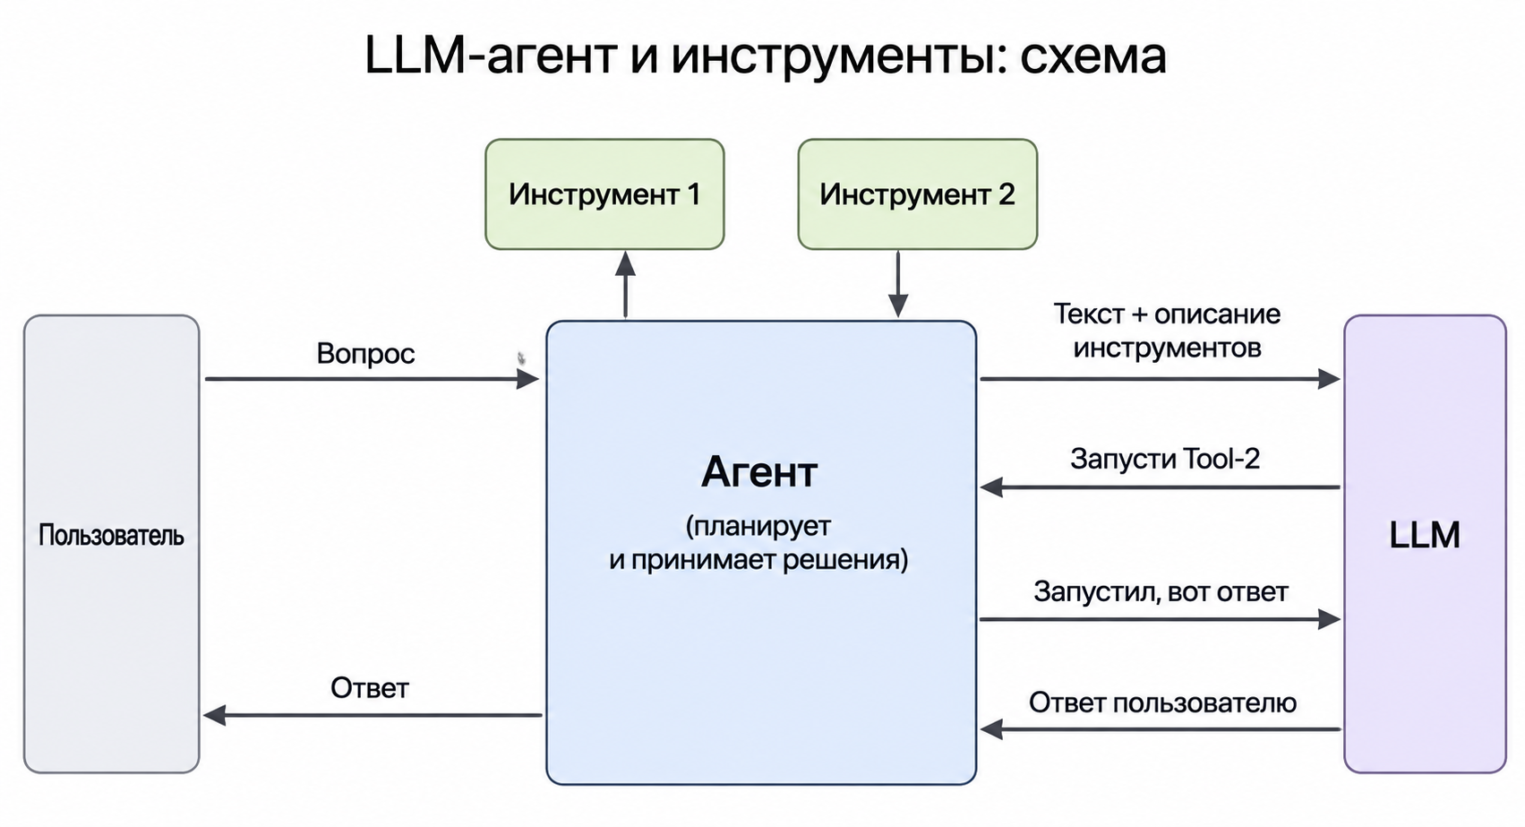
В этой статье агентом будем называть программу-прослойку: обычный код, который передает задачу LLM вместе с описанием инструментов, выполняет вызовы, о которых попросила модель, и возвращает результаты обратно в LLM.
LLM — мозг, отвечает за логику, получает задачу на естественном языке и решает, что нужно сделать: какой инструмент вызвать, в каком порядке и как использовать полученный результат.
Инструменты — внешние функции или скрипты, которые агент вызывает для выполнения действий во внешних системах: проверить доступность хоста, найти данные в документации, подключиться к оборудованию.
Важно понимать, что LLM сама ничего не вызывает: она по своей природе не может этого делать. LLM, имея контекст задачи и лишь информацию об инструментах, в определенном формате генерирует текст о том, что надо бы вызвать эту функцию для решения задачи.
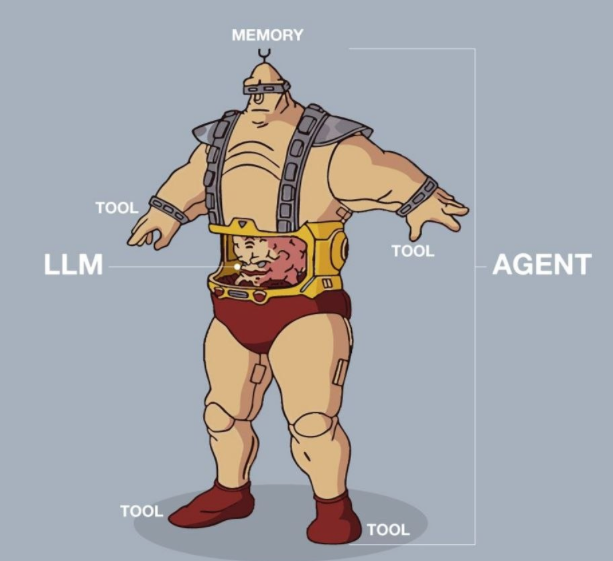
Из чего будет состоять агент
Есть несколько подходов к архитектуре ИИ-агентов: можно использовать несколько агентов с разными ролями, графы состояний, отдельные этапы планирования и проверки результата.
Мы начнем с простого варианта — single-agent. Это подход, при котором вся логика рассуждений, планирования и выполнения задач выполняется в одном агенте.
Из чего будет состоять наша система:
- LLM — «мозг» агента, модель анализирует запрос, выбирает нужные инструменты и формирует итоговый ответ;
- Tools — «руки» или набор функций, через которые агент может выполнять действия: проверять доступность хоста, искать данные в документации, ходить в API;
- CLI — наша точка входа, в которой мы будем ставить задачи агенту.
Схема работы
В обычном чате с LLM, с точки зрения пользователя, все прямолинейно: пишем запрос, модель как-то обрабатывает его и генерирует ответ.
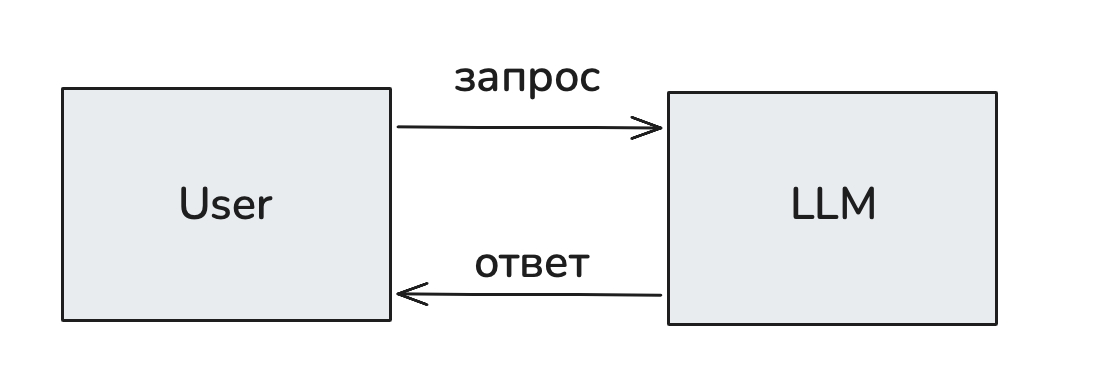
В случае с агентом, появляется дополнительный цикл. Вместе с запросом пользователя на вход модели передается описание доступных инструментов.
Модель решает, нужен ли ей один из этих инструментов, если нужен, вызывается соответствующая функция, результат работы которой снова передается в модель. Такой цикл может повторяться несколько раз, пока модель не соберет достаточно информации для финального ответа.
Пишем агента
В первую очередь нам нужна модель, с которой можно взаимодействовать через API.
Если у вас уже есть доступ к такой модели, можно переходить дальше. Если нет, один из самых простых путей — запустить небольшую модель через Ollama: как ее установить, мы разобрали в «Как запустить Gemma на сервере: сравниваем Ollama и llama.cpp». Сервер пригодится, если модели не хватает памяти или нужен GPU, а доступ к ней нужен не только с одного компьютера.
Можно запустить и локально, в примерах я буду использовать модель qwen2.5:3b: она умеет вызывать инструменты и для сегодняшней демонстрации ее хватит. Я запускаю ее через Ollama на Macbook, но код от места запуска не зависит: чтобы перейти на сервер, достаточно поменять адрес в параметре base_url.
Что понадобится
Чтобы повторить пример, подготовьте:
- Ollama, запущенную на вашем компьютере или на сервере;
- модель с поддержкой вызова инструментов (tool calling);
- Python — в коде есть запись list[dict] | None, поэтому подойдет 3.10 и новее;
- библиотеку requests
- утилиту grep — в macOS и Linux она доступна сразу
- папку проекта с каталогом repo — в нем агент будет искать по коду.
Необязатально использовать Ollama, можно локально запустить llama.cpp или LM Studio, в таком варианте придется немного корректировать URL API, в остальном все будет так же.
API
Предполагаю, что Ollama уже установлена и модель скачана. Проверим, что к Ollama можно обратиться по HTTP.
Сначала посмотрим список доступных моделей:
curl http://localhost:11434/api/tagsЕсли все настроено правильно, в ответе будет JSON со списком моделей, которые уже скачаны:
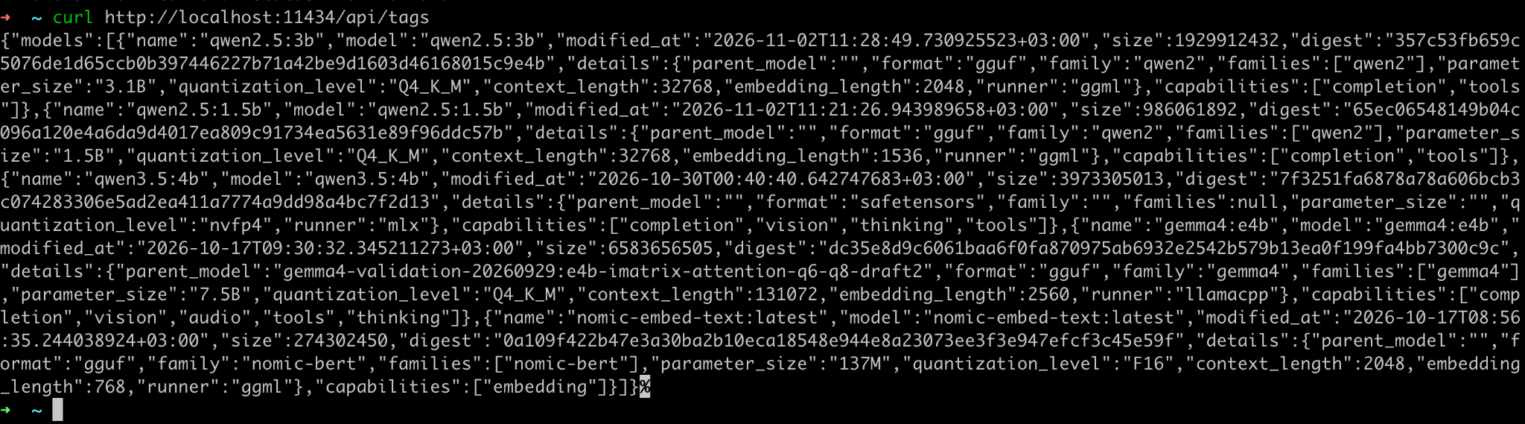
Теперь отправим тестовый запрос в /api/chat
По умолчанию Ollama может отдавать ответ в streaming-режиме — небольшими чанками по мере генерации. Если нужен только готовый ответ, можно указать "stream": false:
      curl http://localhost:11434/api/chat \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen2.5:3b",
    "messages": [
      {
        "role": "user",
        "content": "Hello!"
      }
    ],
    "stream": false
  }'
и получаем один финальный JSON-ответ.
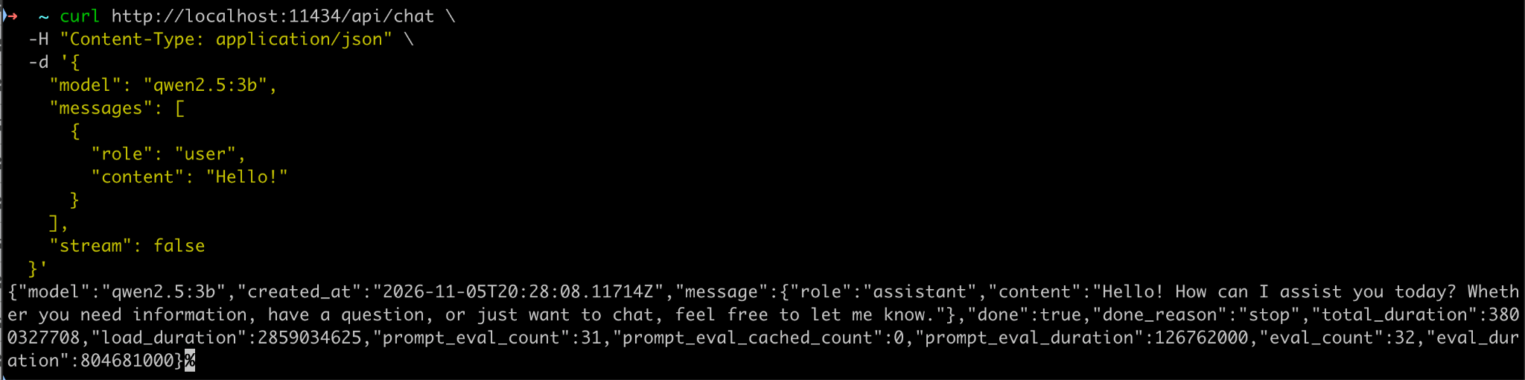
На этом этапе важно убедиться, что нужная модель загружена и отвечает на HTTP-запросы. Если все работает, можно переходить дальше.
Пробуем Tool Calling
Мы уже можем отправлять запросы в модель по HTTP и получать ответы. Но пока это мало отличается от простого чата: передаем текст в LLM и получаем текст обратно.
Попробуем немного расширить наш запрос. Добавим поле tools, в котором опишем функцию grep. Она будет искать текст в файлах проекта.
Для начала самой функции еще не существует. Мы только сообщим модели, что такой инструмент доступен, какие аргументы он принимает и для чего предназначен.
      curl http://localhost:11434/api/chat \
-H "Content-Type: application/json" \
  -d '{
    "model": "qwen2.5:3b",
    "messages": [
      {
        "role": "user",
        "content": "Найди в проекте определение функции ping_host"
      }
    ],
    "tools": [
      {
        "type": "function",
        "function": {
          "name": "grep",
          "description": "Ищет текст или регулярное выражение в файлах проекта",
          "parameters": {
            "type": "object",
            "properties": {
              "pattern": {
                "type": "string",
                "description": "Что нужно найти"
              },
              "path": {
                "type": "string",
                "description": "Путь к файлу или директории"
              }
            },
            "required": ["pattern"]
          }
        }
      }
    ],
    "stream": false
  }'
Здесь мы передали модели описание инструмента grep и его JSON-схему. В ответе вместо обычного текстового сообщения модель может вернуть tool_calls:
      {
  "role": "assistant",
  "content": "",
  "tool_calls": [
    {
      "function": {
        "name": "grep",
        "arguments": {
          "pattern": "def ping_host",
          "path": "."
        }
      }
    }
  ]
}

Модель проанализировала запрос и решила, что для его выполнения нужно воспользоваться инструментом grep. Она сформировала название функции и аргументы, с которыми ее необходимо вызвать.
На этом этапе никакого поиска еще не произошло. LLM не выполняет функции, скрипты или команды. Она лишь возвращает структурированную инструкцию для нашей программы.
Именно наша программа должна получить tool_calls, найти соответствующую функцию, передать ей аргументы и выполнить ее.
Результат выполнения инструмента затем можно отправить обратно в LLM, чтобы модель использовала полученную информацию для формирования ответа пользователю. Таким образом, у нас появляется основной механизм, на котором строится работа простого ИИ-агента.
LLMClient
Отправлять запросы через curl удобно для первых экспериментов, но в дальнейшем нам придется обращаться к модели из Python-кода.
Чтобы не дублировать HTTP-запросы по всему проекту, напишем небольшой клиент LLMClient.
Его задача — отправлять сообщения модели и возвращать полученный ответ. Также предусмотрим возможность передавать список доступных инструментов через параметр tools.
      import requests
class LLMClient:
    def __init__(self, base_url: str, model: str, timeout: int = 120):
        self.url = f"{base_url}/api/chat"
        self.model = model
        self.timeout = timeout
    def chat(self, messages: list[dict], tools: list[dict] | None = None) -> dict:
        payload = {
            "model": self.model,
            "messages": messages,
            "stream": False,
            "options": {"temperature": 0},
        }
        if tools:
            payload["tools"] = tools
        resp = requests.post(self.url, json=payload, timeout=self.timeout)
        resp.raise_for_status()
        return resp.json()["message"]  # role, content, tool_calls
Разберем, что здесь происходит. В __init__ передаем адрес API и название модели. Метод chat() принимает историю сообщений messages и необязательный список инструментов tools. Если инструменты переданы, добавляем их описание в HTTP-запрос, после чего отправляем его к Ollama и возвращаем сообщение модели.
Метод возвращает не просто текст, а весь объект message. В нем может находиться как обычный текстовый ответ в поле content, так и запрос на вызов инструмента в tool_calls.
Это позволит нам использовать один и тот же клиент как для обычного общения с моделью, так и для построения агента. Проверим:
      >>>
>>> llm = LLMClient("http://localhost:11434", "qwen2.5:3b")
>>>
>>>
>>>
>>> response = llm.chat([
...     {
...         "role": "user",
...         "content": "Сколько хостов в 29 подсети?"
...     }
... ])
>>> print(response["content"])

Для того чтобы ответить на ваш вопрос, мне нужно знать маску подсети (subnet mask) или диапазон IP-адресов этой подсети.

В интернете можно найти информацию о маске подсети для каждой подсети, но без дополнительной информации я не могу точно сказать, сколько хостов в 29-й подсети.

Если маска подсети для этой подсети будет 29, то это означает, что это очень маленькая подсеть, и она будет содержать всего 2 хоста (один адрес для подсети и один для буферного адреса).

Пожалуйста, предоставьте дополнительную информацию, чтобы я мог вам помочь более точно.
Получился довольно развернутый ответ, да к тому же с фактической ошибкой. Модель не поняла, что речь идет о префиксе /29, и начала додумывать контекст.
Такие ситуации можно частично контролировать с помощью системного промпта: задать формат и ограничения ответа, уточнить правила интерпретации запросов. Также можно использовать Structured Output, чтобы ограничить формат генерируемого ответа заданной схемой.
TOOLS
После реализации клиента нам нужно подготовить сам инструмент, который агент сможет вызывать. Инструменты — это обычные Python-функции, которые мы разрешаем вызывать модели.
В качестве первого инструмента добавим поиск по исходному коду проекта, для этого воспользуемся системной утилитой grep, которую вызовем из Python.
Можно было бы предоставить агенту полноценный доступ к Bash, но для нашего примера это избыточно. Вместо этого ограничимся одной конкретной операцией — поиском по файлам, такой «READ ONLY BASH».
Почему не RAG? В нашем случае нам нужен точный поиск по исходному коду: найти определение функции, название класса или конкретную строку из traceback. Семантический поиск здесь не является основной задачей.
И даже там, где семантика нужна, у эмбеддингов есть слабое место — точные идентификаторы. Эмбеддинг кодирует смысловую близость, а названия вроде prod-db-01 и prod-db-02 для него почти неотличимы, хотя с точки зрения инфраструктуры это совершенно разные хосты. Поэтому в реальных системах используют гибридный поиск. Нам это пока не нужно: grep решает нашу задачу напрямую, без векторной базы и индексов.
Сначала подготовим необходимые настройки:
      import subprocess
from pathlib import Path

REPO_ROOT = Path("./repo").resolve()  # директория проекта, доступная агенту

MAX_LINES = 50                       # максимальное количество результатов

EXCLUDE_DIRS = [".git", "venv", ".venv", "__pycache__", "node_modules"]
Здесь:
- REPO_ROOT — корневая директория проекта, в которой разрешен поиск;
- MAX_LINES — ограничение количества возвращаемых совпадений, чтобы не перегружать контекст модели;
- EXCLUDE_DIRS — директории, которые не нужно проверять.
Теперь реализуем саму функцию:
      def grep(pattern: str, path: str = ".") -> str:

    """Ищет pattern в файлах репозитория. Возвращает строки вида файл:строка:текст."""

    target = (REPO_ROOT / path).resolve()

    if not target.is_relative_to(REPO_ROOT):
        return f"Ошибка: путь {path} вне репозитория"

    if not target.exists():
        return f"Ошибка: путь {path} не найден"
    cmd = ["grep", "-rnHIE"]
    cmd += [f"--exclude-dir={d}" for d in EXCLUDE_DIRS]
    cmd += ["--", pattern, str(target)]

    try:
        result = subprocess.run(
            cmd,
            capture_output=True,
            text=True,
            timeout=10
        )

    except subprocess.TimeoutExpired:

        return "Ошибка: поиск занял слишком много времени, уточни pattern или path"

    if result.returncode == 1:

        return f"Ничего не найдено по '{pattern}'"

    if result.returncode != 0:

        return f"Ошибка grep: {result.stderr.strip()}"

    lines = [

        line.replace(str(REPO_ROOT) + "/", "", 1)

        for line in result.stdout.splitlines()

    ]

    if len(lines) > MAX_LINES:

        return "\n".join(lines[:MAX_LINES]) + (

            f"\n... и еще {len(lines) - MAX_LINES} совпадений, уточни pattern"
        )

    return "\n".join(lines)
Path.resolve() преобразует путь в абсолютный и позволяет проверить, не пытается ли пользователь выйти за пределы разрешенной директории, а is_relative_to() защищает от поиска за пределами REPO_ROOT. Системную утилиту grep запускает subprocess.run(), при этом timeout=10 ограничивает время выполнения поиска. После этого returncode позволяет определить, были ли найдены совпадения или произошла ошибка, а MAX_LINES ограничивает объем результата, который впоследствии попадет обратно в контекст LLM.
Теперь у нас есть обычная Python-функция. Но этого недостаточно: модели еще нужно объяснить, что это за инструмент, когда его использовать и какие аргументы передавать.
Для этого подготовим JSON-схему:
      GREP_SCHEMA = {
    "type": "function",
    "function": {
        "name": "grep",
        "description": (
            "Ищет текст или регулярное выражение в файлах проекта. "
            "Используй для поиска функций, классов и переменных. "
            "Если пользователь прислал traceback, ищи по имени функции "
            "или имени файла из traceback, а не по всему тексту traceback. "
            "Возвращает строки в формате файл:номер_строки:текст."
        ),
        "parameters": {
            "type": "object",
            "properties": {
                "pattern": {
                    "type": "string",
                    "description": "Что искать, например 'def get_user' или 'KeyError'",
                },
                "path": {
                    "type": "string",
                    "description": "Папка или файл внутри проекта, по умолчанию весь проект",
                },
            },
            "required": ["pattern"],
        },
    },
}
В схеме мы описываем:
name— название инструмента, по которому наша программа сможет найти соответствующую функцию;description— назначение инструмента и ситуации, в которых его стоит использовать;parameters— описание аргументов, их типов и обязательности.
Это нужно, так как модели будет передан именно интерфейс функции, а не ее исходный код. В итоге у нас есть две независимые части: grep() — реальная реализация инструмента на Python и GREP_SCHEMA — описание инструмента, которое мы передадим LLM.
На следующем этапе свяжем их между собой, чтобы модель могла не только попросить вызвать grep, но и получить результат его выполнения.
Agentic Loop
У нас уже есть модель, HTTP-клиент для взаимодействия с ней и первый инструмент grep. Осталось связать все это в единую систему.
Для этого реализуем основной цикл агента (Agentic Loop). Его задача — управлять взаимодействием между LLM и инструментами: передавать модели запрос пользователя и описание доступных инструментов, обрабатывать запросы на их вызов и возвращать результаты обратно модели.
Цикл будет повторяться до тех пор, пока модель не сформирует окончательный ответ или не будет достигнут установленный лимит шагов.
Этот цикл — известный паттерн ReAct: Reasoning + Acting.
На каждом шаге модель анализирует полученный результат, определяет следующее действие, выполняет его и оценивает результат. Цикл повторяется, пока задача не будет решена.
Можно воспользоваться готовыми фреймворками, например LangChain, но в этой статье реализуем механизм самостоятельно. Так мы лучше поймем, что происходит внутри агента и как устроено взаимодействие с инструментами.
Регистрируем инструменты и задаем системный промпт
      from llm_client import LLMClient
from grep import grep, GREP_SCHEMA

# Сопоставляем названия инструментов с Python-функциями
TOOLS = {"grep": grep}

# Описания инструментов, которые передаем модели
TOOL_SCHEMAS = [GREP_SCHEMA]

# Супер важно задать правила работы, aka делай хорошо, не совершай ошибок
SYSTEM_PROMPT = """

Ты помощник SRE-инженера. Твоя задача — находить причины ошибок в коде проекта.

Если пользователь прислал traceback:

1. Определи тип исключения.
2. Найди в traceback файл, номер строки и имя функции.
3. Не пытайся искать весь текст traceback в исходниках.
4. Используй grep, чтобы найди функцию или соответствующий участок кода.
5. Изучи найденный код и объясни причину ошибки.
6. Предложи исправление.

Если информации недостаточно, выполни дополнительный поиск.
Не выдумывай результаты. Опирайся только на найденный код
"""
Реализуем Agentic Loop
      def run_agent(llm: LLMClient, task: str, max_steps: int = 8) -> str:
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": task},
    ]
    print(f"\n[USER] {task}")
    for step in range(1, max_steps + 1):
        print(f"\n{'=' * 20} ШАГ {step} {'=' * 20}")
        msg = llm.chat(messages, tools=TOOL_SCHEMAS)
        messages.append(msg)

        # Что вернула модель
        content = msg.get("content", "")
        if content:
            print(f"\n[LLM]\n{content}")
        tool_calls = msg.get("tool_calls")

        # Модель решила не вызывать инструменты
        if not tool_calls:
            print("\n[AGENT] Работа завершена")
            return content

        # Обрабатываем запросы на вызов инструментов
        for call in tool_calls:
            name = call["function"]["name"]
            args = call["function"]["arguments"]
            print(f"\n[TOOL CALL] {name}")
            print(f"[ARGS] {args}")
            func = TOOLS.get(name)
            if func is None:
                result = f"Ошибка: инструмента {name} нет"
            else:
                try:
                    result = func(**args)
                except Exception as e:
                    result = f"Ошибка: {e}"
            print(f"\n[TOOL RESULT]\n{result}")
            messages.append({
                "role": "tool",
                "tool_name": name,
                "content": str(result),
            })
    print("\n[AGENT] Превышен лимит шагов")
    return "Остановился: превышен лимит шагов"
Что здесь происходит по шагам:
- получаем задачу пользователя;
- отправляем запрос модели вместе с описанием доступных инструментов;
- модель решает, нужно ли вызвать инструмент;
- если модель запросила инструмент — Python выполняет соответствующую функцию;
- результат выполнения возвращается модели;
- цикл повторяется, пока модель не даст финальный ответ или не закончится лимит шагов.
В коде оставим несколько print(), чтобы видеть, как агент взаимодействует с моделью, потом их можно убрать. Для ввода запроса добавим отдельную функцию. Она позволяет передавать многострочный текст, например traceback из Sentry.
      def read_task():
    print("Опиши проблему (для завершения нажми Enter на пустой строке):")
    lines = []
    while True:
        line = input()
        if not line:
            break
        lines.append(line)
    return "\n".join(lines)
Теперь добавим точку входа:
      if __name__ == "__main__":
    llm = LLMClient(
        base_url="http://localhost:11434",
        model="qwen2.5:3b",
    )

    task = read_task()
    answer = run_agent(llm, task)
    print("\nОтвет агента:")
    print(answer)
В директории, доступной агенту (у нас это ./repo), создадим файл very_big_code_base.py и напишем там одну функцию:
      def powerful_calculation():
    return 1 / 0
Тестовый запуск
Представим, что в Sentry прилетел следующий traceback:
      Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "/Users/<username>/agent/repo/very_big_code_base.py", line 4, in powerful_calculation
    return 1 / 0
           ~~^~~
ZeroDivisionError: division by zero
У нас большая и запутанная кодовая база, поэтому разбирать этот traceback, попросим агента. Передадим traceback нашему агенту и попросим разобраться в проблеме.
      agent python3 agent.py

Опиши проблему (для завершения нажми Enter на пустой строке):

Помоги найти причину ошибки
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "/Users/<enginiiga>/agent/repo/very_big_code_base.py", line 4, in powerful_calculation
    return 1 / 0
           ~~^~~
ZeroDivisionError: division by zero
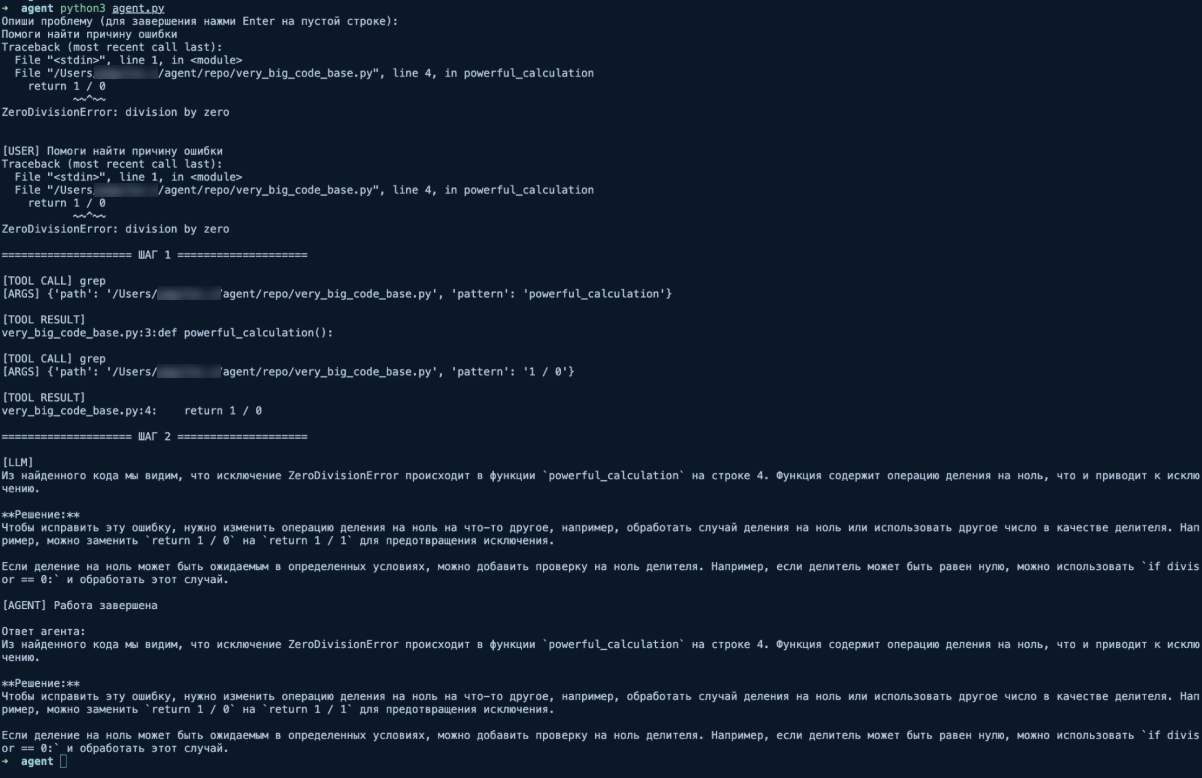
Видим, что на первой итерации LLM анализирует traceback и определяет, что нужно найти функцию powerful_calculation. Модель вызывает grep дважды: сначала ищет функцию, затем конкретную проблемную операцию 1 / 0.
Python выполняет поиск и возвращает найденные строки модели.
LLM анализирует исходный код, определяет причину ZeroDivisionError и предлагает варианты исправления, на этом агент завершает работу и возвращает ответ пользователю.
Добавим простой CLI
Чтобы не запускать агента заново для каждого запроса, добавим простой интерактивный цикл. Сможем вводить задачи одну за другой, а для выхода использовать команду exit.
      if __name__ == "__main__":
    llm = LLMClient(
        base_url="http://localhost:11434",
        model="qwen2.5:3b",
    )

    print("ИИ-агент запущен. Для выхода введи exit.")
    while True:
        task = read_task()
        if task.strip().lower() == "exit":
            break
        if not task.strip():
            continue
        answer = run_agent(llm, task)
        print("\nОтвет агента:")
        print(answer)
        print("\n" + "=" * 50)
Заключение
Получился игрушечный, но рабочий пример, который можно повторить самостоятельно и использовать как основу для собственных экспериментов.
В нашем примере grep ищет по исходному коду проекта. Но ничто не мешает заменить его инструментами для работы с Docker, базами данных или сетевым оборудованием. Так можно перейти от простого эксперимента к автоматизации реальных инфраструктурных задач. Можно развить этот прототип, реализовать память агента, изучить Structured Output и подключить внешние каналы взаимодействия.
Основная цель статьи — показать, что происходит внутри той самой «черной коробки», которую часто называют ИИ-агентом. За этим термином нет загадки: есть LLM, набор инструментов и программный цикл, который связывает их воедино. Понимая этот механизм, гораздо проще самостоятельно создавать агентов под конкретные задачи.