Итак, у нас есть данные в S3‑хранилище, аккуратно организованные средствами Iceberg, и каталог, который знает расположение актуальной версии каждой таблицы. Казалось бы, все готово.
Однако при ручном просмотре S3-бакета ничего похожего на таблицу не обнаружится — видны лишь вложенные папки с Parquet-файлами и JSON-метаданными. Iceberg и каталог решили задачу хранения и версионирования, но не ответили на вопрос, как читать эти данные с помощью SQL.
И вот возникает практическая задача: как аналитику или инженеру обратиться к Iceberg-таблице посредством SQL, не поднимая Spark-кластер и не перенося данные в отдельную СУБД?
Привет! Я Денис, старший бэкенд-разработчик в Selectel. В предыдущих частях мы познакомились с архитектурой Apache Iceberg, а также развернули и настроили каталог метаданных. Сегодня на очереди — вычислительный движок.
Раньше в похожих ситуациях всю информацию банально копировали — заливали в PostgreSQL или ClickHouse, и уже там создавали SQL‑запросы. Однако при таком подходе теряется весь смысл озера данных — те снова оказываются привязаны к конкретной СУБД, дублируются, приходится каждый раз думать о синхронизации. Путь должен быть прямой, а не извилистый — выполнять SQL‑запросы прямо там, где данные уже хранятся, без дополнительного их перетаскивания.
В первой части мы разобрались, зачем современному озеру данных нужен табличный формат Apache Iceberg.
Во второй части подняли каталог метаданных — HMS 4.2.0 с REST Catalog на порту 8080. Также выяснили, как именно он обеспечивает атомарное переключение указателя на metadata.json, без которого параллельные читатели видели бы разные версии одной и той же таблицы). Заодно разобрались, чем же этот конфигурационный файл является на самом деле.
Значит, нужен некий инструмент, способный читать Iceberg-таблицы. Эту задачу и решает вычислительный движок, который работает через каталог HMS и предоставляет к ним доступ посредством стандартного интерфейса SQL.
Исторически, HMS (Hive Metastore Service) — это компонент системы Apache Hive из экосистемы Hadoop. Cо временем он оказался настолько удобным, что стал индустриальным стандартом для хранения метаинформации в современных озерах данных, даже если сам Hive для вычислений уже не используется.
Сравнение вычислительных движков
Прежде чем выбирать вариант под конкретную платформу, стоит разобраться в самом понятии «вычислительный движок» и причинах их многообразия на рынке.
Вычислительный движок работает как «библиотекарь» По сути, это программный слой, который принимает SQL‑запрос, определяет оптимальный план его выполнения, обращается к источнику и возвращает результат.
Различия между движками в том, откуда они забирают данные, как распределяют работу между машинами и для какого паттерна нагрузки изначально проектировались. Одни создавались как отдельная СУБД со своим хранилищем, другие — как чистый слой вычислений поверх внешних систем, третьи — как инструмент для тяжелых пакетных заданий (batch jobs), а не для быстрых ответов аналитику.
Эта разница в архитектуре определяет почти все остальное: особенности масштабирования, поведение при нехватке памяти и, в конечном счете, применимость для работы с Iceberg-таблицами в S3.
Выбор SQL-движка для платформы данных — непростая задача. Повезет, если сработает стратегия «а возьму‑ка самый популярный». На практике выбор определяется:
- паттерном нагрузки — много коротких запросов ad-hoc или редкие, но тяжелые ETL-джобы;
- зрелостью экосистемы вокруг движка — насколько активно он развивается, легко ли найти специалистов, есть ли готовые коннекторы к нужным источникам данных;
- топологией сети — например, может потребоваться агрегировать данные прямо на узлах хранения;
- архитектурными ограничениями системы.
Рассмотрим основные альтернативы.
| Движок | Архитектура | Где и чем хорош | Где и почему не подходит |
|---|---|---|---|
| Trino | • Распределенная MPP‑архитектура• Чисто вычислительный слой без хранилища • Коннекторы к внешним источникам | • Интерактивные разовые (ad‑hoc) SQL‑запросы • Федеративные запросы к нескольким источникам • Разделение хранения и вычислений • Легкие и средние ETL‑процессы | • Не подходит для тяжелых ETL-процессов с долговременным состоянием • Сброс данных (spill) на диск — это скорее «костыль», а не штатный режим |
| Spark | • Задачи на базе JVM • Фокус на пакетную обработку (batch-first) • Выполнение в оперативной памяти • Отказоустойчивость на уровне RDD | • Тяжелые ETL-процессы • Обучение ML‑моделей • Устойчивость к сбоям в продолжительных задачах | • Там, где нужно быстро стартовать задачи • Избыточен для коротких интерактивных запросов |
| Presto | • Форк общего с Trino предка (разошлись в 2020 году) | • Используется там, где уже внедрен (в крупных корпорациях, таких как AWS Athena v2) | • Медленнее развивается: меньше активных контрибьюторов и релизов, чем у Trino |
| ClickHouse | • Собственная MPP-СУБД со своим форматом хранения MergeTree | • Быстрее на «своих» таблицах • Отличный 99‑й пертенциль на точечных запросах и агрегациях • Чтение таблиц Iceberg и Delta (нативный коннектор, REST‑каталоги, облачный DataLakeCatalog) | • Не просто движок поверх открытых форматов — данные нужно загружать и дублировать • Запись в Iceberg (экспериментальная функция с ограничениями) |
| StarRocks | • MPP‑архитектура • Разделение: FE (метаданные, планирование) + BE/CN (вычисления, хранение) • Встроенное колоночное хранилище • Полностью векторизованный движок с CBO (Cost-Based Optimizer) • Форк Apache Doris (2020) | • Сверхбыстрый отклик даже для тяжелых JOIN и агрегаций высокой кардинальности без необходимости денормализации • Прямые запросы к Iceberg, Delta Lake и Hudi без предварительного копирования данных • Режим shared‑data (compute‑storage separation, с версии 3.0) | • Моложе ClickHouse и Trino и уступает им по экосистеме и комьюнити • Для ad‑hoc федеративных запросов к разнородным внешним БД уступает Trino • Сложнее в эксплуатации, чем встраиваемые решения |
| Doris | • MPP‑архитектура • FE с помощью оптимизатора Nereids планирует запрос в виде направленного ациклического графа (DAG) • BE выполняют фрагменты параллельно • Поддерживает разделение вычислений и хранения | • Сложные типы данных (Array, Map, JSON, Variant) с авто‑определением схемы • Федеративные запросы к Hive, Iceberg, Hudi, MySQL, PostgreSQL • Полнотекстовый поиск через инвертированный индекс | • Более консервативная архитектура, движется в сторону «чистого lakehouse» медленнее, чем StarRocks • Не распространен за пределами Азии |
| Dremio | • Свои движок и каталог поверх Iceberg • Кеш на базе Data Reflection • Разделение вычислений и хранения | • Встроенный Data Reflection для ускорения запросов • Хорош как каталог поверх lakehouse | • Интересные функции только в корпоративной (enterprise) версии • Открытая версия развивается сообществом медленно |
| Impala | • MPP SQL-движок на C++/Java • Работает поверх Hadoop-кластера • Без промежуточного слоя MapReduce/Spark | • Интерактивные запросы поверх Hadoop‑хранилищ | • Проект менее, активен чем остальные кандидаты • Сильно завязан на Hadoop-экосистему, плохо вписывается в концепцию lakehouse |
| DuckDB | • Встраиваемый • Одноузловой • Работает внутри процесса (in-process) | • Идеален для локальной аналитики, прототипирования и одного пользователя | • Не рассчитан на распределенные запросы • Не рассчитан на многопользовательский конкурентный доступ |
Глядя на эту таблицу, не сложно подметить закономерность. Одни движки (Trino, Presto, Dremio) сознательно отказались от собственного хранилища и функционируют исключительно за счет коннекторов к внешним данным — в этом их главное преимущество и одновременно ограничение.
Другие (ClickHouse) выбрали противоположный путь — тесно связали движок со своим форматом хранения ради скорости, но заплатили отказом от «нативной» работы с открытыми форматами, такими как Iceberg.
DuckDB играет в другой лиге: он не поддерживает распределенные вычисления, зато почти не создает накладных расходов при запуске. Он отлично подходит для небольших экспериментов, когда и данных относительно немного, и пользователей всего несколько.
Отдельного упоминания заслуживают Trino и Presto, и дело не только в архитектуре, но и в истории. Оба проекта выросли из одного кода Facebook Presto: создатели движка ушли из Facebook и сделали форк PrestoSQL в 2018-м, а в декабре 2020 года переименовали его в Trino.
На первый взгляд может показаться, что выбор между ними — вопрос вкуса. На самом деле это не совсем так: активность разработки — тоже значимый критерий выбора движка, а не второстепенная деталь. Репозиторий Trino на GitHub заметно активнее по числу коммитов и релизов, чем Presto. По этой причине сообщество в основном мигрировало на Trino, а Presto выбирают все реже в новых проектах.
Что говорят бенчмарки
Количественное сравнение SQL-движков — область, где почти невозможно найти полностью независимый результат. Подавляющее большинство публичных бенчмарков TPC-DS публикуются самими вендорами. Конфигурация, размер данных и набор запросов почти всегда подбираются так, чтобы подчеркнуть преимущества собственного продукта.
Давайте рассмотрим актуальные исследования — например, разбор в CedrusData (российского вендора lakehouse-платформы на основе Trino). Важная оговорка: авторы сами честно предупреждают, что не претендуют на объективность. В финале их кандидат побеждает — совпадение?
Однако методология тестирования здесь устроена иначе, чем в обычном маркетинговом бенчмарке. Вместо сухих процентов превосходства — подробный разбор причин, почему один движок отработал быстрее другого. Анализ идет на уровне работы оптимизатора, планировщика и подсистемы чтения из S3. Именно такая прозрачность делает результаты полезными, независимо от заинтересованности авторов публикации.
Ниже — краткие итоги теста. Условия: TPC-DS, scale factor 10 000/~3,5 TB в Parquet, один запрос Q1 с пятью JOIN и коррелированным подзапросом, один узел на 32 vCPU/256 GiB).
- Presto отработал катастрофически медленно (203 секунды) по одной конкретной причине — в нем до сих пор не реализованы распределенные runtime-фильтры, из‑за чего движок читает из S3 в 4−5 раз больше данных, чем нужно, и не может отфильтровать их до выполнения JOIN.
- Trino справился значительно лучше Presto (47 секунд), но отстал от конкурентов из-за двух узких мест: лишней передачи данных через loopback-интерфейс внутри сервера и упущенного применения одного runtime-фильтра из‑за особенности оптимизатора. По оценке исследователей, устранение этих двух проблем сократило бы время выполнения примерно до 30−35 секунд.
- StarRocks и Doris в базовой конфигурации показывают обманчиво хорошие цифры за счет материализации CTE в оперативной памяти. Однако именно эта настройка, включенная по умолчанию, превращается в проблему под конкурентной нагрузкой. В тесте с четырьмя одновременными запросами StarRocks со стандартными параметрами не смог выполнить ни одного запроса из четырех. Doris уполовинил успешные запросы ужепри восьми одновременных сессиях. То есть движок, который выигрывает в изолированном одиночном запросе, может быть куда менее пригоден для реальной многопользовательской аналитики.
- Impala показал худший результат среди работоспособных движков. Устаревший AST-подобный оптимизатор не умеет строить эффективные планы для сложных конструкций с подзапросами.
На что ориентироваться
Главный практический вывод исследования — не в определении того, «какой движок быстрее». Изолированный запуск одного запроса и конкурентная многопользовательская нагрузка — принципиально разные сценарии. Движок, побеждающий в одном случае, может проигрывать во втором из-за особенностей изначальных настроек.
Для платформы, где планируется одновременное обслуживание множества аналитических ad-hoc запросов, стабильность поведения под конкурентной нагрузкой оказывается значительно важнее высоких показателей в одиночных тестах.
Оценить примерный масштаб разницы между движками помогают и более общеизвестные тесты.
- Относительно независимый, хоть и не без собственного интереса проект Hive on MR3 сравнивает Trino, Spark и Hive на MR3 с набором данных TPC‑DS 10 TB. Результаты показывают, что Trino быстрее Spark примерно в 3,5 раза по суммарному времени выполнения: 4 441 секунд против 15 678. Это ожидаемо, учитывая разницу в архитектуре: массивно‑параллельная обработка против пакетной. При этом тестировщики отдельно отмечают, что Trino вернул некорректный результат на одном из запросов — деталь, которую в отчетах производителя, пожалуй, не встретишь.
- Независимое тестирование Trino, Spark и DuckDB под управлением dbt на объеме TPC-DS около 100 GB показывает, что при небольшом объеме данных на одной машине, DuckDB обгоняет Trino в 75% случаев. Однако этот успех не переносится на распределенные сценарии с десятками терабайт, где у DuckDB просто нет архитектуры для горизонтального масштабирования.
- ClickBench — открытый и воспроизводимый бенчмарк, где ребята ClickHouse показывает p99-латентность точечных запросов на уровне миллисекунд. Важно отметить, что это бенчмарк MergeTree, собственного хранилища ClickHouse, а не движка поверх таблиц вроде Iceberg. Для корректного сопоставления с Trino данные пришлось бы дублировать полностью.
Ориентироваться на показатели сторонних исследований следует с осторожностью. Результаты сильно зависят от конфигурации железа, количества узлов в кластере, степени распараллеливания, набора запросов и версии движка. Кроме того, у большинства авторов есть коммерческий интерес в конкретном исходе.
Если метрики производительности критичны для принятия решения, то лучше воспроизвести тесты на своей инфраструктуре с реальным профилем нагрузки и обязательно с многопользовательским режимом, а не только изолированными запросами.
Таким образом, оптимальным кандидатом для нашей платформы остается Trino.
Что такое Trino и зачем он в платформах данных
Trino (PrestoSQL, до 2020 года) — распределенный SQL-движок, предназначенный для интерактивных запросов к данным во внешних источниках. «Распределенный» — ключевое свойство. Запрос не выполняется на одной машине целиком, а разбивается на стадии (stages), которые параллельно обрабатываются на нескольких worker-узлах. Процесс напоминает крупный заказ на складе, который собирают сразу несколько сотрудников.
У Trino нет собственного хранилища: он не записывает ни сами данные, ни метаданные таблиц, и этим он принципиально отличается от «обычных» СУБД вроде PostgreSQL или ClickHouse, где движок и хранилище — одно целое. Его задача — принять SQL-запрос, спланировать распределенное выполнение, обратиться к источнику через коннектор и вернуть результат.
Аналитики могут делать ad-hoc запросы так же просто, как если бы данные лежали в обычной реляционной БД. Разница в том, что этот движок сам ничего не хранит: он просто подключается, читает и завершает сессию, тогда как все данные остаются на своем месте в S3.
Между «принять запрос» и «вернуть результат» происходит все самое интересное: парсинг SQL в абстрактное синтаксическое дерево, построение логического плана, его оптимизация (выбор порядка JOIN, push-down фильтров ближе к источнику данных) и, наконец, физическое распределение задач по worker-узлам.
Например, с Iceberg работа строится так:
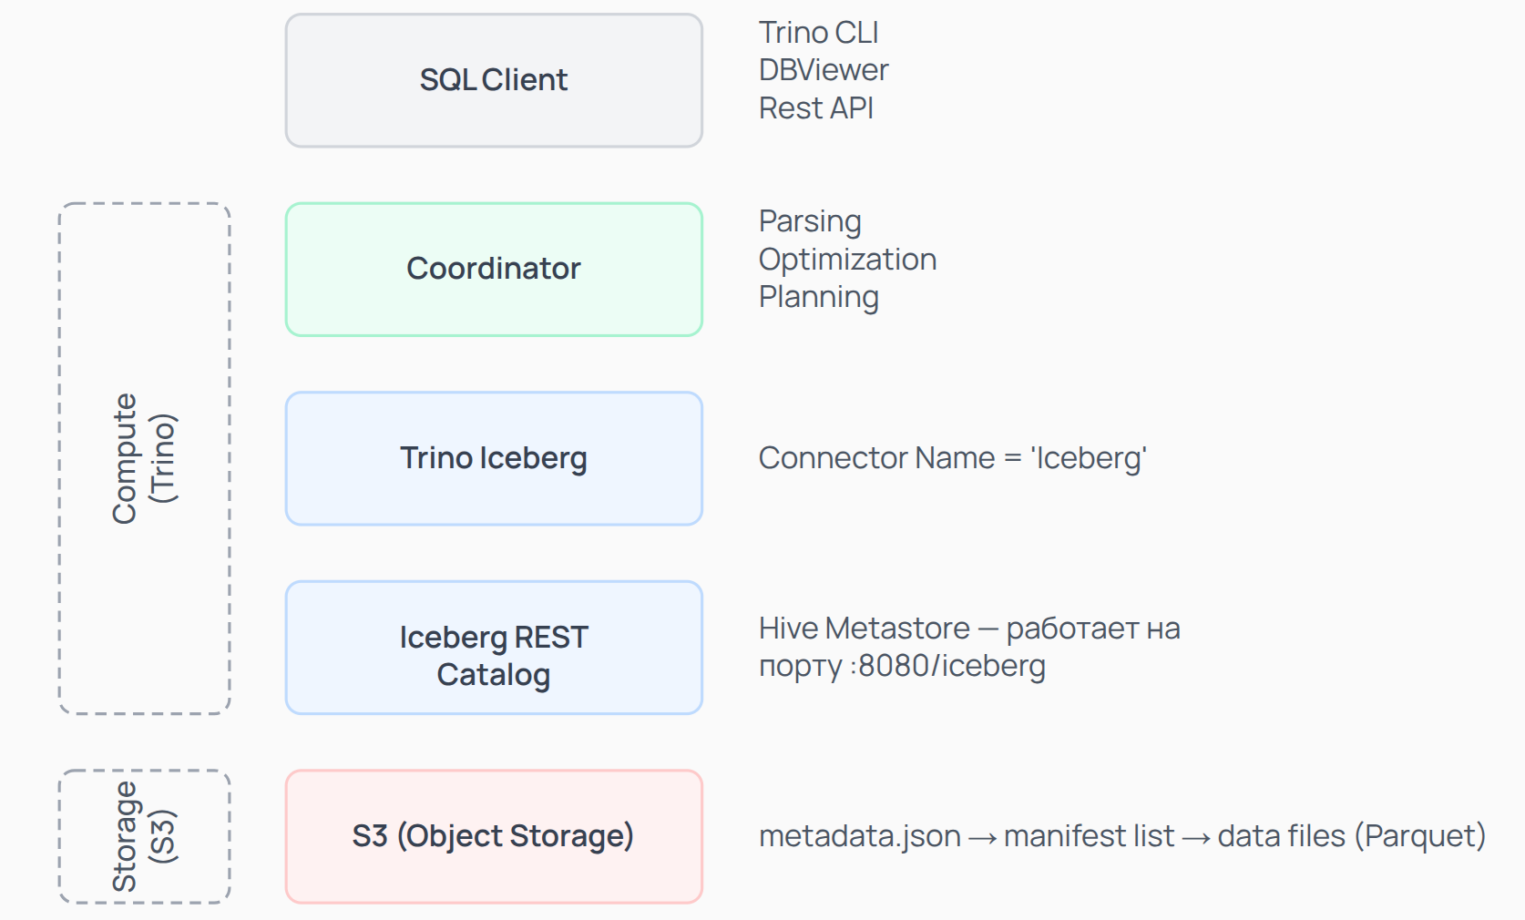
Ключевой момент: Trino и S3 разделены не только логически, но и физически. Trino не «владеет» данными — он обращается к объектному хранилищу только за теми файлами, которые указаны в метаданных Iceberg, и строго в момент выполнения конкретного запроса. Ничего не реплицируется заранее и не хранится «на всякий случай».
Такое архитектурное решение — не случайность, а отражение изначальной задумки по созданию чистого compute‑слоя. Именно оно позволяет масштабировать вычислительные мощности и объемы хранения независимо друг от друга. При нехватке CPU и RAM — добавятся worker-узлы Trino, при росте объема информации — увеличится квота в S3. Эти процессы никак не связаны друг с другом и не требуют миграции данных.
Другое следствие подобной архитектуры — Trino не привязан к конкретному источнику данных. Поскольку у движка нет собственного формата хранения, для него в принципе не важно, откуда брать данные. Главное — наличие подходящего коннектора, который умеет взаимодействовать с нужным источником.
Благодаря такой отстраненности Trino может параллельно подключать десятки разнородных источников: PostgreSQL, Kafka, MySQL, Hive, Delta Lake…. На практике это открывает путь к federated-запросам: можно одним SQL-запросом объединить таблицы из Iceberg и оперативного PostgreSQL. Trino сам разберется, как забрать данные из обоих источников и свести их воедино — в других архитектурах это стало бы отдельной ETL-задачей.
Еще раз: Trino — лишь вычислительный слой, который не хранит данные, а обращается к ним через коннекторы. Для работы с Iceberg ему нужен каталог метаданных, например который мы подняли во второй части.
Коннектор Iceberg в Trino
В экосистеме Trino интеграция с источниками данных настраивается с помощью файлов конфигурации. Один файл etc/catalog/<name>.properties соответствует одному «Trino-каталогу».
Подключение
Для подключения к нашему Iceberg REST Catalog из второй части создадим файл iceberg.properties:
      connector.name=iceberg
iceberg.catalog.type=rest
iceberg.rest-catalog.uri=http://hive-metastore:8080/iceberg
iceberg.rest-catalog.warehouse=s3://warehouse/
fs.native-s3.enabled=true
s3.endpoint=https://s3.ru-7.storage.selcloud.ru
s3.path-style-access=true
s3.access-key=${ENV:AWS_ACCESS_KEY_ID}
s3.secret-key=${ENV:AWS_SECRET_ACCESS_KEY}
Обратите внимание: параметр iceberg.rest-catalog.warehouse указан со схемой s3://, а не s3a://, которая относится к Hadoop S3A filesystem (ее использует HMS в docker-compose ниже). Trino же при включенном fs.native-s3.enabled=true работает через собственный нативный S3-клиент и ожидает схему s3://. Смешивание схем в конфигурации Trino — частая причина ошибок чтения путей.
Разберем параметры подробнее.
connector.name=iceberg— тип коннектора. Trino загружает плагинiceberg, умеющий работать с метаданными Iceberg.iceberg.catalog.type=rest— тип каталога метаданных. Мы подключаемся к REST Catalog (HMS 4.2.0 с REST-интерфейсом), а не к HMS через Thrift. Это корректный способ: HMS 4.2.0 реализует Iceberg REST Catalog Spec, и Trino обращается к нему по HTTP.iceberg.rest-catalog.uri=http://hive-metastore:8080/iceberg— URL нашего REST Catalog. Обратите внимание:hive-metastore— это имя хоста в docker-сети, а не localhost. Поскольку Trino и HMS работают в разных контейнерах, то localhost указывал бы на сам Trino.iceberg.rest-catalog.warehouse— корневой путь в S3, который Trino передает REST Catalog при инициализации. Он должен совпадать сwarehouse, настроенным в HMS (с поправкой на схему, как описано во врезке выше).fs.native-s3.enabled=true— используем встроенный S3-клиент Trino (не Hadoop). Это рекомендуемый способ для работы с S3-совместимыми хранилищами.- Параметры
s3.endpoint,s3.path-style-access,s3.access-key,s3.secret-key— отвечают за конфигурацию доступа. Флагpath-style-access=trueобязателен для Selectel Object Storage и большинства S3-совместимых хранилищ (кроме AWS, где используется не path-style, а virtual-hosted style, соответственноpath-style-access=false).
Важно: учетные данные передаются через переменные окружения! Они не должны попадать в конфигурационные файлы.
Коллизия терминов
Одно из частых затруднений при настройке Trino с Iceberg — одинаковые термины для разных сущностей.
Trino‑catalog — конфигурационная сущность внутри движка. Это файл etc/catalog/iceberg.properties, который описывает параметры подключения к конкретному источнику данных: какой коннектор использовать, где каталог метаданных, как добраться до файлов. Когда выполняется запрос, скажем, SELECT * FROM iceberg.analytics.events, слово iceberg — имя Trino-каталога, совпадающее с названием файла properties (без расширения).
Iceberg‑catalog (в нашем случае, REST Catalog на порту 8080) — отдельный компонент платформы, который хранит метаданные Iceberg-таблиц. Он знает расположение текущего metadata.json, актуальную схему, список существующих снапшотов. Мы о нем подробно рассказывали во второй части.
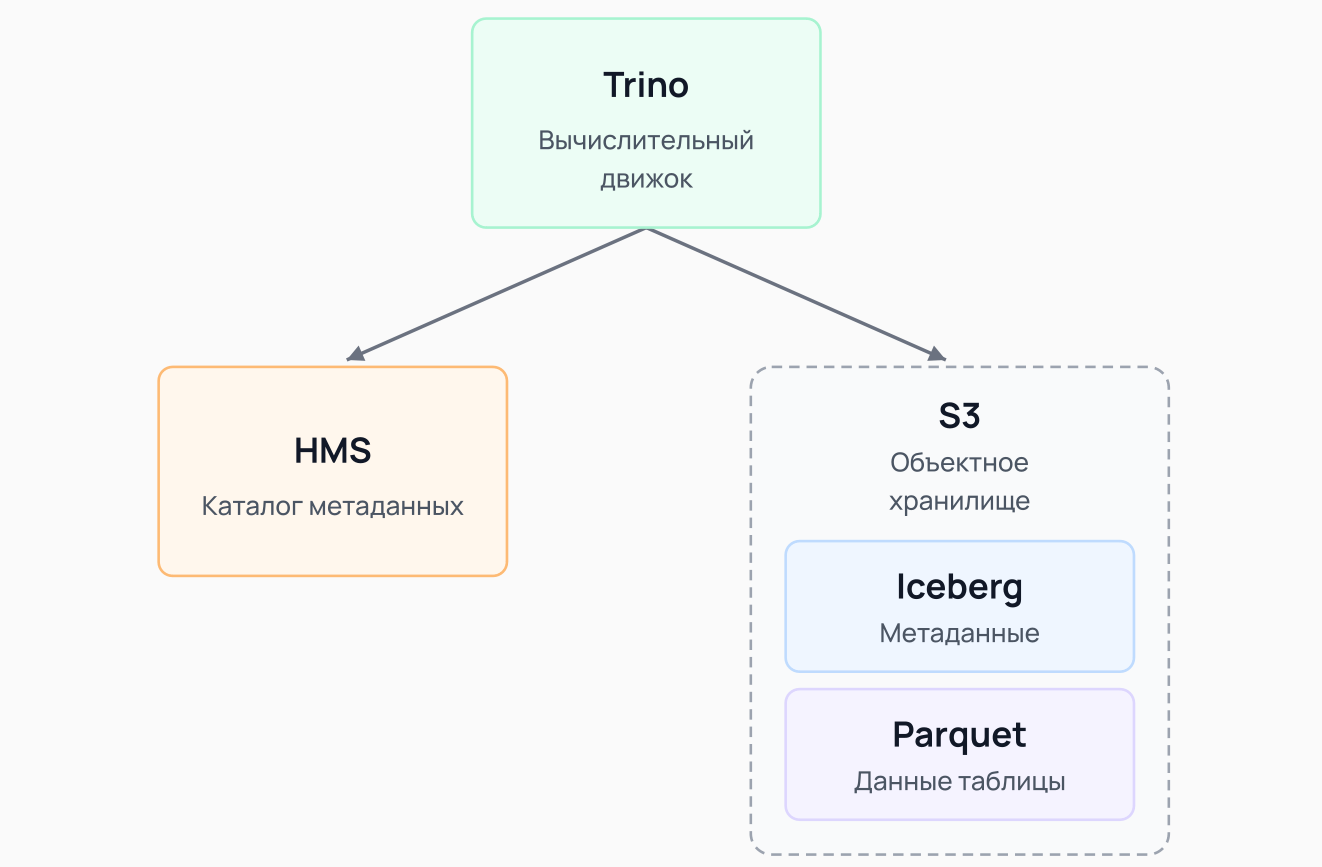
Связь между ними проста: внутренний Trino‑catalog (использующий коннектор iceberg) обращается через REST API к внешнему Iceberg‑каталогу как к своему источнику правды о таблицах. Один не заменяет другой — они работают на разных уровнях абстракции:
Поднимаем Trino
Запуск
Добавим Trino в наш docker-compose.yml, который уже содержит настройки для PostgreSQL и HMS.
      # Стенд платформы данных: PostgreSQL + HMS 4.2.0 (Thrift + REST Catalog) + Trino
# Порты на хосте: 5432 — postgres, 9083 — Thrift HMS, 8180 — REST Catalog (/iceberg), 8090 — Trino
# (в тексте статьи REST Catalog проброшен на 8080, Trino — на 8081; здесь порты 8180/8090
# Перед запуском: открыть.env и заполнить ключи S3
services:
 postgres:
   image: postgres:16
   environment:
     POSTGRES_USER: metastore
     POSTGRES_PASSWORD: metastore123
     POSTGRES_DB: metastore
   ports:
    - "5432:5432"
   volumes:
    - pgdata:/var/lib/postgresql/data
   healthcheck:
     test: ["CMD-SHELL", "pg_isready -U metastore"]
     interval: 5s
     timeout: 5s
     retries: 5
   networks:
    - metastore-net
 hive-metastore:
   build:
     context: .
     dockerfile: Dockerfile.metastore
   depends_on:
     postgres:
       condition: service_healthy
   environment:
     SERVICE_NAME: metastore
     DB_DRIVER: postgres
     # Ключи S3 передаются JVM-опциями и перекрывают то, что нет в hive-site.xml.
     # Сами значения приходят из .env — в файлах репозитория их нет.
     SERVICE_OPTS: >-
      -Dfs.s3a.access.key=${AWS_ACCESS_KEY_ID}
      -Dfs.s3a.secret.key=${AWS_SECRET_ACCESS_KEY}
   ports:
    - "9083:9083"   # Thrift API HMS
    - "8180:8080"   # Iceberg REST Catalog (префикс /iceberg)
   volumes:
    - ./conf/hive-site.xml:/opt/hive/conf/metastore-site.xml:ro
   restart: unless-stopped
   networks:
    - metastore-net
 trino:
   image: trinodb/trino:483
   depends_on:
    - hive-metastore
   environment:
     AWS_ACCESS_KEY_ID: ${AWS_ACCESS_KEY_ID}
     AWS_SECRET_ACCESS_KEY: ${AWS_SECRET_ACCESS_KEY}
   ports:
    - "8090:8080"   # внутри контейнера — стандартный 8080
   volumes:
    - ./trino/etc:/etc/trino
   networks:
    - metastore-net
volumes:
 pgdata:
networks:
 metastore-net:
   ipam:
     config:
      - subnet: "10.99.0.0/16"
Порт Trino внутри контейнера — стандартный 8080, но во избежание конфликта с REST Catalog хост‑порт проброшен как 8090.
Чтобы Trino подключился к источнику данных, файл с его настройками (каталог) должен находиться в системной директории etc/catalog/:
Файл конфигурации каталога /etc/catalog/Iceberg.properties:
      connector.name=iceberg
iceberg.catalog.type=hive_metastore
hive.metastore.uri=thrift://hive-metastore:9083
iceberg.register-table-procedure.enabled=true
fs.s3.enabled=true
s3.endpoint=https://s3.ru-3.storage.selcloud.ru
s3.region=ru-3
s3.path-style-access=true
s3.aws-access-key=${ENV:AWS_ACCESS_KEY_ID}
s3.aws-secret-key=${ENV:AWS_SECRET_ACCESS_KEY}
Для проверки работоспособности кластера добавим конфигурацию встроенного тестового коннектора TPC-DS. Для этого создадим файл TCPDS.properties:
connector.name=tpcds
Конфигурационный файл etc/config.properties получается следующим:
      coordinator=true
node-scheduler.include-coordinator=true
http-server.http.port=8080
query.max-memory=1GB
query.max-memory-per-node=512MB
discovery.uri=http://localhost:8080
# Spill to disk (это потребуется дальше)
spill-enabled=true
spiller-spill-path=/tmp/trino-spill
# Resource groups
resource-groups.configuration-manager=file
resource-groups.config-file=/etc/trino/resource-groups.json
Для простоты локального развертывания роли координатора и рабочих узлов (воркеров) совмещены в одном контейнере — node-scheduler.include-coordinator=true. В реальных проектах кластер Trino строго разделен:
- координатор — принимает SQL-запросы, строит план выполнения и раздает задачи, но не занимается непосредственно вычислениями, чтобы не зависнуть;
- рабочие узлы (воркеры) — получают задания от координатора, читают данные из S3 и обрабатывают их.
Другие параметры:
query.max-memory=1GB— лимит оперативной памяти на запрос для всего кластера, что для нашего упрощенного примера вполне достаточно, а в реальных задачах значение зависит от объема данных и числа параллельных запросов;discovery.uri— адрес, по которому workers находят координатора (в single-node — это localhost).
Конфигурация коннектора (см. раздел «Коннектор Iceberg в Trino» выше) помещается в ./etc/catalog/iceberg.properties на хосте‑машине и монтируется внутрь контейнера.
Для передачи учетных данных необходимо создать файл .env (он должен был появиться при реализации примеров из второй части):
      AWS_ACCESS_KEY_ID=your_access_key
AWS_SECRET_ACCESS_KEY=your_secret_key
Запуск среды выполняется командой:
docker-compose up -d
Проверяем, что Trino стартовал:
docker-compose logs trino --tail 20
Успешный запуск подтверждается строками SERVER STARTED или Announcement of catalog iceberg. Вторая говорит и об успешном подключении к REST Catalog и нашему источнику данных.
Trino стартует значительно быстрее HMS: обычно за 10−15 секунд. Если за полминуты нужные строки в логах не появились, нужно перепроверить конфигурацию.
Типичные ошибки при запуске
Вручную развернуть подобную инфраструктуру локально — задача, требующая внимания к деталям. В отличие от управляемых облачных PaaS-решений, где базовая конфигурация уже настроена и работает, здесь все связи между компонентами приходится настраивать самостоятельно.
Ниже — таблица типичных проблем и способов их решения на случай, если Trino не стартует с первого раза.
| Проблема | Почему происходит | Решение |
|---|---|---|
Connection refused к hive-metastore:8080 в логах Trino | HMS еще не стартовал или указан localhost вместо имени сервиса | Проверить, что статус HMS запущен (docker-compose ps), использовать имя сервиса Docker-сети |
Access denied или HTTP 403 при чтении из S3 | Неверные или отсутствующие S3-ключи | Проверить .env-файл и проброс переменных в контейнер Trino |
Catalog iceberg is not registered | Файл iceberg.properties не смонтирован или содержит ошибку синтаксиса | Проверьте путь и содержимое внутри контейнера:docker exec -it <trino-container> cat /etc/trino/catalog/iceberg.properties |
iceberg.rest-catalog.uri указывает на localhost:8080 | Внутри контейнера localhost ведет на сам Trino, а не HMS | Использовать http://hive-metastore:8080/iceberg. Здесь hive-metastore — внутреннее имя сервиса из файла docker-compose.yml |
REST Catalog возвращает 404 на /iceberg/v1/config | Несовпадение пути: HMS 4.2.0 использует префикс /iceberg | Проверить hive.metastore.iceberg.catalog.servlet.path в hive-site.xml — должно быть iceberg |
Подавляющее большинство проблем при первом запуске Trino с Iceberg — в неверном указании URL для REST Catalog (localhost вместо имени контейнера), ошибках в ключах S3 и опечатками в конфигурационных файлах. Их стоит проверять первыми.
Первые запросы
Итак, Trino запущен и подключен к Iceberg REST Catalog. Убедимся, что он видит таблицу analytics.events, которую мы создали во второй части.
Trino CLI
Trino поставляется со встроенным консольным клиентом. Подключаемся:
docker exec -it <trino-container> trino --catalog iceberg --schema analytics
Проверяем, что Trino видит каталог и схему:
SHOW CATALOGS;
Ожидаемый вывод:
Catalog
---------
 iceberg
 system
 tpcds
(3 rows)
SHOW SCHEMAS IN iceberg;
      Schema
-------------------
 analytics
 information_schema
(2 rows)
SHOW TABLES IN iceberg.analytics;
 Table
-------
 events
(1 row)
Читаем данные:
SELECT * FROM iceberg.analytics.events;
Видим:
 event_id | event_type |        timestamp
----------+------------+-------------------------
        1 | click      | 2026-07-24 10:00:00.000
        2 | view       | 2026-07-24 10:01:00.000
(2 rows)
Данные реально читаются из S3: Trino обращается к HMS, получает указатель на metadata.json, спускается по иерархии метаданных (metadata.json → манифесты → Parquet) и считывает файлы из объектного хранилища Selectel (s3.ru-3.storage.selcloud.ru, бакет ice-iceberg, путь connector.name=iceberg). Ничего не кэшировано локально — при повторном запросе Trino снова идет тем же путем.
Обратите внимание, если бы каталога метаданных не было или он был бы удален, восстанавливать метаданные о таблицах пришлось бы следующим образом:
      CALL iceberg.system.register_table(
 schema_name => 'analytics',
 table_name => 'events',
 table_location => 's3a://ice-iceberg/warehouse/analytics.db/events');
Важно: процедура требует явного включения параметра iceberg.register-table-procedure.enabled в iceberg.properties:
iceberg.register-table-procedure.enabled=true
По умолчанию она отключена из соображений безопасности — иначе любой пользователь мог бы «подключить» чужие данные.
REST API Trino
Для автоматизации запросов — это могут быть CI/CD‑пайплайны, скрипты, оркестрация и тому подобное — удобнее использовать REST API на стандартном эндпоинте /v1/statement HTTP-интерфейса:
      curl -s -X POST \
    http://localhost:8090/v1/statement \
    -H 'X-Trino-User: analyst' \
    -d 'SELECT * FROM iceberg.analytics.events'
Результат сервер возвращает в формате JSON:
      {
   "id": "20260906_160318_00018_8zdbp",
   "infoUri": "http://localhost:8090/ui#/queries/20260906_160318_00018_8zdbp",
   "nextUri": "http://localhost:8090/v1/statement/queued/20260906_160318_00018_8zdbp/y3ab421a5b5ce3d19d75af0fa61bfc21db6941c41/1",
   "stats": {
       "state": "QUEUED",
       "queued": true,
       "scheduled": false,
       "totalSplits": 0,
       "processedRows": 0,
       "processedBytes": 0,
       "elapsedTimeMillis": 0
   },
   "warnings": []
}
Для продолжительных запросов ответ содержит поле nextUri для получения следующей порции данных. Полный цикл выглядит так:
POST-запрос → извлечение nextUri → серия GET‑запросов
Процесс продолжается до получения полного массива данных, пока в ответе не появится stats.state=FINISHED.
Пример финального GET‑ответа с результатами выполнения запроса lSELECT event_type, count(*) AS cnt ... GROUP BY 1:
      {
   "columns": [
       {"name": "event_type", "type": "varchar"},
       {"name": "cnt", "type": "bigint"}
   ],
   "data": [["click", 1], ["view", 1]],
   "stats": {
       "state": "FINISHED",
       "elapsedTimeMillis": 262,
       "processedRows": 2,
       "processedBytes": 1755
   }
}
Пример простой автоматизации на Python:
      import requests
TRINO_URL = "http://localhost:8090"
headers = {"X-Trino-User": "analyst"}
response = requests.post(
   f"{TRINO_URL}/v1/statement",
   headers=headers,
   data="SELECT count(*) FROM iceberg.analytics.events",
)
result = response.json()
rows = result.get("data") or []
while "nextUri" in result:
   response = requests.get(result["nextUri"], headers=headers)
   result = response.json()
   rows += result.get("data") or []
print("state:", result["stats"]["state"])
print("columns:",  for c in result["columns"]])
print("data:", rows)
Ожидаемый вывод:
state: FINISHED
columns: ['_col0']
data: [[2]]
HTTP‑запрос проходит ту же цепочку, что и запрос из CLI: координатор Trino → коннектор Iceberg → каталог метаданных (HMS) → объектное хранилище S3. По сути, CLI — просто тонкая обертка над этим же REST API.
Особенности работы с Iceberg через Trino
При работе с Iceberg через Trino важно четко понимать границы ответственности каждого инструмента. Смешивание функционала табличного формата Iceberg и вычислительного движка Trino — распространенная ошибка, которая приводит к неверным ожиданиям при миграции на другие системы.
Возможности формата Iceberg на практике
Эти функции доступны в любом совместимом с Iceberg движке — Trino, Spark, Flink, DuckDB, — так как заложены в саму спецификацию табличного формата, а не в реализацию конкретного движка.
О возможностях Iceberg мы рассказывали в первой части.
Time Travel
Time Travel — возможность чтения данных в том виде, в котором они находились в прошлом: по определенному моменту или идентификатору снапшота. Это незаменимый инструмент для воспроизводимости ML-моделей, аудита изменившихся отчетов и быстрого восстановления данных после ошибочных операций.
      INSERT INTO iceberg.analytics.events
VALUES (3, 'click', TIMESTAMP '2026-09-06 16:10:00 UTC');
Вывод:
INSERT: 1 rowПосмотреть историю изменений можно через системную таблицу метаданных Iceberg. Для этого к имени основной таблицы добавляется суффикс "$snapshots", а вся конструкция заключается в двойные кавычки:
      SELECT snapshot_id, committed_at, operation, summary
FROM iceberg.analytics."events$snapshots";
Примерный результат:
     snapshot_id     |        committed_at         | operation |  summary
---------------------+-----------------------------+-----------+-----------
6335359114163657760 | 2026-08-02 16:00:58.099 UTC | append    | added-records=2, total-data-files=1 ...
4749155415311655236 | 2026-09-06 16:03:48.300 UTC | append    | added-records=1, total-records=3, engine-name=trino, trino_query_id=20260906_160347_00024_8zdbp ...
(2 rows)
Обратите внимание на колонку summary второго снапшота. Iceberg честно фиксирует, кто и каким движком вносил изменения (engine-name=trino, trino_query_id, trino_user) — это готовый журнал для аудита. Используя полученный snapshot-id, можно выполнить запрос к этому конкретному историческому срезу данных.
      SELECT * FROM iceberg.analytics.events
FOR VERSION AS OF 6335359114163657760;
Ожидаемый вывод:
 event_id | event_type |           timestamp
----------+------------+--------------------------------
       1 | click      | 2026-07-24 10:00:00.000000 UTC
       2 | view       | 2026-07-24 10:01:00.000000 UTC
(2 rows)
Выше — состояние таблицы именно до операции INSERT: в ней всего две строки, хотя текущая версия содержит уже три.
Рассмотрим чтение по конкретному моменту времени.
Момент до вставки (15 августа 2026) — Trino выбирает ближайший снапшот, существовавший на тот момент:
      SELECT * FROM iceberg.analytics.events
FOR TIMESTAMP AS OF TIMESTAMP '2026-08-15 00:00:00';
Пример вывода:
event_id | event_type |           timestamp
----------+------------+--------------------------------
       1 | click      | 2026-07-24 10:00:00.000000 UTC
       2 | view       | 2026-07-24 10:01:00.000000 UTC
(2 rows)
Момент после вставки — уже три строки:
      SELECT * FROM iceberg.analytics.events
FOR TIMESTAMP AS OF TIMESTAMP '2026-09-06 16:05:00';
Результат:
event_id | event_type |           timestamp
---------+------------+--------------------------------
       1 | click      | 2026-07-24 10:00:00.000000 UTC
       2 | view       | 2026-07-24 10:01:00.000000 UTC
       3 | click      | 2026-09-06 16:10:00.000000 UTC
(3 rows)
Что важно — никакого «отката времени» не происходит, физика не нарушается: time travel — это исключительно чтение. Физически данные старого снапшота продолжают лежать в S3 — старый Parquet-файл никто не перезаписывал. Переключение между версиями — это выбор нужного указателя в метаданных. Trino лишь формирует запрос к конкретному snapshot-id или timestamp, а Iceberg отдает соответствующую версию данных.
Schema Evolution
Schema Evolution — добавление, удаление и переименование колонок без пересоздания таблицы и без перезаписи файлов:
      ALTER TABLE iceberg.analytics.events ADD COLUMN severity VARCHAR;
ADD COLUMN;
Благодаря механизму Schema Evolution изменение схемы происходит только на уровне метаданных — добавленная колонка мгновенно становится доступна для запросов. Поскольку исторические файлы не перезаписываются, для старых строк значение новой колонки автоматически выводится как NULL:
event_id | event_type |           timestamp            | severity
---------+------------+--------------------------------+----------
       3 | click      | 2026-09-06 16:10:00.000000 UTC | NULL
       1 | click      | 2026-07-24 10:00:00.000000 UTC | NULL
       2 | view       | 2026-07-24 10:01:00.000000 UTC | NULL
(3 rows)
Заполним значение и переименуем колонку:
      UPDATE iceberg.analytics.events SET severity = 'warn' WHERE event_id = 3;
ALTER TABLE iceberg.analytics.events RENAME COLUMN event_type TO action;
Результат:
UPDATE: 1 row
RENAME COLUMN
Текущее состояние таблицы:
event_id | action |           timestamp            | severity
---------+--------+--------------------------------+----------
       1 | click  | 2026-07-24 10:00:00.000000 UTC | NULL
       2 | view   | 2026-07-24 10:01:00.000000 UTC | NULL
       3 | click  | 2026-09-06 16:10:00.000000 UTC | warn
(3 rows)
А теперь — ключевая проверка. Читаем старый снапшот — тот самый, с идентификатором 6335359114163657760 — и получаем состояние таблицы до вставки третьей строки:
SELECT * FROM iceberg.analytics.events FOR VERSION AS OF 6335359114163657760;
Видим:
event_id | event_type |           timestamp
---------+------------+--------------------------------
       1 | click      | 2026-07-24 10:00:00.000000 UTC
       2 | view       | 2026-07-24 10:01:00.000000 UTC
(2 rows)
Старая схема и старые данные. Iceberg ищет колонку по внутреннему числовому field-id, а не по строковому имени (подробнее — в первой части) Переименование — это только запись в метаданных.
Partition Evolution
Чтобы посмотреть текущую схему и настройки партиционирования таблицы, выполним команду SHOW CREATE TABLE:
SHOW CREATE TABLE iceberg.analytics.events;
В ответ Trino вернет DDL-код, описывающий текущее состояние таблицы. Обратите внимание на параметр partitioning в самом конце вывода:
      CREATE TABLE iceberg.analytics.events (
  event_id bigint,
  action varchar,
  timestamp timestamp(6) with time zone,
  severity varchar
)
WITH (
  compression_codec = 'ZSTD',
  format = 'PARQUET',
  format_version = 2,
  location = 's3a://ice-iceberg/warehouse/analytics.db/events',
  partitioning = ARRAY['day(timestamp)']
)
Изменим гранулярность партиционирования со дня на час:
ALTER TABLE iceberg.analytics.events SET PROPERTIES partitioning = ARRAY['hour(timestamp)'];
Вставляем новую строку и смотрим, что произошло с файлами:
      INSERT INTO iceberg.analytics.events VALUES (4, 'view', TIMESTAMP '2026-09-06 16:20:00 UTC', 'info');
SELECT record_count, file_path FROM iceberg.analytics."events$files";
Получаем:
record_count | file_path
--------------+------------------------------------------------------------------------------------------------------
           1 | .../events/data/timestamp_hour=2026-09-06-16/20260906_160626_00043_8zdbp-....parquet
           1 | .../events/data/timestamp_day=2026-09-06/20260906_160603_00035_8zdbp-....parquet
           1 | .../events/data/timestamp_day=2026-09-06/20260906_160347_00024_8zdbp-....parquet
           2 | .../events/data/timestamp_day=2026-07-24/00000-0-6732f683-....parquet
           1 | .../events/data/timestamp_day=2026-09-06/20260906_160603_00035_8zdbp-....parquet
Новый файл был сохранен в каталог timestamp_hour=2026-09-06-16 по новым правилам, а все старые остались в timestamp_day=... — ничего не переписывалось. При этом запрос по‑прежнему видит все данные:
event_id | action |           timestamp            | severity
---------+--------+--------------------------------+----------
       1 | click  | 2026-07-24 10:00:00.000000 UTC | NULL
       2 | view   | 2026-07-24 10:01:00.000000 UTC | NULL
       3 | click  | 2026-09-06 16:10:00.000000 UTC | warn
       4 | view   | 2026-09-06 16:20:00.000000 UTC | info
(4 rows)
Iceberg умеет сводить разные схемы партиционирования в одной таблице: в метаданных хранится список всех версий спецификации, и каждый файл знает, по какой из них он написан.
Возможности движка Trino
Эти возможности не зависят от табличного формата и работают с любым коннектором — будь то Iceberg, Hive, PostgreSQL или любой другой.
Spill to disk
Spill to disk — механизм Trino для защиты от нехватки оперативной памяти. Если ресурсоемкая операция — например, объединение или сортировка — превышает выделенный лимит, Trino временно сбрасывает промежуточные данные на локальный диск, а не падает с ошибкой OutOfMemoryError.
Функция включается в config.properties параметрами:
      spill-enabled=true
spiller-spill-path=/tmp/trino-spill
Spill — это не ускорение, а защита. Запрос со spill обрабатывается медленнее, чем в памяти, но гарантированно доводится до конца. Причем, это не специфика Iceberg: spill одинаково работает с любым коннектором.
Для демонстрации этого механизма понадобится таблица побольше двух строк в events. В качестве примера возьмем store_sales размером 2,88 млн строк, сгенерированную с помощью TPC-DS, который мы добавили выше.
Теперь выполним ресурсоемкую операцию по почти уникальной комбинации ключей на store_sales. Такая hash-агрегация построит ~2,88 млн групп и потребует сотни мегабайт памяти. Лимит памяти запроса занизим сессионной переменной до 150 МБ, чтобы создать искусственный дефицит:
      SET SESSION query_max_memory_per_node = '150MB';
SET SESSION spill_enabled = false;   -- сначала выключим spill
SELECT count(*), max(s1), max(s2), max(s3), max(s4)
FROM (
 SELECT ss_item_sk, ss_ticket_number, ss_customer_sk, ss_promo_sk, ss_sold_date_sk,
        sum(ss_net_paid) AS s1, sum(ss_list_price) AS s2,
        sum(ss_coupon_amt) AS s3, sum(ss_wholesale_cost) AS s4
 FROM iceberg.tpcds.store_sales
 GROUP BY 1, 2, 3, 4, 5
);
Без spill запрос падает через примерно четыре секунды:
Query ... failed: Query exceeded per-node memory limit of 150MB
[Allocated: 143.95MB, Delta: 6.69MB, Top Consumers:
{HashAggregationOperator=85.53MB, TableScanOperator-ConnectorPageSource=37MB, LazyOutputBuffer=19.71MB}]
Тот же запрос со включенным spill:
      SET SESSION query_max_memory_per_node = '150MB';   -- spill включён по умолчанию (spill-enabled=true)
SELECT count(*), max(s1), max(s2), max(s3), max(s4)
FROM ( ... тот же подзапрос ... );
Получаем:
 _col0  |  _col1   |  _col2  |  _col3   |  _col4
--------+----------+---------+----------+---------
2880404 | 19562.40 | 200.00 | 17588.25 | 100.00
(1 row)
Запрос доведен до конца при том же лимите 150 МБ. Как видно из EXPLAIN ANALYZE, агрегации потребовалось ~310 МБ состояния — разницу движок сбросил на диск:
CPU: 5.41s (66.27%), ..., Output: 2880404 rows (310.41MB), Spilled: 160.85MBDynamic Filtering
Dynamic Filtering — оптимизация, при которой Trino на этапе выполнения (а не планирования) фильтрует данные на стороне источника, используя значения из другой части запроса.
Для демонстрации этой механики подготовим две таблицы на основе данных из коннектора TPC-DS масштаба SF1, что соответствует примерно 1 ГБ итоговых данных:
store_sales— 2,88 млн строк,item— 18 тыс строк.
      CREATE TABLE iceberg.tpcds.store_sales AS SELECT * FROM tpcds.sf1.store_sales;  -- 2880404 rows
CREATE TABLE iceberg.tpcds.item        AS SELECT * FROM tpcds.sf1.item;         -- 18000 rows
Запрос «продажи только книг» — типичный паттерн fact JOIN dim с фильтром по измерению:
      SELECT count(*)
FROM iceberg.tpcds.store_sales s
JOIN iceberg.tpcds.item i ON s.ss_item_sk = i.i_item_sk
WHERE i.i_category = 'Books';
Результат:
_col0
-------
282258
(1 row)
Смотрим план:
      EXPLAIN SELECT count(*) FROM iceberg.tpcds.store_sales s
JOIN iceberg.tpcds.item i ON s.ss_item_sk = i.i_item_sk
WHERE i.i_category = 'Books';
Видим:
Fragment 0 [SINGLE]
  ...
Fragment 1 [SOURCE]
  ...
   │   dynamicFilterAssignments = {i_item_sk -> #df_344}
   ├─ ScanFilter[table = iceberg:tpcds.store_sales$data@5035875533631986199,
   │             dynamicFilters = {ss_item_sk = #df_344}]
  ...
Fragment 2 [SOURCE]
   ScanFilterProject[table = iceberg:tpcds:item$data@5993927450393973049,
                    filterPredicate = (i_category = varchar 'Books')]
В плане запроса видно суть механизма: сканирование таблицы фактов store_sales содержит метку dynamicFilters = {ss_item_sk = #df_344}, а источник фильтра — dynamicFilterAssignments = {i_item_sk -> #df_344} на стороне измерения. Конкретные значения фильтра становятся известны только после чтения item — то есть на этапе выполнения, а не планирования.
Сравним производительность: с включенным и выключенным Dynamic Filtering
Проведем замер времени выполнения с помощью EXPLAIN ANALYZE в двух режимах (динамическую фильтрацию можно отключить сессионной переменной):
      EXPLAIN ANALYZE SELECT count(*) FROM iceberg.tpcds.store_sales s
JOIN iceberg.tpcds.item i ON s.ss_item_sk = i.i_item_sk
WHERE i.i_category = 'Books';
SET SESSION enable_dynamic_filtering = false;
EXPLAIN ANALYZE SELECT count(*) ... -- тот же запрос
Ключевые строки вывода:
| Метрика | DF включен | DF выключен |
Scan store_sales: Filtered | 90,20% | Фильтра нет |
| InnerJoin: Left (probe) Input | 282 258 строк | 2 880 404 строки |
Scan store_sales: Physical input | 4,98 MB | 4,94 MB |
Что произошло: в режиме по умолчанию операция сканирования таблицы store_sales дождалась набора ключей i_item_sk из таблицы измерений и отбросил 90% строк еще до выполнения JOIN. В результате в операцию объединения пришло 282 тыс. строк вместо 2,88 млн — разница почти десятикратная. Без использования Dynamic Filtering в JOIN отправляются все 2,88 млн строк и там фильтруются.
Вот пример реального вывода EXPLAIN ANALYZE по фрагменту с JOIN:
Fragment 1 [SINGLE]
   CPU: 690.57ms, Scheduled: 797.52ms, Blocked 6.10s (Input: 4.67s, ...),
   Input: 2882137 rows (24.74MB); per task: avg.: 2882137.00 std.dev.: 0.00, Output: 1 row (9B)
Здесь Blocked — это как раз время, в течение которого оператор сканирования таблицы ожидал построения динамического фильтра. Регулируется оно параметром iceberg.dynamic-filtering.wait-timeout (по умолчанию 1s), а также общим таймаутом ожидания в JOIN.
Adaptive Query Execution
Adaptive Query Execution — способность перестраивать план запроса «на лету», если действительная статистика времени выполнения расходится с предварительной оценкой планировщика. Это встроенная возможность движка, не зависящая от коннектора.
Подытожим
Функционал Time Travel, Schema Evolution и Partition Evolution — это заслуга формата Iceberg, а не Trino. Если подключить Spark к тем же Iceberg-таблицам, все эти возможности сохранятся и будут работать точно так же.
Напротив, Spill, Dynamic Filtering и Adaptive Query Execution — вклад движка Trino, который позволяет им работать независимо от коннектора «под капотом».
Важно не путать возможности формата и возможности движка: Iceberg обеспечивает транзакционность, версионирование и эволюцию схемы, а Trino — распределенное выполнение, оптимизацию запросов и защиту от нехватки памяти.
Особенности эксплуатации
При переходе от экспериментов к коммерческому использованию возникает ряд вопросов, которые выходят за рамки Docker Compose, но остаются критичны для реальной платформы данных.
Масштабирование
В примерах координатор работает одновременно и как worker:
node-scheduler.include-coordinator=true
В больших проектах координатор и рабочие узлы разворачиваются на разных машинах. Один отвечает исключительно за разбор запросов и планирование, а другие — за выполнение ресурсоемких задач, причем чем продолжительнее предполагается время для их обработки, тем многочисленнее будут воркеры. Рекомендуемый минимум: для одного координатора — 2 CPU, 8 GB RAM.
Мониторинг
Trino экспортирует метрики через JMX и REST API. Для мониторинга наиболее важны из них следующие:
query.execution-time— общее время от старта запроса до выдачи результата;query.cpu-time— суммарное процессорное время, потраченное всеми воркерами на запрос показывает, насколько запрос «тяжелый» для кластера;query.memory-reserved— пиковый объем оперативной памяти, зарезервированный под выполнение запроса;QueuedQueriesиRunningQueries— количество запросов в ожидании и в процессе выполнения, что помогает вовремя заметить перегрузку координатора.
Trino также поддерживает интеграцию с OpenTelemetry и Prometheus через OpenMetrics.
Отказоустойчивость
В стандартном режиме Trino падение рабочего узла приводит к ошибке всего запроса. У Trino есть режим Fault-tolerant Execution: промежуточные результаты сохраняются, и при падении одного воркера запрос продолжается на другом. Расход памяти и диска увеличивается, но повышается надежность.
Управление файлами
При интенсивном изменении данных в таблицах Iceberg через Trino — те же INSERT, MERGE, DELETE — накапливаются мелкие файлы и устаревшие снапшоты, которые нужно по мере необходимости удалять или оптимизировать для сохранения высокой производительности и экономии места в S3.
Всю тяжелую вычислительную работу по обслуживанию берет на себя Trino. Он предоставляет специальные SQL-процедуры. Ниже — несколько примеров.
      SELECT count(*) AS files, sum(record_count) AS records,
      round(sum(file_size_in_bytes)/1024.0, 1) AS size_kb
FROM iceberg.analytics."events$files";
Результат:
files | records | size_kb
------+---------+---------
    7 |       9 | 5.5
(7 rows... файлов)
Семь Parquet-файлов суммарным размером 5,5 КБ иллюстрируют ключевую особенности работы хранилища — каждый INSERT или UPDATE создает новый файл. На малых объемах это незаметно, но при потоке из сотен заданий в сутки такая таблица деградирует из‑за появления тысяч мелких файлов. Существенно замедляется чтение и увеличиваются расходы на хранилище за счет роста количества GET‑запросов.
Можно объединять мелкие файлы данных в более крупные (по умолчанию до 100 MB) для ускорения чтения:
ALTER TABLE iceberg.analytics.events EXECUTE optimize;
Вывод:
       metric_name         | metric_value
---------------------------+--------------
rewritten_data_files_count |            6
removed_delete_files_count |            1
added_data_files_count     |            2
(3 rows)
Проверим итоговое количество файлов и записей через системную таблицу $files:
SELECT count(*) AS files, sum(record_count) AS records FROM iceberg.analytics."events$files";
Примерный ответ:
files | records
------+---------
    2 |       7
(2 rows... файла)
Семь файлов (включая один delete-файл, созданный при выполнении UPDATE) перезаписаны в два оптимизированных — по одному на партицию. Дубликаты схлопнуты, актуальный размер таблицы — 7 записей (было 9 с учетом переписанных версий строки).
Ниже — еще пара примеров работы с данными.
Удаление снапшотов старше семи дней для экономии места:
ALTER TABLE iceberg.analytics.events EXECUTE expire_snapshots(retention_threshold => '7d');
Очистка хранилища от «осиротевших» файлов, на которые не ссылается ни один снапшот:
ALTER TABLE iceberg.analytics.events EXECUTE remove_orphan_files(retention_threshold => '7d')
Безопасность и multi-tenancy
Демонстрационные примеры из предыдущих разделов работают без аутентификации и авторизации. Любой пользователь с сетевым доступом к порту Trino может выполнять произвольные SQL-запросы. Для локальной разработки это еще допустимо, для настоящей эксплуатации — нет.
Аутентификация
Trino поддерживает несколько провайдеров аутентификации. Для платформы с небольшим числом пользователей разумно начать с локального файла паролей — простейшего механизма, где учетные записи хранятся на узле координатора.
Настройки config.properties включают HTTPS и тип проверки:
      http-server.authentication.type=PASSWORD
http-server.https.enabled=true
http-server.https.port=8443
http-server.https.keystore.path=/etc/trino/keystore.jks
В файле паролей /etc/password-authenticator.properties указывается путь к базе паролей в формате BCrypt, которая генерируется утилитой htpasswd или аналогичной:
      password-authenticator.name=file
file.password-file=/etc/trino/password.db
База паролей содержит строки формата user:password-hash, где password-hash — BCrypt-хеш.
При росте числа пользователей имеет смысл перейти на LDAP — Trino поддерживает его «из коробки». В таком случае отпадет необходимость ручного управления файлом паролей и появится возможность использовать корпоративную учетную запись.
Авторизация
Trino поддерживает авторизацию на двух уровнях: системном (catalog/schema/table) и на уровне каталога (column/row).
Базовый механизм File-based access control позволяет описать правила доступа в JSON-файле. Например аналитику можно предоставить права только на чтение схемы analytics:
      {
  "catalogs": [
    {
      "user": "analyst",
      "catalog": "iceberg",
      "allow": ["analytics"]
    }
  ],
  "schemas": [
    {
      "user": "analyst",
      "schema": "iceberg.analytics",
      "owner": false,
      "allow": [
        { "table": "events", "privileges": ["SELECT"] }
      ]
    }
  ]
}
Правила доступа к таблицам можно настроить через встроенный JSON-файл, который подключается в файле config.properties:
access-control.config-files=/etc/trino/access-control.json
Для более сложных сценариев — динамические правила, аудит, интеграция с корпоративными политиками — Trino поддерживает внешние движки авторизации, такие как Open Policy Agent (OPA) и Apache Ranger.
Помимо глобальных правил, права можно жестко ограничить на уровне самого подключения, за что это отвечает параметр iceberg.security в файле конфигурации каталога — например, iceberg.properties. Поддерживаемые значения:
ALLOW_ALL(по умолчанию) — проверки отключены, разрешены любые действия;SYSTEM— проверка прав делегируется системному контролю доступа Trino (тому же встроенному JSON-файлу или внешнему OPA);READ_ONLY— режим «только чтение» (операцииCREATE,INSERT,DELETEзапрещены);FILE— доступ регулируется отдельным JSON-файлом, созданным специально для этого каталога.
Пример:
iceberg.security=READ_ONLY
Resource Groups
Resource Groups — механизм Trino для ограничения ресурсов по группам пользователей. Он решает классическую проблему: аналитик запустил тяжелый незапланированный запрос, который забрал всю память кластера, и вынудил всех остальных ждать.
Конфигурация JSON-файле распределяет лимиты:
      {
  "rootGroups": [
    {
      "name": "global",
      "softMemoryLimit": "80%",
      "hardConcurrencyLimit": 100,
      "maxQueued": 1000,
      "schedulingPolicy": "weighted",
      "subGroups": [
        {
          "name": "analytics",
          "softMemoryLimit": "30%",
          "hardConcurrencyLimit": 10,
          "maxQueued": 50,
          "schedulingWeight": 1
        },
        {
          "name": "etl",
          "softMemoryLimit": "50%",
          "hardConcurrencyLimit": 5,
          "maxQueued": 100,
          "schedulingWeight": 3
        }
      ]
    }
  ],
  "selectors": [
    {
      "source": ".*etl.*",
      "group": "global.etl"
    },
    {
      "group": "global.analytics"
    }
  ]
}
В этом примере ETL-пайплайны (определяются по source) получают больше памяти, но ограничены в конкурентности — не более пяти одновременных запросов. Аналитики получают бо́льшую квоту — до десяти одновременных запросов, но с меньшим лимитом памяти. Запросы, превышающие пределы, ставятся в очередь, а не падают.
Подытожим
В реальные проекты должна обязательно быть внедрена многоуровневая безопасность: HTTPS, аутентификация, авторизация с помощью OPA или простых JSON‑файлов, resource groups для ограничения ресурсов по командам. Без этого один пользователь с тяжелым запросом способен парализовать весь кластер.
Безопасность в Trino настраивается послойно:
- аутентификация — кто обращается,
- авторизация — что разрешено,
- resource groups — сколько ресурсов можно потребить.
В демо все открыто, но для продакшена пропуск любого из этих слоев — риск.
Заключение
Теперь мы подключили к нашей минимальной платформе и вычислительный движок. Вот что получилось суммарно.
- Iceberg — табличный формат с поддержкой ACID‑транзакций, Time Travel, Schema Evolution (в первой части);
- REST Catalog (HMS 4.2.0) — каталог метаданных, обеспечивающий атомарное переключение указателя и единый источник правды для всех движков (во второй части);
- Trino — распределенный движок, который по SQL‑запросам через REST Catalog читает Iceberg-таблицы;
- Несколько слоев безопасности — описаны минимальные настройки для продакшен‑окружения: аутентификация, авторизация, квотирование нагрузки.
Теперь аналитики могут подключаться к платформе через любой совместимый клиент — Trino CLI, DBeaver, JDBC‑драйвер — и выполнять запрос к данным в S3, не поднимая Spark и не загружая данные в отдельную СУБД.
Чтобы подключить к платформе бизнес-пользователей, нужен BI-слой поверх Trino — это станет темой следующей части.
Напишите в комментариях, какие BI-инструменты используете и о чем было бы интересно узнать подробнее.