Введение
Локальный домашний инференс обычно ассоциируется с полноразмерным ПК с несколькими видеокартами (иногда объединенными SLI/NVLink) и мощным блоком питания. При этом основными ограничениями такого решения зачастую являются объем оперативной и видеопамяти, а также их пропускная способность.
На волне популярности LLM-моделей для локального инференса востребованными оказались Mac mini™. Тому есть несколько причин. За счет унифицированной памяти для загрузки модели доступен весь объем за исключением занятого системой. Пропускная способность этой памяти на порядок больше таковой в сравнении с DDR5. Также набор инструментов для локального инференса развился до состояния, пригодного для быстрого разворачивания.
С такими вводными Mac mini™ с памятью 24 или 48 ГБ — интересная альтернатива инференсу на десктопе. Совмещая локальную LLM-модель среднего размера и OpenClaw, пользователи организуют различные сценарии, используя персонального ИИ-агента. В этой статье попробуем запустить несколько моделей локально и проверим, оправдан ли хайп вокруг Mac mini™.
Насколько прожорлив OpenClaw
OpenClaw не является моделью. Это ИИ-агент или ИИ-ассистент, как его иногда позиционируют, работающий поверх LLM. Также у него есть интеграции с популярными сервисами: Discord, Google Chat, iMessage®, Matrix и другими. В документации OpenClaw называют self-hosted шлюзом для связи приложений и мессенджеров с возможностью подключения ИИ-агентов для программирования.
Минимальные системные требования и правда малы: одно ядро процессора, 512 МБ ОЗУ, 1 ГБ диска и сеть 1 Мбит/c. Такая инсталляция заявлена как персональный бот на бюджетном облачном сервере / Raspberry Pi® для тестов или разработки.
Production- и heavy-сценарии более требовательны к ресурсам: 2/4+ ядра процессора, 8/16 ГБ ОЗУ, 20/50+ ГБ диска и сеть 10/25+ Мбит/с. В такой инсталляции связка OpenClaw + LLM может работать в рамках команды или компании, обеспечивать работу мультиагентных воркфлоу и пайплайнов автоматизации. Все перечисленные системные требования не учитывают локальное размещение модели.
Наш тестовый Mac mini™ оснащен процессором M4 Pro, 48 ГБ ОЗУ и 2 ТБ диска. «На бумаге» железо позволяет развернуть OpenClaw в самом требовательном к ресурсам сценарии. Из-за архитектуры Mac mini™ с унифицированной памятью (UMA) пул доступной оперативной памяти един для процессора и графики. Это накладывает ограничения на выбор модели: чем больше модель, тем меньше памяти останется для OpenClaw и системы.
Установка OpenClaw и настройка локального инференса
Для тестов нужно локально развернуть LLM-модель с OpenAI-совместимым API. Одно из готовых решений — LM Studio. Оно позволяет скачивать и локально запускать модели, а также обеспечивает эндпоинты с OpenAI-совместимым API.
Кроме LM Studio существуют другие решения со схожим функционалом: llama.cpp, Ollama (на базе llama.cpp), vLLM и другие. LM Studio выигрывает для задачи «скачать модель и получить API» за счет GUI, встроенного каталога моделей и минимальной настройки. Аналоги «из коробки» требуют больше действий для такого же результата.
Установка LM Studio поддерживается в двух форматах: GUI и headless. Для тестовых целей подойдет GUI-вариант, который позволяет быстро настраивать параметры загрузки моделей и генерации и скачивать модели. Headless подойдет для развертывания на удаленной машине, например, на выделенном сервере, для использования разными клиентами. Сам процесс установки прост — скачать DMG-файл и установить.
Далее для локального запуска нужно загрузить модели и настроить доступ к ней по API.
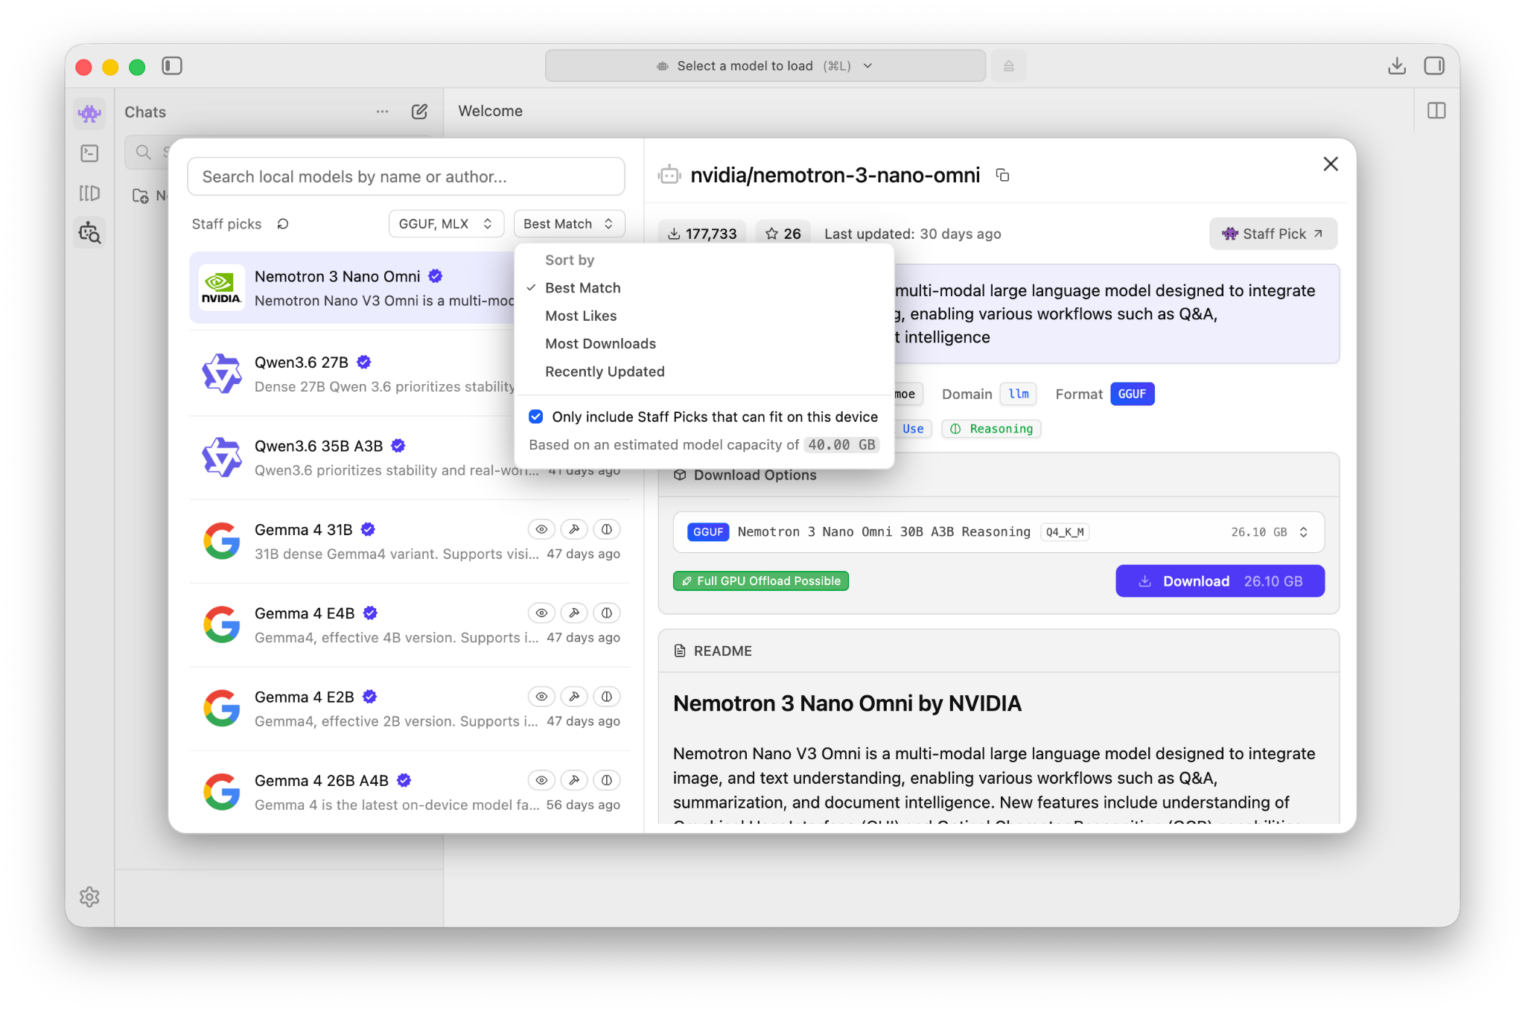
Загрузить модель можно в меню Model Search. По умолчанию модели отсортированы в порядке Best Match, начиная с самых больших и подходящих для устройства. Для тестового Mac mini™ LM Studio оценивает доступный для модели объем памяти в 40 ГБ.
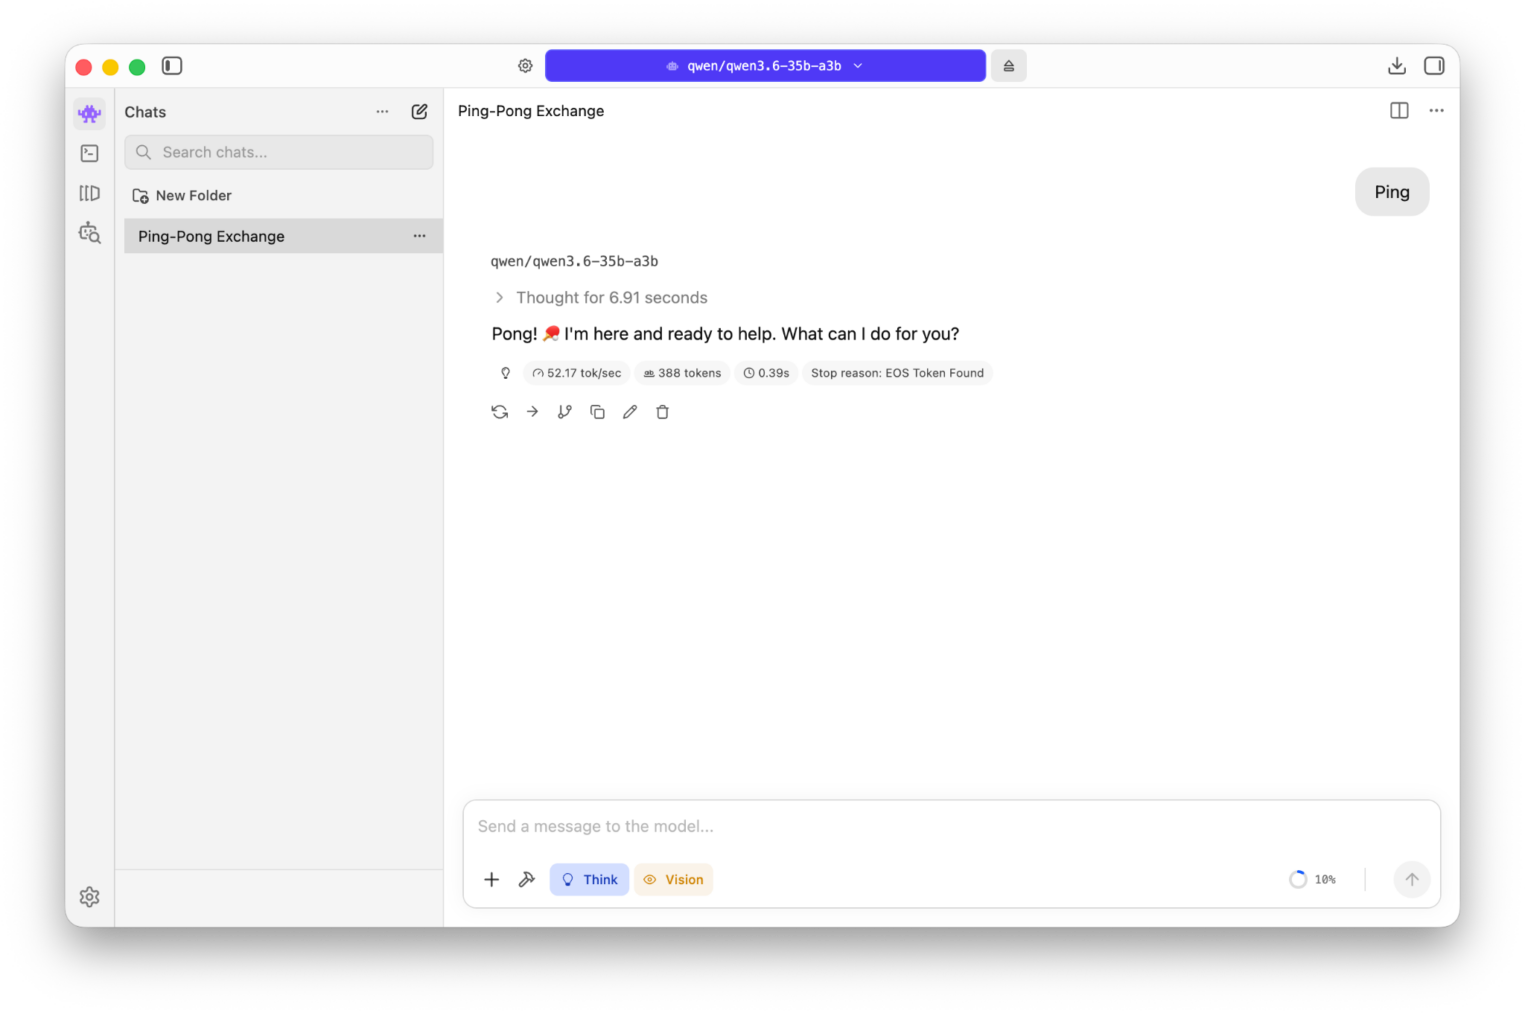
После скачивания весов модели и загрузки в память можно пингануть модель и получить ответ.
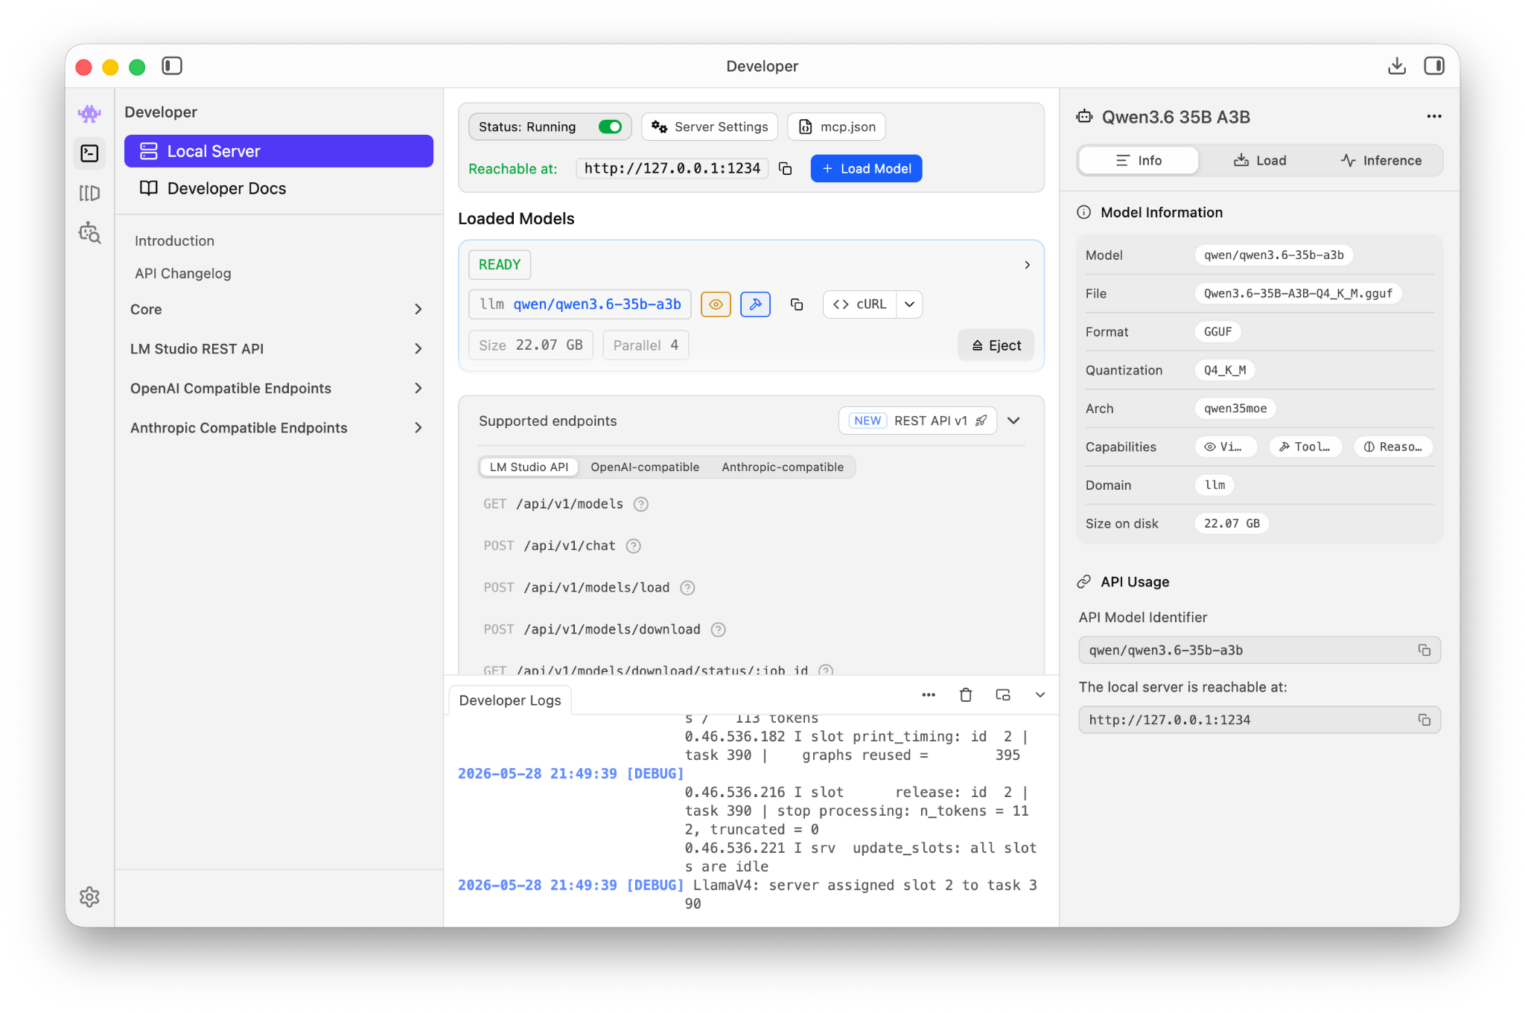
Для запуска локального сервера нужно переключиться в меню Developer и переключить статус. Тут же видны логи.
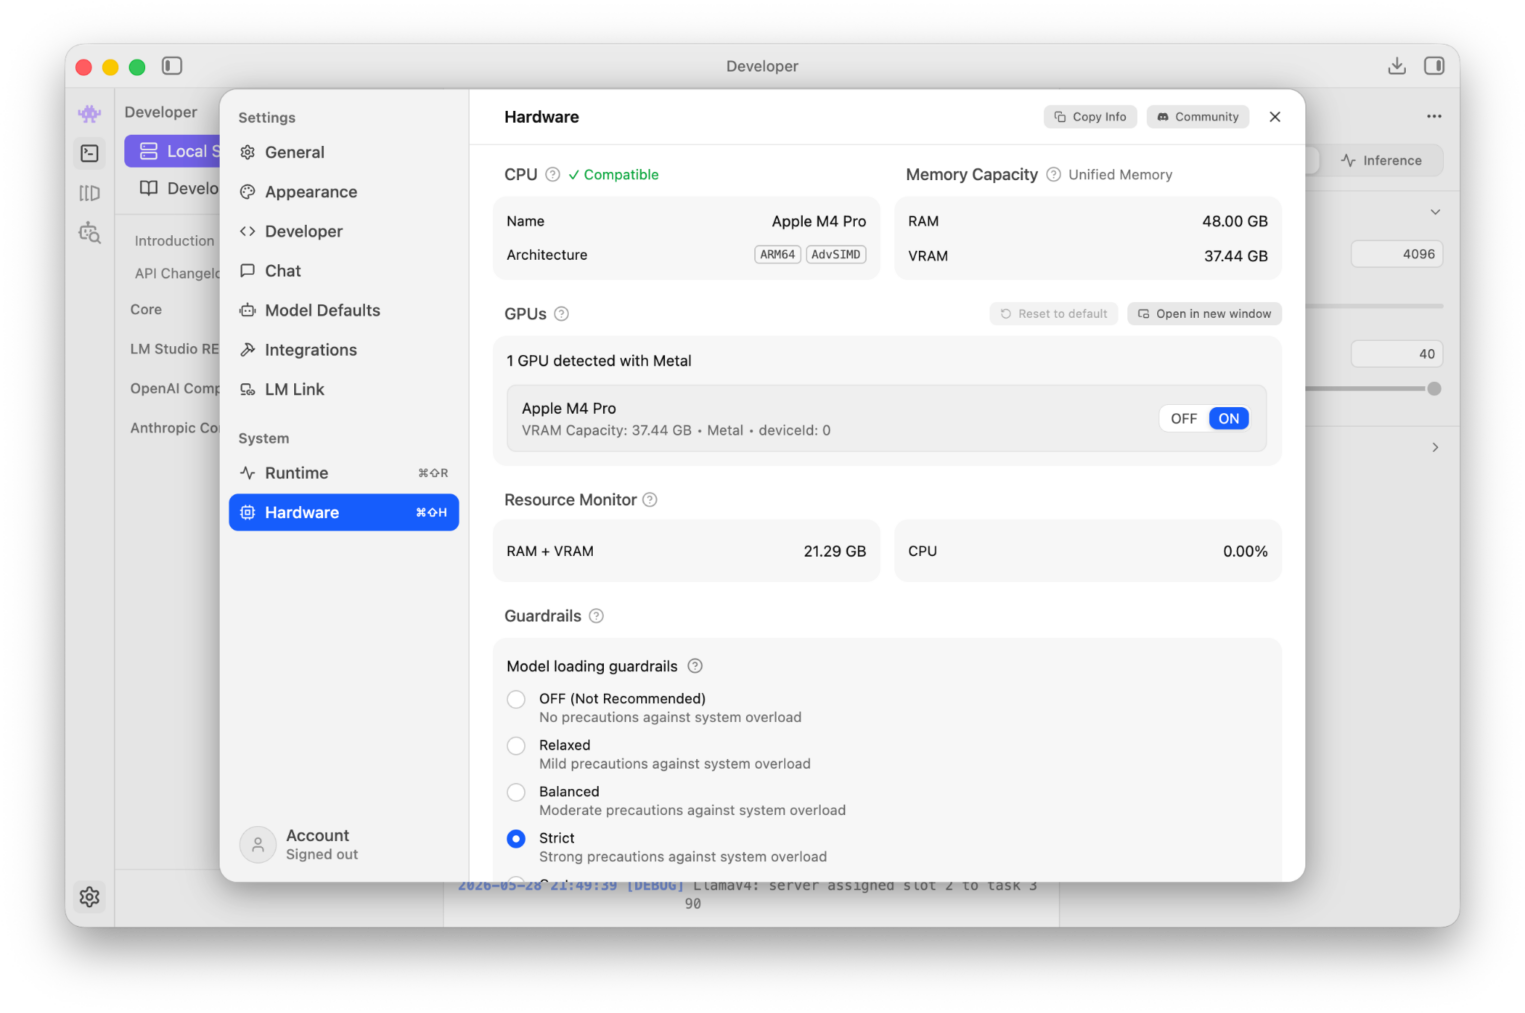
После загрузки модели LM Studio оценивает объем занятой памяти в 21 ГБ.
После настройки локальной модели перейдем к установке OpenClaw.
Обратите внимание, что для лаконичности инструкции используются команды, которые скачивают неизвестный скрипт и выполняют его с правами суперпользователя. Это небезопасно, так как скрипт может быть изменен и содержать вредоносный контент.
Такой подход допустим для краткосрочных проектов на чистом сервере, однако в продуктовой среде рекомендуется устанавливать ПО вручную из доверенных источников.
curl -fsSL https://openclaw.ai/install.sh
Скрипт ставит необходимые пакеты и запускает мастер настройки. Проходим его с минимальными настройками. После завершения откроем дашборд и отправим запрос на проверку состояния системы — Check system health.
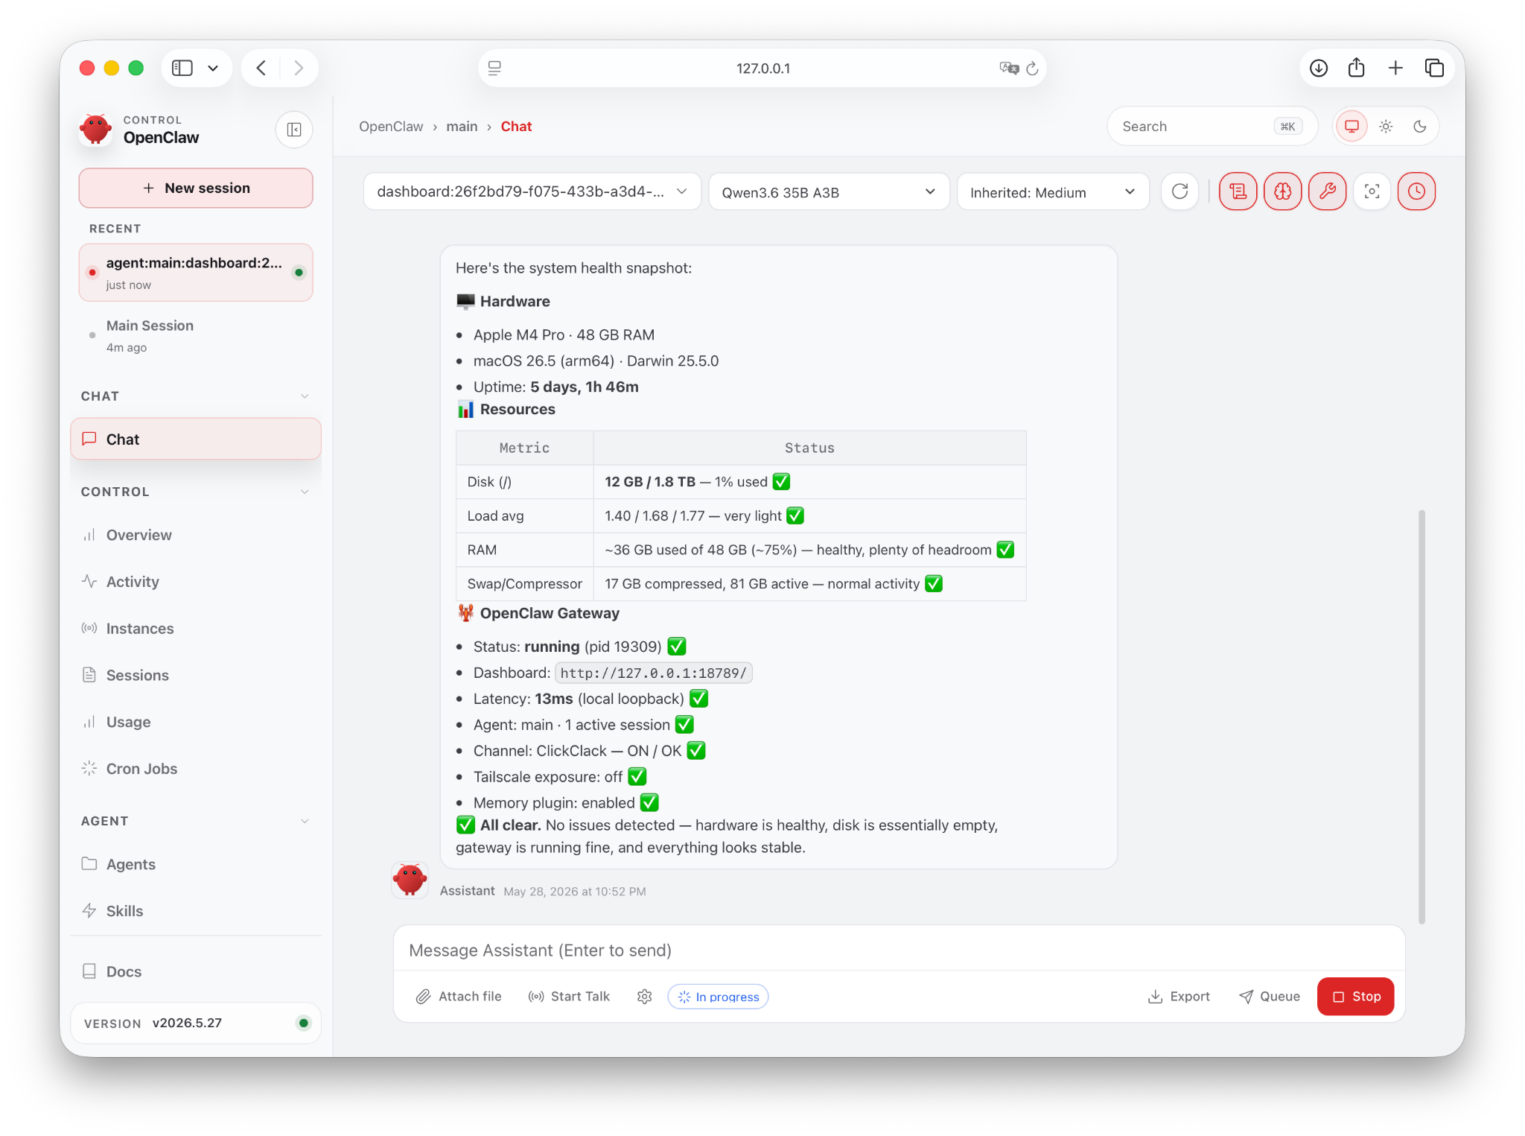
«Самодиагностика» в порядке, можно переходить к тестам.
Тесты OpenClaw с бекэндом LM Studio
В каталоге LM Studio есть разные модели как по архитектуре, так и по размеру. Перед тестами были загружены несколько моделей из топа подходящих под железо и минимально проверена их работоспособность: модель загружается и дает скорость, пригодную для интерактивной работы (на глаз). Часть моделей не подошла из-за таймаута при генерации ответа на запрос через OpenClaw, часть не удалось загрузить. Загрузка одной из моделей привела к перезагрузке Mac mini™ по неустановленной причине. В результате осталось три модели: google/gemma-4-26b-a4b-qat, qwen/qwen3.6-35b-a3b, google/gemma-4-31b.
Пинг
Протестируем скорость отклика агента. Попробуем пропинговать агента с разными моделями и сравним время их ответа. Для улучшения точности замеров предварительно закроем все тяжелые приложения в системе и будем поочередно загружать модели с контекстом 64k.
| Модель | Квантизация | Формат | Время, с |
| google/gemma-4-26b-a4b-qat | 4bit | MLX | 4 |
| qwen/qwen3.6-35b-a3b | Q4_K_M | GGUF | 3 |
| google/gemma-4-31b | Q4_K_M | GGUF | 12 |
Сводка новостей
Попросим OpenCLaw рассказать новости о компании Selectel. Запрос: «Расскажи новости про Selectel за последний квартал». Далее приведены полученные ответы от каждой из тестируемых моделей.
qwen/qwen3.6-35b-a3b
Вот основные новости по Selectel за последний квартал (Q1 2026):
—
**1. Финансовые итоги Q1 2026 (опубликованы 15 мая)**
– **Выручка** выросла на **14% г/г** до **5 млрд руб.** (включая 4,3 млрд от облачных инфраструктурных сервисов, тоже +14%)
– **Скорректированная EBITDA** — **2,7 млрд руб.** (+5% г/г), рентабельность **54%**
– **Чистая прибыль** — **0,9 млрд руб.** (+4% г/г), рентабельность 18%
– **Клиентская база** достигла **36,6 тыс.** (прирост 8,1 тыс. за год)
– **Чистый долг / EBITDA LTM** — **1,8x** — комфортный уровень
Общий фон: двузначный рост на фоне устойчивого спроса на облачную инфраструктуру в России.
—
**2. Итоги 2025 года (аудированная отчётность по МСФО, опубликована 1 апреля)**
– Выручка за 2025 — **18,3 млрд руб.** (+39% г/г)
– Компания подвела итоги года и опубликовала аудированную отчётность
—
**3. Сделка: Catalytic People приобрела 25% Selectel (июнь 2026)**
– **Catalytic People** (совместное предприятие **Т-Технологий** и **Интеррос** Владимира Потанина) приобрела **25%** акций Selectel за **16 млрд руб.**
– Доли в Catalytic People: Т-Технологии — **50,01%**, Интеррос — **49,99%**
– Сделка осуществляется в рамках стратегии вложений в высокотехнологичный сектор, в том числе для развития отечественных AI-моделей
– Это уже вторая волна подобных новостей: ранее (конец 2025) сообщалось о подготовке сделки
—
**4. Перспективы**
– Аналитики (в т.ч. T-Bank Invest, Sector IT) отмечают, что снижение ключевой ставки ЦБ положительно скажется на долговой нагрузке компании
– Выручка облачных сервисов растёт быстрее рынка — драйвером является спрос на AI-инфраструктуру
– Selectel рассчитывает удержать темпы роста и в 2026 году
Ответ содержит ошибку в п. 3. Сделка была объявлена 29 декабря 2025 года, а не в июне 2026. Сам текст написан разнородно: в отсутствие аналитики остается компиляция заголовков. На генерацию ответа ушло примерно 60 секунд.
google/gemma-4-26b-a4b-qat
На основе финансовых отчетов за первый квартал 2026 года (который завершился в марте), можно выделить следующие ключевые новости и показатели Selectel:
### 💰 Финансовые показатели (за I квартал 2026)
* **Выручка:** Составила **5 млрд рублей**.
* **Динамика:** Компания продолжает расти двузначными темпами, демонстрируя уверенную динамику даже на фоне напряженной экономической ситуации.
### 🏗️ Инвестиции и развитие (CAPEX)
Selectel продолжает активно расширять свои мощности. За прошедший квартал объем капитальных вложений (CAPEX) составил **2,8 млрд рублей**, которые были распределены следующим образом:
* **1,7 млрд руб.** — на закупку серверного оборудования;
* **0,9 млрд руб.** — на развитие инфраструктуры дата-центров.
### 📈 Общий итог
Отчетность за первый квартал характеризуется как «спокойная и качественная». Основной фокус компании остается на расширении инфраструктуры и поддержании темпов роста за счет наращивания серверных мощностей.
В тексте нет ошибок. По форме это больше как аналитическая заметка, а по содержанию ближе к пересказу пресс-релиза. Генерация заняла также около 60 секунд.
google/gemma-4-31b
Главная новость за последний квартал — финансовые результаты Selectel по итогам первого квартала 2026 года:
* **Выручка:** составила **5 млрд рублей**.
* **Рост:** выручка увеличилась на **14%** по сравнению с аналогичным периодом прошлого года.
* **Отчетность:** данные основаны на управленческой отчетности, соответствующей принципам МСФО.
Остальные новости в этот период носили преимущественно информационный характер, подтверждающий стабильный рост компании как независимого провайдера ИТ-инфраструктуры.
Этот ответ получился краткий и точный, но малоинформативный. Кроме того, на его генерацию ушло гораздо больше времени — 300 секунд.
Время ответа моделей собрано в таблице ниже.
| Модель | Время, с |
| google/gemma-4-26b-a4b-qat | 60 |
| qwen/qwen3.6-35b-a3b | 60 |
| google/gemma-4-31b | 300 |
Самый детальный ответ дала модель qwen3.6-35b-a3b за минимальное из всех моделей время. Модель gemma-4-31b генерировала ответ дольше всех, однако детализированность ответа меньше таковой у gemma-4-26b-a4b-qat.
Синтетические бенчмарки
Посмотрим, сколько «попугаев» в синтетических тестах покажет Mac mini™ M4 Pro. Воспользуемся Anubis — open-source приложением для тестирования производительности локальных LLM-моделей на процессорах линейки Apple Silicon.
Список моделей тот же — для сравнимости. В таблице указаны средние значения результатов 20 запусков.
| Модель | Токенов в секунду | Джоулей на 1 токен | TTFT, мс | Задержка генерации токена, мс |
| google/gemma-4-26b-a4b-qat | 59 | 0,38 | 237 | 17 |
| qwen/qwen3.6-35b-a3b | 50 | 0,45 | 96 | 20 |
| google/gemma-4-31b | 10 | 2,73 | 1 217 | 97 |
- Самой быстрой моделью по генерации токенов оказалась gemma-4-26b-a4b-qat — она же, по версии Anubis, еще и самая энергоэффективная. При схожей с qwen3.6-35b-a3b задержке генерации показатель TTFT (Time to First Token, время до первого токена) у модели Gemma оказался выше.
- Во всех тестах загруженность CPU не превышала 10%, в то время как загрузка GPU стабильно находилась около 99%. Такая загрузка показывает, что вычисления ложатся на GPU-часть Apple Silicon. Это ожидаемо для LLM-инференса через ML-фреймворки.
- gemma-4-31b — последняя по скорости и энергоэффективности. Плотная модель на 31B параметров без квантования ожидаемо проигрывает MoE-архитектурам: 10 токенов/с против 50–59, энергозатраты выше примерно в 6–7 раз.
- Обе MoE-модели gemma-4-26b-a4b-qat и qwen3.6-35b-a3b лидируют по пропускной способности. У них меньше активных параметров и быстрее инференс.
- Модель gemma-4-31b менее детальна, чем gemma-4-26b-a4b-qat. Плотная 31B-модель при 5-кратной разнице во времени генерации (300 с vs 60 с) выдала худший по детализации результат, чем квантованная 26B MoE.
- Модель qwen3.6-35b-a3b дает самый детальный ответ при наименьшем числе активных параметров. Казалось бы, модель с меньшим числом активных параметров должна выдавать менее развернутые ответы, но, вероятно, пропорциональной потери качества не происходит за счет архитектуры и качества обучающей выборки.
Заключение
По результатам тестов локальный запуск LLM на Mac mini™ выглядит вполне юзабельным. LLM-модели среднего размера выдают ответы с небольшой задержкой, что в сочетании с OpenClaw позволяет сделать из Mac mini™ полноценного ИИ-ассистента без использования подписок провайдеров LLM.
А для моделей большего размера можно рассмотреть выделенные или облачные серверы с более производительными GPU, в том числе с GPU NVIDIA® H300.