Сегодня тяжелый лень: почему на десктопе до сих пор нет нормального T9 и при чем тут LLM
Рабочие тексты большинство из нас набирает на компьютере, а умная автокоррекция почему-то досталась телефону. Мы настолько привыкли к этой разнице, что почти ее не замечаем: на телефоне слова исправляются сами, а на ПК остаются только красные подчеркивания и ПКМ. Почему же десктоп за столько лет так и не научился большему, и можно ли это как-то исправить с помощью LLM, которые сегодня у всех на слуху.
Для начала я решил взять Hunspell, на котором держится проверка орфографии в Firefox и LibreOffice, дал ему несколько слов, которые в любом айтишном чате пишут по 100 раз на дню и попросил подсказать исправления. Hunspell 1.7.2 со словарями ru_RU и en_US выдает вот что:
$ printf ‘%s\n’ задеплоил смержил запушил закоммитил пулреквест ретраи посморю | hunspell -i UTF-8 -d ru_RU,en_US -a
| Слово | Что предлагает Hunspell |
| задеплоил | задолбил |
| смержил | смерил, смежил, смердел |
| запушил | затушил, засушил, запулил, задушил, за пушил, зап ушил, запудрил |
| закоммитил | закормил |
| пулреквест | секвестр |
| ретраи | уретра |
| посморю | посмотрю, поссорю, поспорю, по сморю, пос морю, посмертию |
С жаргоном все ясно: словарь его не знает и знать не обязан, хотя вариант «задолбил» вместо «задеплоил» пусть и по-своему, но будет понятен. Куда интереснее обратная проверка на фразе без жаргона — «Сегодня тяжелый лень, нашел бар в релизе, кол перепишу завтра». В ней три опечатки, и заметны они невооруженным глазом, на это уходит секунды две.
$ echo "Сегодня тяжелый лень, нашел бар в релизе, кол перепишу завтра" | hunspell -i UTF-8 -d ru_RU -l
$
Ключ -l просит вывести только слова с ошибками, и пустой вывод означает, что все десять слов Hunspell считает правильными. Формально он прав, потому что «лень», «бар» и «кол» в словаре есть, а догадаться, что тяжелым бывает день, в релизе находят баги и переписывают код, можно только по соседним словам, которые словарная проверка не читает вообще.
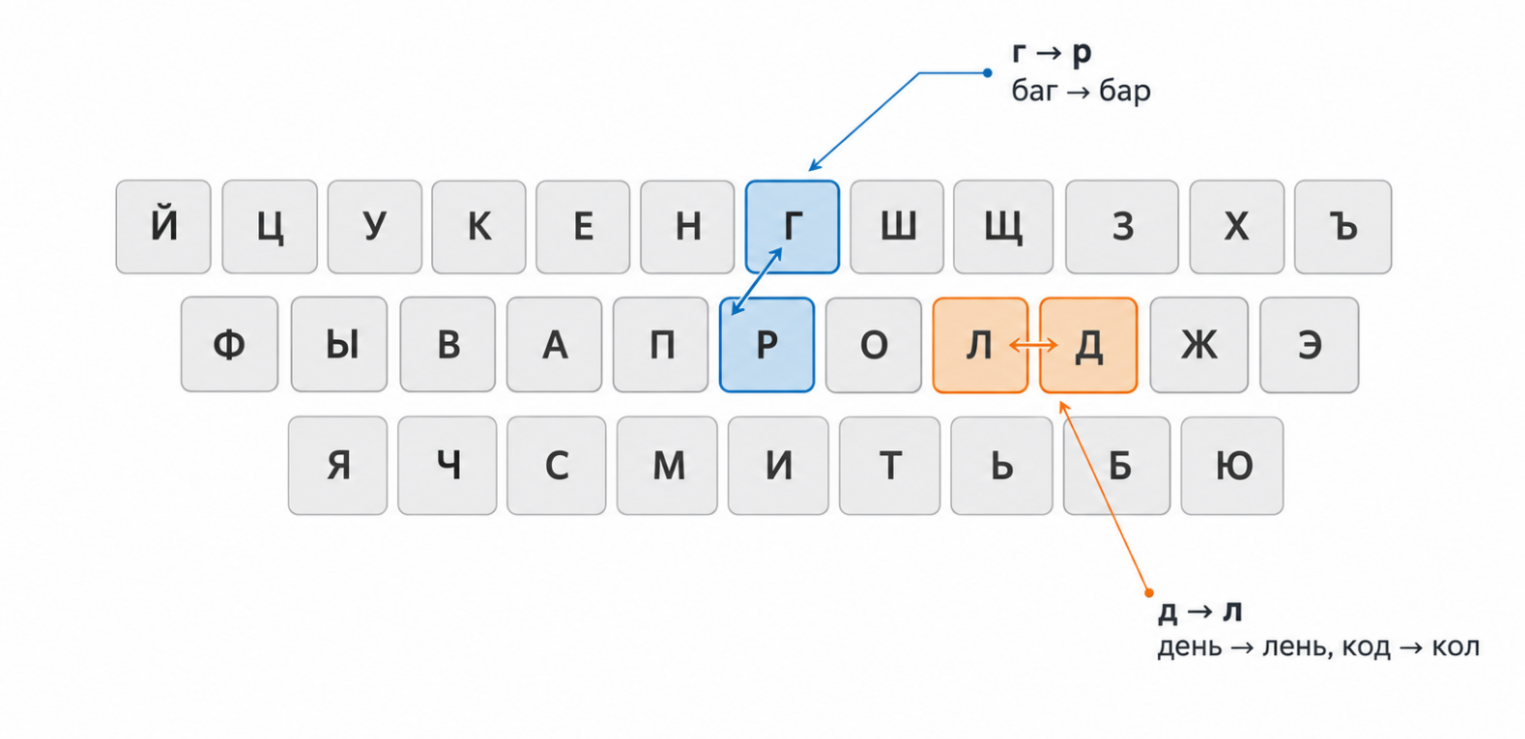
Причем все три ошибки самые бытовые из возможных, промах по соседней клавише. В раскладке «ЙЦУКЕН», известной в простонародии как QWERTY, буква «Д» соседствует с «Л», а «Г» — с «Р». Получается инструмент, который ругается на нормальные рабочие слова и в упор не видит настоящих ошибок.
Про LLM который год повторяют одну и ту же присказку, мол, нейросеть — всего лишь T9 на стероидах. Спорить с ней я не буду, потому что с инженерной точки зрения обе технологии действительно угадывают слово по тому, что вы уже ввели.
Меня куда больше интересует обратный вопрос: если нейросеть считается прокачанным T9, то где прокачанный T9 у меня на компьютере? Apple еще в 2023 году хвасталась, что автокоррекция на клавиатуре iPhone теперь работает на трансформерной модели прямо на устройстве. Телефонные клавиатуры давно смотрят на контекст, а на десктопе в 2026 году я получаю красную волну под «задеплоил» и полное молчание под «кол перепишу завтра».
Красная волна образца 1995 года
Десктопный подход к опечаткам сложился 30 с лишним лет назад и с тех пор почти не поменялся. Когда-то проверку орфографии в Word приходилось запускать самому, пока Тони Крюгер из команды Word не научил ее работать в фоне и сразу рисовать красную волну под подозрительным словом. В продукт эта волна попала с Office 95. По словам Стивена Синофски (в те годы он руководил разработкой Office, а позже возглавил подразделение Windows), волнистая линия просто повторяла пометку корректора. Это многое объясняет, потому что корректор помечает, а исправляет автор. Схема «программа показывает пальцем, человек исправляет мышкой» оказалась настолько удачной, что дожила до наших дней почти без изменений, и подчеркивание с правым кликом и списком вариантов, отсортированным без малейшего понимания того, о чем вы вообще пишете, мы видим и сегодня.
Телефоны пошли другим путем, потому что выбора у них не было. На стекле пальцы промахиваются мимо букв постоянно. Без быстрого исправления набрать осмысленное сообщение будет сложно, поэтому телефонная клавиатура с самого начала правит слова сама, прямо в процессе набора. И чем умнее языковая модель у нее внутри, тем реже она вас раздражает. На компьютере исходили из того, что десять пальцев на физических клавишах попадают куда надо, а если иногда и промахиваются, красной волны хватит.
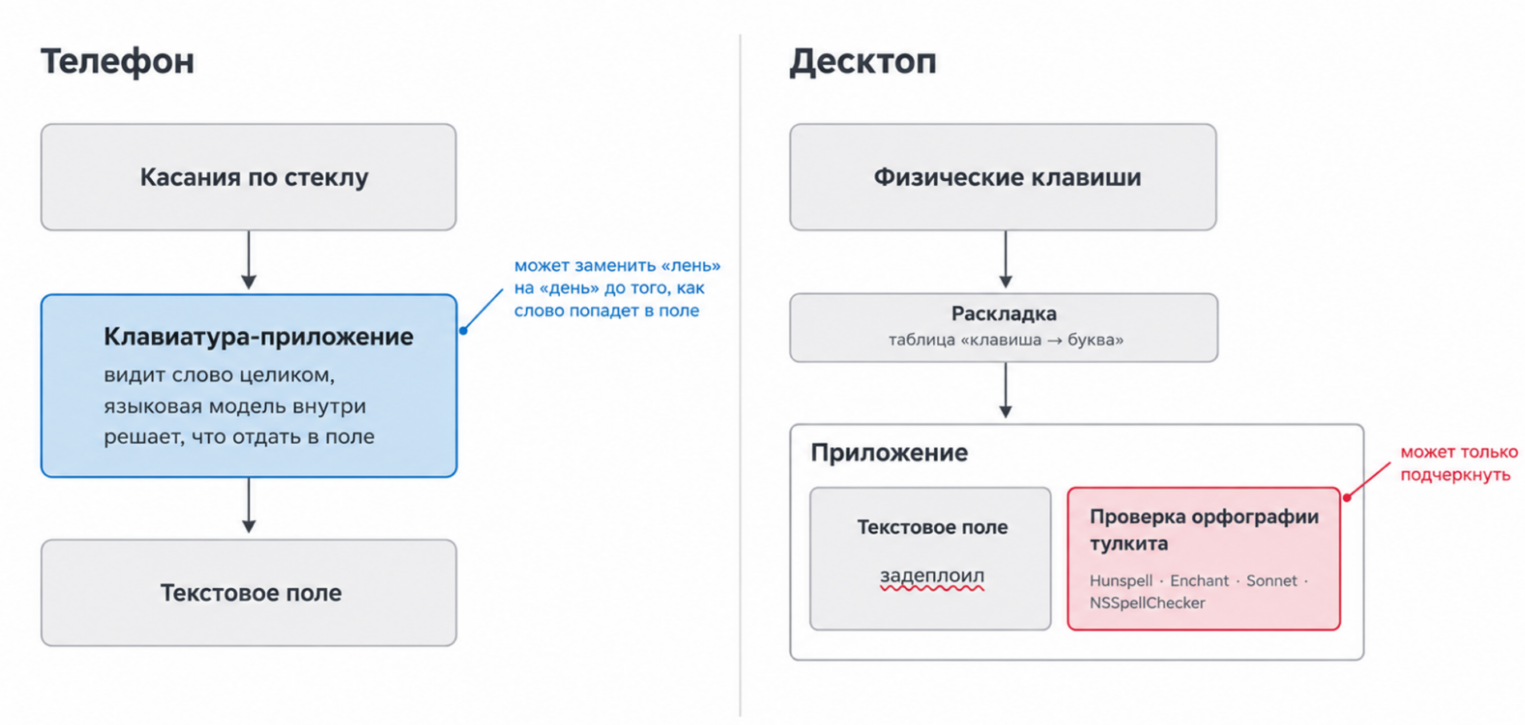
Из этого допущения выросла архитектура, которая сейчас и мешает сделать нормальный T9. На телефоне клавиатура является отдельной программой, через которую проходит весь ввод. Она видит набираемое слово целиком и сама решает, что отдать в текстовое поле, так что заменить «лень» на «день» ей ничего не стоит.
На десктопе для латиницы и кириллицы метод ввода выродился до таблицы раскладки. Нажатия почти без обработки прилетают в приложение, и проверка орфографии живет внутри текстовых полей конкретного тулкита. Поэтому качество вашего T9 зависит от того, на чем написано приложение, в котором вы сейчас печатаете, и отсюда растет весь зоопарк.
Что дают из коробки
macOS
Начнем с macOS, потому что на бумаге у Apple все выглядит лучше всех. В Sonoma автокоррекцию перевели на трансформерную модель, но в описании нововведений прямо сказано, что это касается английской, французской и испанской клавиатур. Русского в этом списке нет, и что именно правит русские слова, Apple не рассказывает. Так что я не уверен, есть ли там вообще что-то умнее словаря.
Вторая новинка той же Sonoma, серые подсказки прямо в строке, принимается пробелом или табом и доступна тоже не на всех языках. На старте ее можно было увидеть только в родных приложениях вроде Notes, Mail и TextEdit, потом подтянулись сторонние нативные программы вроде Drafts и Mimestream.
Пользователи Obsidian при этом уже пару лет просят сделать так же и у них. И в той же ветке им объясняют, что поддержку, видимо, сначала придется добавить в сам Electron, на ограничения которого на том же форуме списывают и неработающие системные текстовые замены. Вдобавок подсказки умудряются ломать сниппеты TypeIt4Me, оставляя перед развернутым текстом лишние буквы. В FAQ разработчиков этот пункт тянется от Sonoma до Tahoe.
Так что поведение T9 в macOS зависит от того, какое окно сейчас в фокусе, с соседними помощниками набора он конфликтует.
Windows
У Windows история иная. Подсказки для физической клавиатуры появились еще в Windows 10 версии 1803. Microsoft нацеливала их на тех, кто учит английский, на образование и на доступность. По умолчанию они выключены и для части языков недоступны, а чтобы выбрать подсказку, надо нажать стрелку вверх, потом стрелками влево и вправо найти нужный вариант и подтвердить его клавишей Enter.
Представьте, как это выглядит при скорости набора в 300 знаков в минуту. Пока вы жмете стрелки, слово можно было допечатать руками пару раз. Переключатели автоисправления и подсветки ошибок, по словам Пола Турротта, журналиста, давно специализирующегося на Microsoft, в Windows 11 вообще относятся к сенсорной клавиатуре для планшетов. А те, кто все-таки включил подсказки, не могут на них положиться. Например, на форуме поддержки Microsoft один из пользователей пишет, что раньше подсказки появлялись почти в любом приложении, а потом просто пропали.
Linux
На Linux системного T9 нет вообще. Каждый тулкит и каждое приложение сами решают, чем проверять орфографию. Firefox и LibreOffice используют Hunspell, GTK-приложения проводят слова через Enchant, KDE — через Sonnet. Ближе всего к общесистемному решению, насколько я знаю, подбирается ibus-typing-booster, который работает как отдельный метод ввода со всеми вытекающими.
Автор SmartKey, еще одного движка для IBus, в README жалуется ровно на то же: предиктивные клавиатуры на линуксовом десктопе у него либо вываливают на вас абзацы в стиле Copilot, либо дополняют префикс по словарю без всякого понимания контекста. Лечит он это, что характерно, ансамблем старых добрых статистических моделей на n-граммах, обходясь без нейросетей.
Ghbdtn? vbh!
Заголовок этого раздела означает «Привет, мир!», набранное не в той раскладке. Для тех, кто пишет сразу и кириллицей, и латиницей, это отдельный круг ада. Угадывать раскладку по тексту операционные системы так и не научились, и нишу давно занимает Punto Switcher.
Но и это не панацея. Автор открытого RuSwitcher в статье на Хабре напоминает, что macOS Punto Яндекс перестал развивать еще в ноябре 2017 года, исходники у программы закрыты, а среди функций есть «Дневник». Для тех, кто не в курсе, это функция-кейлоггер, которая, судя по описанию на странице поддержки самого Яндекса, сохраняет в дневник все, что вы печатаете.
Но даже идеально работающий переключатель упирается в фундаментальную проблему, потому что решение он принимает в пределах одного слова. С «ghbdtn» так разобраться легко, потому что по-английски такого слова не бывает. С «мы» уже сложнее: набранное в английской раскладке, оно превращается в «vs», которое в английском тексте существует вполне законно (Hunspell с обоими словарями, кстати, с чистой совестью принимает и то, и другое).
Предлог «в» при этом становится буквой «d», союз «и» — буквой «b». Чтобы понять, что конкретно имелось в виду, неизбежно приходится смотреть на соседние слова. Во фразе «завтра vs идем в кино» ответ очевиден любому человеку. Кто-то уже, возможно, понял, что для этого нужна штука, которая умеет оценивать вероятность целой фразы в каждой из двух раскладок, и к этому мы еще вернемся.
Будущее уже здесь, просто распределено неравномерно
Вы скажете, в 2026 году нейросети есть почти в каждом пылесосе, разве никто не прикрутил их к исправлению опечаток? Прикрутили. И вариантов даже несколько, но у каждого из них обнаруживается свой подвох.
Раньше всех появились облачные проверялки. Среди них LanguageTool поддерживает больше 25 языков (включая русский), и ловит ошибки, которые обычная проверка орфографии не замечает. Grammarly годами оставался сугубо англоязычным и только в сентябре 2025 года начал добавлять другие языки, так что сейчас в его официальном списке 20+ языков, но пока без русского. Работают оба сервиса по схеме 1995 года, только с умным бэкендом. Текст при этом по умолчанию уезжает к ним на серверы, но при желании LanguageTool можно поднять у себя, если вы не боитесь Java.
Apple Intelligence умеет вычитывать текст по запросу, когда вы выделили кусок и попросили. В iOS 27, вышедшей 14 сентября, список поддерживаемых языков дорос до 16 (но русского в нем нет).
Google встроил Gemini Nano (она весит от 2,7 до 4 ГБ) прямо в Chrome и сделал поверх него в том числе Proofreader API. Это API для веб-приложений и расширений. Для запуска модели нужно минимум 22 ГБ свободного места на диске, 16 ГБ RAM и четыре ядра или видеокарта с памятью строго больше 4 ГБ. Все это нужно просто для проверки орфографии в браузере, но пользоваться всем этим будут только те сайты и расширения, которые сами прикрутили API.
Ближе всего к нужному подобрались инди-разработчики. Тут стоит посмотреть на Cotypist, который дописывает текст по всей системе на macOS с помощью локальной модели. Его автор, Даниэль Грефе, полтора года строил сервис на Accessibility API, которые вообще-то сделаны для экранных дикторов. Идея, по его словам, выросла из странной привычки копировать переписку в Visual Studio Code ради подсказок Copilot и вставлять результат обратно туда, где он изначально писал. Под капотом у Cotypist крутятся локальные модели семейств Gemma и Qwen, в списке фич значится полноценная автокоррекция, и работает он в том числе в Obsidian, куда системные подсказки Apple так и не добрались. Программе нужно 16 ГБ памяти, в Google Docs она заработает только после включения режима доступности, а в редакторах кода вроде VS Code и Cursor ограничивается боковыми AI-чатами.
Следом на GitHub расплодились открытые клоны. KeyType следит за текстовым полем в фокусе и показывает продолжение серым текстом, которое вставляется по нажатию на Tab, а Pretype вдобавок вешает над опечаткой плашку с исправлением и ждет того же Tab, то есть красная волна образца 1995 года у него просто переехала в плашку над курсором. TabType гоняет на macOS Qwen3-4B через MLX и тоже обещает автокоррекцию, а Cotabby и вовсе умеет брать в качестве движка встроенную модель Apple Intelligence через фреймворк FoundationModels, так что подходящая языковая модель у Apple в системе уже лежит. Все перечисленное, включая сам Cotypist, существует только для macOS, и пользователям Windows и Linux на этом празднике жизни пока остается смотреть со стороны.
На другом конце спектра лежит проект macOS-global-autocomplete. В его README капсом написано, что по сути это кейлоггер. Он складывает все набранное открытым текстом в /var/log/keystroke.log, а ставить его стоит, только если вы готовы отдать вообще все, что делаете на компьютере, ради скромного прироста продуктивности. Автору за честность можно только поаплодировать, потому что любой общесистемный T9 технически и есть кейлоггер, просто обычно об этом пишут мелким шрифтом.
При чем тут LLM
Чтобы понять, как такая штука должна работать, полезно посмотреть на оригинальный T9 с кнопочных телефонов. На двойке там висели АБВГ, на пятерке — МНОП, поэтому «мама» и «папа» набирались одной и той же последовательностью 5252. Телефон выбирал вариант по встроенному словарю примерно на 40 000 слов. По сути, это максимально простенькая языковая модель — она знает, какое слово встречается чаще вообще, но понятия не имеет, что вы писали секунду назад.
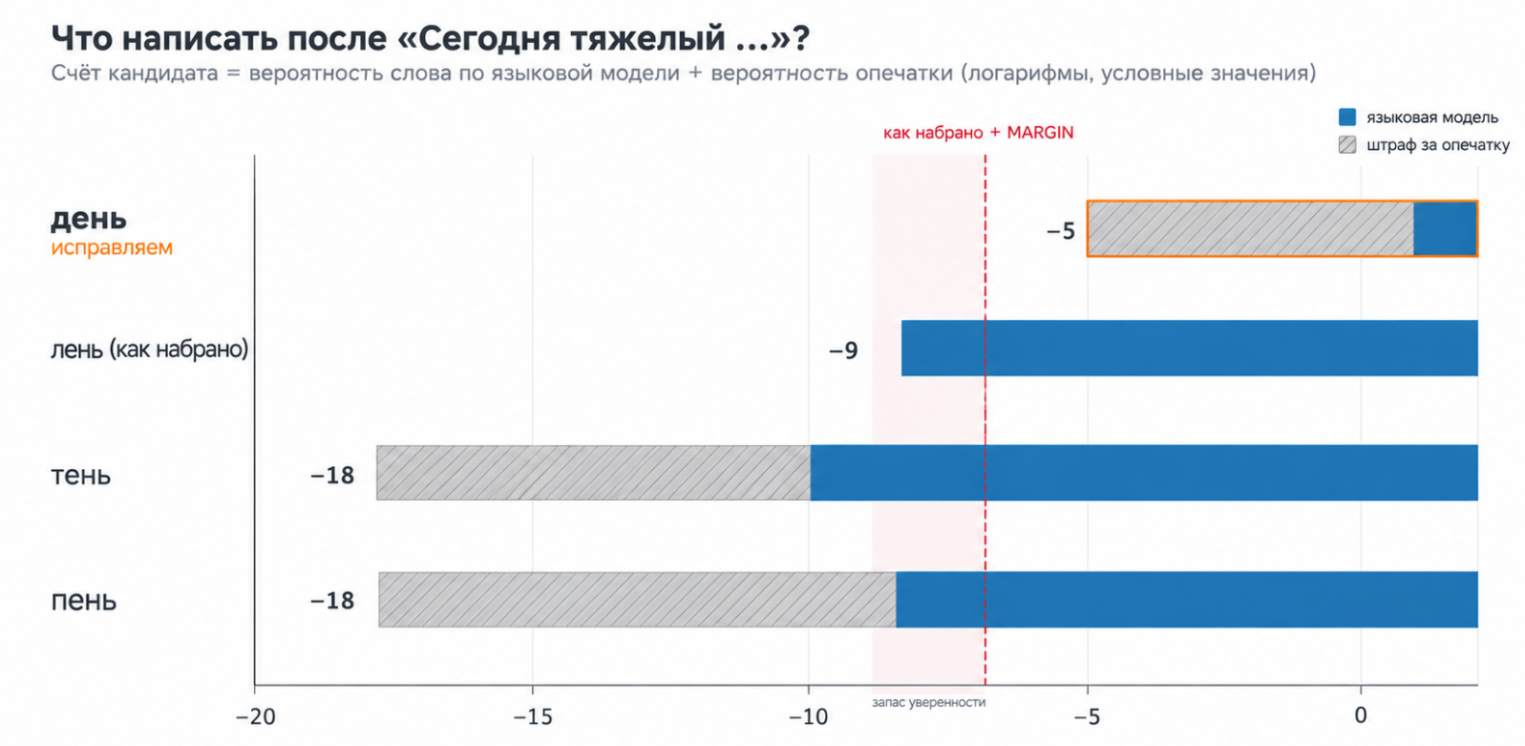
Если отбросить детали, любой корректор опечаток перемножает две вероятности: насколько правдоподобно, что, собираясь написать «день», вы набрали «лень» (соседняя клавиша, пропущенная или лишняя буква, перестановка, не та раскладка), и насколько правдоподобно само слово «день» в этом месте текста. Это классическая модель зашумленного канала, и побеждает в ней кандидат с наибольшим произведением. У словарных корректоров первый множитель худо-бедно есть в виде расстояния редактирования, а второго нет вовсе. Именно поэтому в подсказках к «посморю» рядом с «посмотрю» стоят «поссорю» и «посмертию». Да, вероятность того, что человек в рабочем чате собирался написать «посмертию» — примерно нулевая (но никогда не равна нулю), но оценить ее Hunspell нечем.
Второй множитель и есть ровно то, что LLM умеет лучше всего на свете. Языковая модель — по сути, одна большая функция, которая по предыдущему тексту выдает вероятности следующего токена. Вопрос «что вероятнее после слов „Сегодня тяжелый“: „лень“ или „день“?» для нее тривиален. Так что присказка про T9 на стероидах внезапно оказывается готовым техническим заданием: нам нужен именно T9, у которого вместо частотного словаря стоит нейросеть.
Первым в голову приходит самый прямолинейный вариант, которым в том или ином виде сейчас занимаются все крупные вендоры: отдать текст модели с просьбой исправить опечатки. Для исправления на лету это тупик, потому что чат-модель обучена помогать и охотно «улучшит» вам стиль, заменит слова на более «красивые» и расставит запятые там, где вы их не хотели. Вдобавок она генерирует весь текст заново, токен за токеном, и ждать после каждого пробела, пока модель перепишет сообщение целиком, никто не станет. Да и гарантии, что в ответе поменялись только опечатки, нет никакой. Подозреваю, именно поэтому у вендоров все это оформлено кнопками «вычитать» и «переписать», которые жмут уже после набора.
Гораздо правильнее использовать модель как измерительный прибор. После каждого пробела берем набранное слово, генерируем кандидатов дедовскими методами (соседние клавиши, пропуски, перестановки, другая раскладка), а у модели спрашиваем, какова вероятность каждого кандидата после уже набранного текста. Генерировать при этом ничего не нужно, контекст один раз прогнан через модель и лежит в кэше, так что каждый кандидат обходится в несколько токенов, а в коде это выглядит примерно так (условно):
def fix(context, typed):
    best = typed
    best_score = lm.logprob(context, typed)  # как набрано, без правок
    # соседние клавиши, пропуски, перестановки, плюс ghbdtn -> привет
    for cand in neighbors(typed) + [flip_layout(typed)]:
        score = lm.logprob(context, cand) + typo_logprob(typed, cand)  #
        if score > best_score + MARGIN:  # правим только с запасом, иначе молчим
            best, best_score = cand, score
    return best
Самая важная константа во всей конструкции живет в переменной MARGIN. На настоящих опечатках вроде «посморю» разница между кандидатами огромная, а вот валидное слово модель должна заменять только при очень сильной уверенности. Потому что исправить «лень» на «день» в тексте про прокрастинацию куда обиднее, чем пропустить одну опечатку. Для этого в формуле и сидит typo_logprob: вероятность того, что «лень» получилась из «день» промахом по соседней клавише, заметно меньше вероятности того, что вы просто написали «лень», и языковой модели придется это перевесить.
Теперь посчитаем бюджет времени. Допустим, мы набираем 300 знаков в минуту. Это 5 знаков в секунду, то есть между нажатиями проходит около 200 мс. Примерно в это окно исправление и должно успеть прилететь, иначе программа начнет подменять слово в тот момент, когда вы уже печатаете следующее. И здравствуйте, гонки за содержимое текстового поля. Благо, задача эта уже давно решена: в JetBrains еще в 2024 году встроили в свои IDE локальную модель на 100 миллионов параметров, которая дописывает строки кода, а Cotypist крутит на macOS модели от одного до четырех миллиардов параметров и выдает подсказки прямо по ходу набора. Посчитать вероятности пяти кандидатов по паре токенов, прогнав их одним батчем, по задержке выходит не дороже, чем сгенерировать несколько токенов продолжения. Так что железо тут давно перестало быть узким местом.
Любопытно, что авторы открытого KeyType пришли к очень похожим правилам со своей стороны. В инструкции проекта записано, что:
- лучше промолчать, чем подсказать глупость;
- модель берется базовая, без всякого чата, и промпт обрывается ровно на курсоре;
- по умолчанию модель дописывает не больше четырех токенов;
- каждое новое нажатие отменяет генерацию, которая не успела закончиться.
Бонусом тот же механизм закрывает историю с раскладкой, потому что для него «vs» и «мы» — просто два кандидата, один из которых после слова «завтра» в русском тексте несравнимо вероятнее другого. А если сомнения остаются, можно дождаться следующего слова и пересчитать. Никаких эвристик про сочетания букв для этого не нужно.
Кто виноват и что делать
Если с математикой все хорошо, а железо тянет, почему же нормального T9 на десктопе до сих пор нет? Оказывается, чтобы в чужом приложении исправить слово, его (слово) надо сначала прочитать, а потом заменить. Путей для этого, по большому счету, три.
Можно, как переключатели раскладки, слушать клавиатуру глобальным хуком (RuSwitcher, например, сидит на CGEventTap). Но тогда вы видите только поток нажатий без окружающего текста, исправляете слово пачкой бэкспейсов с перепечаткой и надеетесь, что пользователь в этот момент не успел нажать что-нибудь еще.
Можно пойти через Accessibility API, как Cotypist и его клоны, то есть читать значение поля в фокусе и позицию курсора, подменять текст и молиться, чтобы конкретное приложение реализовало все это без самодеятельности. А когда оно не реализовало, то писать в документации, что в Google Docs надо включить режим доступности.
А можно стать методом ввода, как ibus-typing-booster или китайские и японские IME. Тогда нажатия идут через вас по определению, зато ваш T9 обязан заменить собой системную раскладку, и окружающий текст метод ввода видит далеко не всегда. На любом из этих путей придется годами разгребать чужие особенности реализации, и полтора года автора Cotypist выглядят тут скорее оптимистичной оценкой.
Потом начинается вопрос доверия, и он ничуть не проще. Программа, которая видит каждое нажатие во всех приложениях, технически ничем не отличается от кейлоггера, и после истории с «Дневником» (пусть и выключенным по умолчанию) я бы такую штуку с закрытым кодом и облачной моделью себе не ставил. Этим, похоже, уже пользуются: у KeyType, который написан на Swift, на GitHub завелся двойник «KeyType-731». Он ставится через python setup.py, а в README авторы советуют, если установка не запускается, добавить папку в исключения защиты или на пару минут ее (защиту) приостановить. Значит, модель обязана быть локальной, код открытым, ставить все это надо из оригинального репозитория, а поля паролей программа должна обходить стороной, благо macOS при фокусе на таком поле, насколько я знаю, и так включает защищенный ввод.
Еще одна стена — языковая, и для русского языка она самая удручающая. Трансформерную автокоррекцию Apple в Sonoma запускала для английского, французского и испанского. Среди 16 языков Apple Intelligence, как мы уже обсуждали выше, русского нет. В списке Grammarly его тоже нет, хотя польский и чешский там есть. Крупным вендорам логично сначала вылизать английский, потом крупные рынки, а до остальных очередь доходит медленно, если доходит вообще. Утешает разве что то, что открытые модели вроде Qwen и Gemma, на которых сидят инди-проекты, русский худо-бедно понимают, так что независимым разработчикам ждать милости от вендоров не обязательно.
Остальное решаемо, хотя и требует аккуратности. Например, в терминале и IDE автозамену надо выключать по умолчанию, исправление должно отменяться одним бэкспейсом сразу после замены, как на телефоне, а порог уверенности лучше задрать так, чтобы программа скорее пропустила опечатку, чем испортила правильное слово. Это инженерная рутина, с которой справится любой, кто уже продрался через интеграцию.
Поэтому прогноз у меня не то что бы утешительный. Кнопка «переписать с помощью ИИ» доберется до каждого текстового поля раньше, чем операционные системы из коробки научатся тихо менять «лень» на «день» в русской раскладке во время набора. Потому что кнопка с ИИ красиво смотрится в презентации, а отсутствующую функциональность замечают только тогда, когда она нужна, но ее нет. Если вы как раз из тех, кто соберется писать открытый T9 на локальной модели сразу под все три системы, зовите в бету. А я пока пойду объяснять Hunspell, что ретраи к урологии отношения не имеют.