8 октября компания JetBrains представила открытую языковую модель Mellum2.1. Новинка развивает предыдущую версию Mellum2, вышедшую в июне, и распространяется по лицензии Apache 2.0. В основе модели лежит архитектура mixture-of-experts объемом 12 млрд параметров, из которых при обработке запросов задействованы 2,5 млрд активных параметров. Разработчики сохранили прежнюю структуру сети, поэтому ключевые изменения затронули этап постобучения.
Основой тренировочного процесса стало обучение с подкреплением. Инженеры создали собственную инфраструктуру, которая позволила развернуть тысячи окружений и запустить миллионы изолированных сред. Команда расширила набор обучающих задач, добавив дисциплины по математике, спортивному программированию, естественным наукам, работе с внешними инструментами и программной инженерии. Открытые и внутренние наборы данных проходили тщательный отбор: из них удаляли непроверяемые ответы, неработающие тесты, а также задания со слишком низким или, напротив, невыполнимым уровнем сложности.
Сценарии работы
Mellum2.1 рассчитана на работу в составе кодинг-агентов, субагентов и автономных систем. Модель способна ориентироваться в кодовой базе репозитория, самостоятельно редактировать файлы и тестировать внесенные правки. В рамках решения инженерных задач она определяет причины падения автотестов, предлагает варианты исправления и проверяет корректность их выполнения.
Помимо написания кода, модель справляется с обязанностями универсального ассистента. Она отвечает на повседневные вопросы пользователей и пошагово расписывает решения сложных математических и логических задач. Возможность локального запуска и развертывания на собственных серверах позволяет инженерам сохранять полный контроль над исходным кодом и конфиденциальными данными.
Скорость работы и результаты бенчмарков
Mellum2.1 протестировали по единой методике вместе с предыдущей версией Mellum2, а также открытыми моделями аналогичного класса — Qwen3.5-9B и Gemma 4 E4B. Наибольший прогресс относительно предшественника зафиксирован в задачах агентного программирования. Модель также показала рост показателей в математике, вызове функций и ответах на общие вопросы.
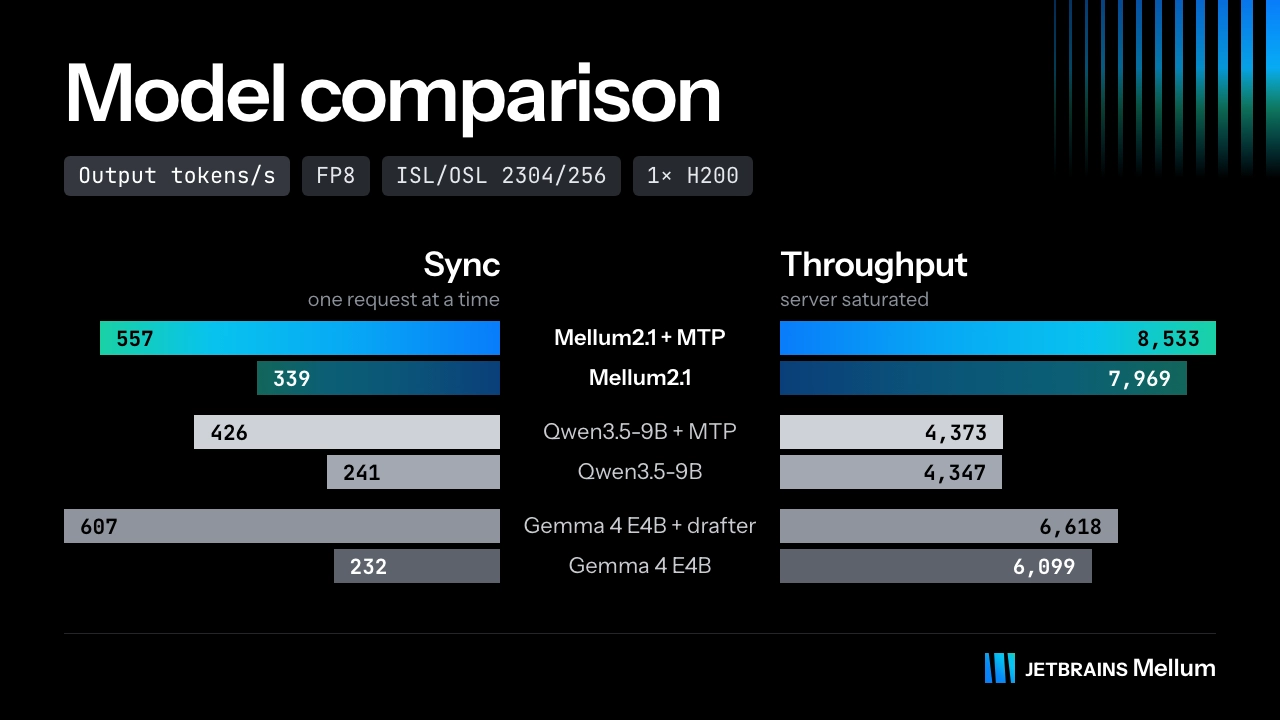
Поскольку архитектура осталась прежней, базовая скорость работы сохранилась, а внедрение механизма предсказания нескольких токенов (multi-token prediction) увеличило производительность. При обработке одиночных запросов скорость выросла примерно в 1,6 раза. В условиях высокой параллельной нагрузки Mellum2.1 обрабатывает почти в два раза больше токенов по сравнению с Qwen3.5-9B.
Где найти модель
Разработчики опубликовали Mellum2.1 в репозитории Hugging Face. Также готовятся версии в формате GGUF для работы через llama.cpp, Ollama и LM Studio. В разработке находится и специальный модуль предсказания токенов для спекулятивного декодирования в среде vLLM.