Реализация Graceful Shutdown для Python-приложений в Kubernetes

Часто ли вы сталкиваетесь с проблемой потери данных, неконсистентными состояниями или ошибками в Sentry о внезапно закрытых соединениях при рестарте сервисов? Если вы когда-нибудь пытались это исправить, то наверняка слышали про Graceful Shutdown.
Привет! Меня зовут Антон, я бэкенд-разработчик Python в Selectel. В этой статье поделюсь опытом внедрения Graceful Shutdown в наши сервисы и расскажу, с какими сложностями мы столкнулись.
Что такое Graceful Shutdown
Дословно Graceful Shutdown переводится как «изящное выключение». Можем сделать логичный вывод, что это процесс корректного завершения работы приложения. Когда процесс получает сигнал остановки, он последовательно выполняет следующие шаги:
- прекращает принимать новые запросы;
- ожидает завершения всех активных задач;
- закрывает соединения с базами данных, брокерами сообщений и другими внешними ресурсами;
- завершает свою работу.
Благодаря этому активные запросы не обрываются на середине транзакции, а сообщения в брокере обрабатываются до конца.
Спойлер: возможно, полностью исключить редкие сбои в распределенных системах и не выйдет, но такой подход поможет свести их количество к минимуму.
Основные понятия
Перед тем как перейти к реализации, быстро пройдемся по ключевым терминам:
- In-flight запросы — активные запросы, которые начали обрабатываться до сигнала завершения и продолжают выполняться после его получения.
- Drain-период — временной интервал, в течение которого сервис перестает принимать новые запросы и завершает обработку всех in-flight-запросов.
- Grace-период — время, которое контейнеризатор (например, Docker) или оркестратор (в нашем случае — Kubernetes) выделяет на полное завершение работы сервиса до принудительной остановки.
- Сигнал SIGTERM — сигнал, который отправляется для запуска сценария плавного завершения работы процесса.
- Сигнал SIGKILL — сигнал принудительной остановки процесса.
Как это работает
Разберем, как на практике устроен процесс плавного завершения, какие тайминги мы используем и что произойдет, если сервис не уложится в отведенное время.
Идеальный сценарий
В штатном режиме процесс остановки выглядит так:
- Kubernetes отправляет поду сигнал SIGTERM.
- Приложение перехватывает сигнал и прекращает принимать новые запросы.
- Сервер завершает обработку in-flight запросов.
- Закрываются все соединения с внешними ресурсами и базами данных.
- Приложение завершает работу.
На втором шаге поведение API и воркеров различается. В первом случае за остановку приема новых запросов будет отвечать WSGI-сервер. Для воркеров же реализовывать данную логику придется вручную, если используемая библиотека не поддерживает ее «из коробки».
Что может пойти не так
Если сервису не хватит drain- или grace-периода, события могут развиваться по двум сценариям.
Первый сценарий: In-flight запрос обрабатывается дольше drain-периода. В этом случае API вернет пользователю ошибку со статусом 500, а воркер прервет выполнение задачи. С такими ситуациями приходится мириться: мы не можем бесконечно откладывать деплой ради единичных долгих запросов.
Второй сценарий: сервер не укладывается в grace-период. Тогда Kubernetes принудительно остановит его с помощью сигнала SIGKILL. Это происходит по двум причинам:
- Во время drain-периода. Это значит, что толку от наших стараний примерно ноль, так как получаем мы практически то же самое, с чего начинали. Решается эта проблема достаточно легко: drain-период должен быть меньше grace-периода.
- После drain-периода. В этом случае мы, скорее всего, оставили мало времени на закрытие соединений после завершения всех запросов. Можно увеличить разницу между периодами, и будет нам счастье.
Также существует известная проблема с балансировкой трафика в Kubernetes. Одновременно с отправкой сигнала SIGTERM оркестратор начинает исключать под из списка активных адресов. Этот процесс занимает некоторое время, в течение которого может возникнуть ситуация, когда под уже переходит в стадию завершения работы, а балансировщик направляет ему новый запрос. Чтобы решить эту проблему, добавьте команду sleep в хук preStop. Задержка перед отправкой SIGTERM даст балансировщику время обновить список адресов.
Тайминги
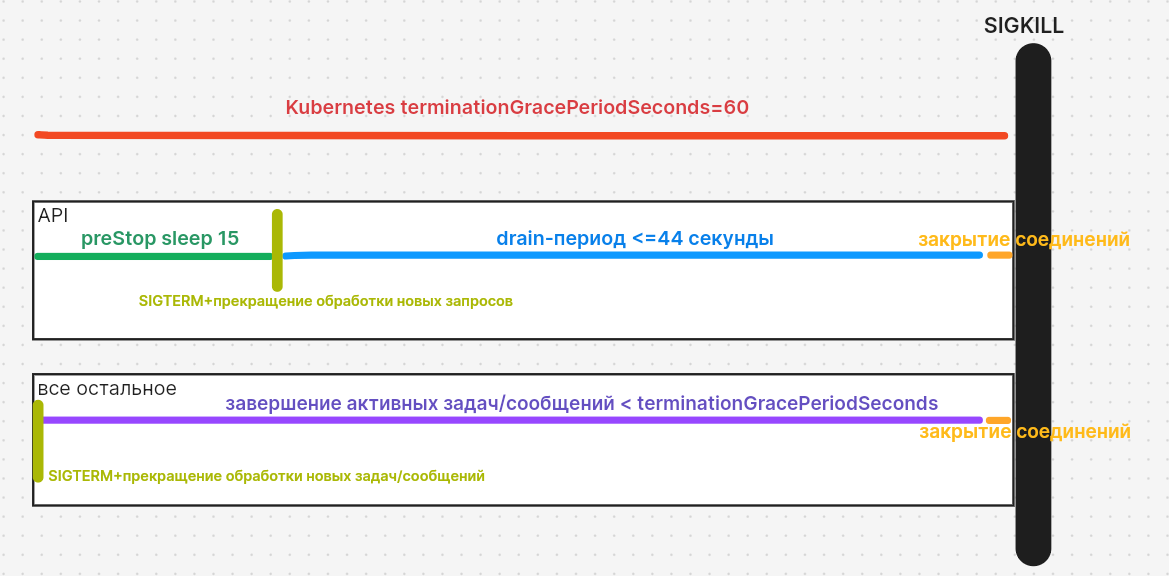
Мы проанализировали работу наших сервисов и выбрали следующие интервалы:
- grace-период — 60 секунд;
sleepв preStop-хуке — 15 секунд;- drain-период — 44 секунды.
Реализация
Давайте сразу обозначим технологический стек. Как уже было сказано ранее, управлением контейнеров у нас занимается Kubernetes. В качестве WSGI/ASGI серверов используем uWSGI, Gunicorn и Uvicorn. Возьмем фреймворки Flask и FastAPI, а для воркеров воспользуемся Celery и Dramatiq.
Итак, начнем с настройки оркестратора.
Настройка Kubernetes
Чтобы подготовить оркестратор, потребуется изменить конфигурационные файлы:
- Добавляем параметр
terminationGracePeriodSecondsв значении 60 секунд для всех манифестов Deployment: API, воркеров и планировщика задач (scheduler). Дефолтное значение — 30. - Реализуем preStop-хук с задержкой в 15 секунд (
sleep 15) в Deployment API. Это решит проблему с балансировкой трафика при пересоздании подов.
Настройка WSGI-серверов
uWSGI
Нужно добавить в конфигурационный файл .ini следующие параметры:
die-on-term = true— по умолчанию uWSGI при получении SIGTERM выполняет жесткую перезагрузку всего стека. Данный флаг исправляет эту проблему. Разработчики планируют изменить дефолтное поведение в версии 2.1, которая еще не вышла на момент написания статьи.hook-master-start = unix_signal:15 gracefully_kill_them_all— указывает воркерам дожидаться завершения обработки запросов. Важно: для корректной работы параметра обновите uWSGI до версии 2.0.27 или выше.http-socket = <ip>:<port>— если вместо него использовать параметрhttp, то все соединения будут проходить через один master-процесс, который при получении сигнала завершится и закроет все сетевые соединения. В результате воркеры завершат работу, но не смогут вернуть ответы клиентам.reload-mercy = 44— задает длительность drain-периода в секундах (по умолчанию — 60).
gunicorn
В файле gunicorn.conf.py потребуется указать параметр запуска graceful_timeout = 44. Параметр задает время ожидания перед принудительной остановкой воркеров (по умолчанию — 30).
uvicorn
Также необходимо добавить параметр запуска: --timeout-graceful-shutdown 44. По умолчанию параметр равен None, что означает мгновенную остановку всех процессов без ожидания.
Настройка фреймворка
FastAPI
В FastAPI для управления жизненным циклом приложения и корректного закрытия соединений будем использовать lifespan и контекстный менеджер:
      import asyncio
import logging
from contextlib import asynccontextmanager
from fastapi import FastAPI
from db.path import dispose_db

logger = logging.getLogger(__name__)

@asynccontextmanager
async def lifespan(application: FastAPI):
    ...

    yield

    logger.info("closing connections")
    async def dispose_db()
    ...

app = FastAPI(lifespan=lifespan)
Последовательность действий при получении сигнала SIGTERM:
- Uvicorn принимает сигнал.
- Сервер перестает принимать новые входящие запросы.
- Ожидается завершение активных соединений в течение времени, заданного в
--timeout-graceful-shutdown. Если запросы не успевают обработаться, клиенты получают ошибку со статусом 500. - Выполняется блок кода в
lifespanпосле оператораyield.
Рассмотрим примеры работы, когда drain-период равен 15 секундам.
Сценарий 1: время обработки запроса превышает drain-период. Если обработчик выполняется, скажем, 20 секунд, то пользователь получит ошибку со статусом 500. Спустя еще 10 секунд в консоли появится строка shutdown Ended.
      @asynccontextmanager
async def lifespan(app: FastAPI):
    print(f"Before yield (startup)")
    yield
    await asyncio.sleep(10)
    print(f"shutdown Ended")

app = FastAPI(lifespan=lifespan)

@app.get("/")
async def root():
    await asyncio.sleep(20)
    return f"root ended"
Сценарий 2. Запрос успевает обработаться в рамках drain-периода. Так, например, если обработчик выполняется плюс-минус 10 секунд, пользователь успешно получит ответ со статусом 200. Спустя еще 10 секунд в консоли появится строка shutdown Ended.
      @asynccontextmanager
async def lifespan(app: FastAPI):
    print(f"Before yield (startup)")
    yield
    await asyncio.sleep(10)
    print(f"shutdown Ended")

app = FastAPI(lifespan=lifespan)

@app.get("/")
async def root():
    await asyncio.sleep(10)
    return f"root ended"
Данное поведение является эталонным, и во Flask мы будем стремиться именно к этому.
Как проверить работу:
- Создаем тестовый эндпоинт с задержкой
await asyncio.sleep(20)и логированием до и после нее. - Из команды запуска Uvicorn убираем аргумент reload при запуске
- Поднимаем Docker-контейнер.
- Отправляем запрос к созданному эндпоинту.
- Пока запрос обрабатывается, останавливаем контейнер командой
docker stop fastapi-test --timeout=60. - Убеждаемся, что клиент успешно получил ответ со статусом 200.
- Проверяем поведение при превышении лимита: увеличиваем задержку в эндпоинте до 100 секунд и повторяем тест. В этом случае клиент должен получить ответ со статусом 500.
- После отправки команды на остановку контейнера пробуем сделать еще один запрос, чтобы проверить блокировку.. Несмотря на то, что приложение еще работает, а прошлый запрос обрабатывается, новый не должен попасть в приложение.
Flask
У нас во Flask нет встроенной подходящей функциональности, как, например, lifespan в FastAPI, поэтому приведенные ниже примеры не привязаны к конкретному фреймворку.
Пример плохого варианта:
      import logging
import signal
from db.path import dispose_db


old_handler = signal.getsignal(signal.SIGTERM)


def shutdown(signum, frame):
    if callable(old_handler):
        old_handler(signum, frame)

    logging.info("closing connections")
    dispose_db()

signal.signal(signal.SIGTERM, shutdown)
Проблема тут в том, что лог "closing connections" и закрытие соединения с БД произойдет, не дожидаясь завершения in-flight запросов.
Универсальный вариант:
      import logging
import atexit
from db.path import dispose_db


@atexit.register
def cleanup():
    logging.info("closing connections")
    dispose_db()
Проверить работу можно тем же способом, что и в FastAPI.
Настройка планировщика задач (scheduler)
В этой части не будем ничего сильно усложнять. С выполнением задач проблем возникнуть не должно, обычно они выполняются оперативно и должны завершаться в течение grace-периода..
APScheduler
Так как мы используем планировщик APScheduler, достаточно просто вызвать метод scheduler.shutdown(wait=True) в блоке finally.
      if __name__ == "__main__":
    scheduler = make_scheduler(engine=db.engine)
    try:
        scheduler.start(paused=True)
        jobs = [...]
        schedule_jobs(scheduler, jobs)
        scheduler.resume()
        while True:
            time.sleep(2)
    finally:
        scheduler.shutdown(wait=True)
Для тестирования можно использовать следующий скрипт:
      import time
from datetime import datetime

from apscheduler.schedulers.background import BackgroundScheduler

scheduler = BackgroundScheduler()


def job():
    print("Job started")
    try:
        time.sleep(20)
    finally:
        print("Job finished")


if __name__ == "__main__":
    scheduler.add_job(job, "interval", seconds=30, next_run_time=datetime.now())
    try:
        scheduler.start()
        while True:
            time.sleep(1)
    finally:
        print("Closing scheduler")
        scheduler.shutdown(wait=True)
        print("Scheduler shutdown")
Настройка обработчика задач (воркера)
Celery
В Celery graceful shutdown реализован под капотом, однако нужно обновиться до версии 5.6 и выше, чтобы избежать ошибок в ранних релизах. Drain-период можно задать параметром worker_soft_shutdown_timeout=44, а также потребуется включить флаг worker_enable_soft_shutdown_on_idle=True.
У нас, кстати, еще много интересного про Python
Dramatiq
В библиотеке dramatiq Graceful Shutdown также поддерживается по умолчанию. Закрыть соединения можно в методе before_worker_thread_shutdown класса dramatiq.Middleware. Задать жесткий тайм-аут, как в Celery, к сожалению, здесь не получится – библиотека не поддерживает такую функциональность.
Пример реализации:
      from dramatiq.middleware import Middleware, default_middleware

class ShutdownMiddleware(Middleware):
    def before_worker_thread_shutdown(self, broker, worker):
        logger.info("Started closing worker")
        database.close()
        logger.info("Ended closing worker connections")

def init_dramatiq():
    middlewares = [m() for m in [*default_middleware, ShutdownMiddleware]]
    broker = RabbitmqBroker(url=rabbitmq_uri, middleware=middlewares)
    dramatiq.set_broker(broker)
Помимо указанного метода, есть и другие, которые вам могут быть полезными:
- before_worker_shutdown — срабатывает до завершения in-flight-задач;
- after_worker_shutdown — вызывается потоком консьюмера после завершения работы воркера;
- before_consumer_thread_shutdown — как и с воркером, срабатывает перед закрытием потока консьюмера.
Без решения «из коробки»
Если ваш воркер не поддерживает graceful shutdown без установки сторонних модулей (как, например, при использовании aio-pika), можно применить тот же подход, что и во Flask. Задача сводится к следующему: перехватить системный сигнал, прекратить прием новых задач, дождаться завершения текущих в пределах drain-периода и затем закрыть все соединения, принудительно завершив оставшиеся задачи по таймауту.