Внутри компании ее прозвали «Le Chonk» — «Толстяк», или «Упитанный», из-за массивного веса модели в триллион параметров. Но благодаря архитектуре Mixture of Experts на обработку каждого токена выделяется лишь часть мощностей. Модель вышла из стадии публичного превью, получив дополнительные улучшения в программировании, агентных сценариях и информационной безопасности.
Веса доступны на Hugging Face в репозитории mistralai/Mistral-Large-4-1T-A52B без необходимости запрашивать доступ к модели. Вместе с основной версией появилась квантованная сборка NVFP4 для видеокарт NVIDIA поколения Blackwell. Mistral позиционирует релиз как очередной шаг к развитию открытой ИИ-инфраструктуры: компании и разработчики могут самостоятельно запускать модель, дорабатывать и адаптировать ее под свои нужды.
В свою очередь, Сэм Альтман, глава компании OpenAI, назвал локальные модели «ужасным распределением дефицитных ресурсов», а железо должно работать в дата-центрах, а не в простаивать в ПК. Mistral — главный европейский разработчик фундаментальных моделей и единственный игрок из ЕС, который конкурирует и взаимодействует с американскими и китайскими лабораториями.
Что поменялось с момента превью
Впервые модель показали 6 октября — тогда она была доступна только через API в статусе превью. В The Register в тот же день написали, что веса обещают выпустить «в течение месяца», и обещание компания сдержала. За три недели Mistral дообучила модель с подкреплением и прогнала ее через тесты у клиентов. По словам вице-президента Mistral по науке Пьера Стока, RL шел на собственных мощностях компании во Франции, потреблявших около 10 МВт. Базовое обучение заняло около двух месяцев на ~3 800 GPU NVIDIA Grace Blackwell в европейских дата-центрах.
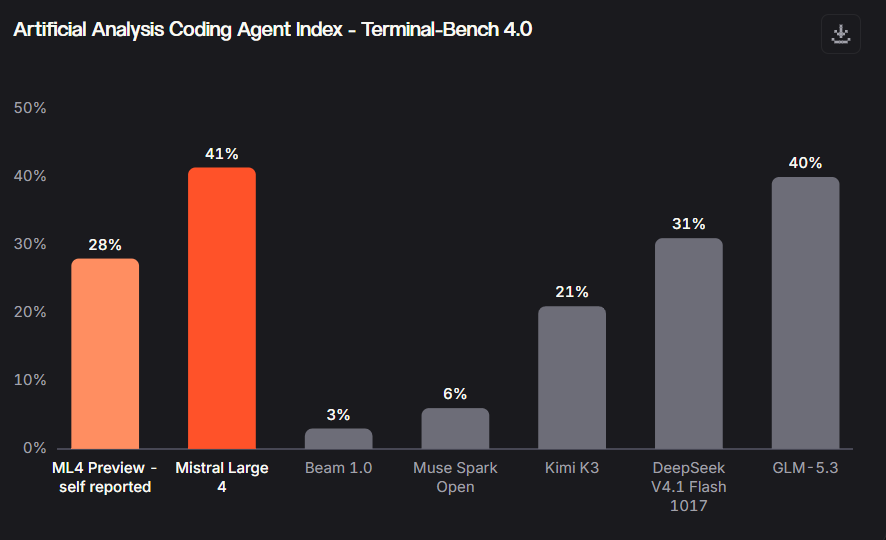
Эффект от этих трех недель хорошо видно на агентных бенчмарках. На Terminal-Bench 4.0 результат вырос с 28% до 41%, при этом выходных токенов стало на 30% меньше. На BrowseComp модель набирает 84,5% против 75% у SFT-чекпоинта. Добавились режимы рассуждения low и medium вместо единственного high. Их, судя по всему, просили клиенты, которым надоело платить за долгое «обдумывание» простых задач.
Архитектура по карточке модели — 128 маршрутизируемых экспертов, из них четыре активны на токен, плюс один общий. Активных параметров около 49 млрд, а с эмбеддингом и выходным слоев выходит 52 млрд — отсюда получается цифра в названии репозитория. Контекст — 1 млн токенов, на вход принимаются текст и изображения через энкодер в духе Pixtral.
Конкуренция с рынком открытых весов
С оговоркой. Все цифры приведены самой Mistral. Независимо подтверждено только то, что идет через индексы Artificial Analysis, но и эти результаты опубликованы в анонсе компании.
В кодинге отрыв от GLM составляет один пункт, что не сделает фурора:
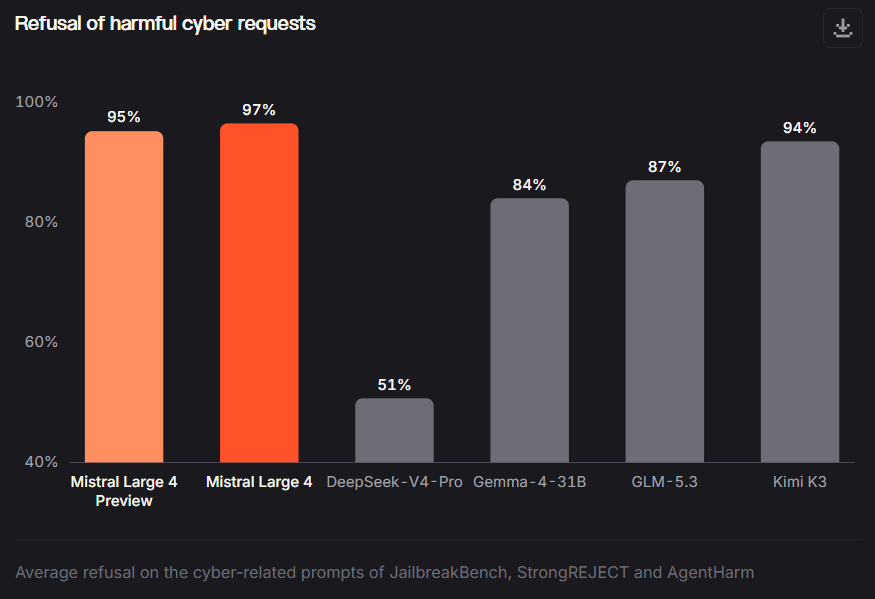
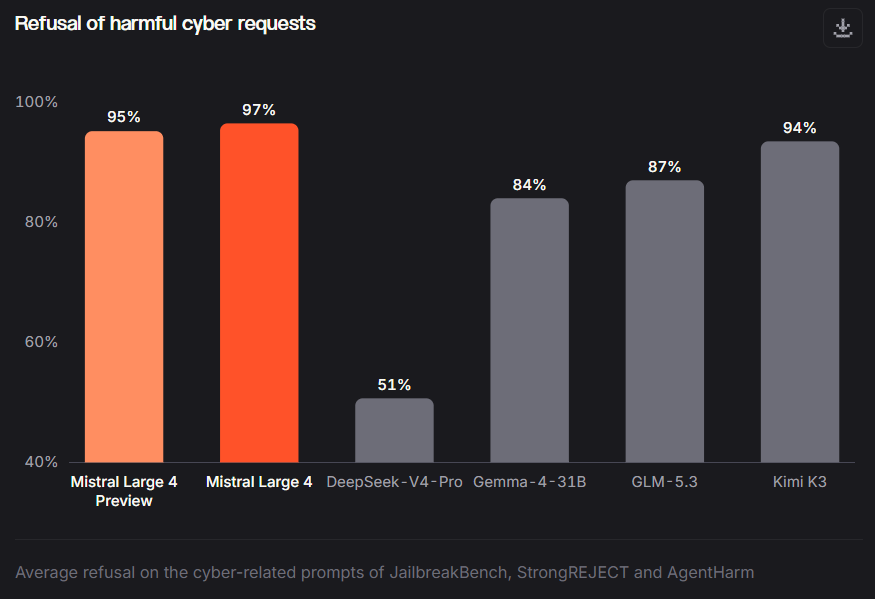
В анонсе важно другое — защищенность модели. Это отдельно выделяет компания, заявив, что Mistral Large 4 отклоняет 96,6% вредоносных запросов и выдерживает 97% атак в бенчмарке B3 Agent Security.
Большим плюсом также выступает расход токенов: ML4 расходует на 47% меньше токенов на задачу, чем GLM-5.3 при чуть меньшей точности ответа. Для self-hosting модели это вопрос экономически важный, ведь каждая сэкономленная половина токенов позволяет экономить «дефицитный ресурс» — время GPU под новые задачи.
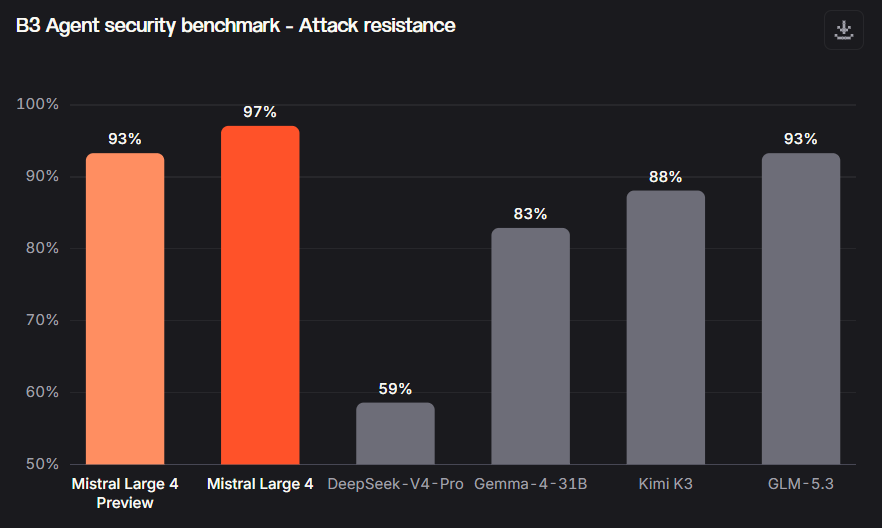
В итоге мы получаем защищенную экономичную модель, отстающую на одну ступень от китайских конкурентов. Особенно грустно, что в примерах мы не видим знакомые нам «поделки» американских товарищей, но это неудивительно.
Триллион параметров. Под какие мощности это рассчитано
За внушительным триллионом параметров стоит архитектура MoE. Это позволяет активировать всего около 49 млрд параметров и не задействовать всю модель целиком при каждом вычислении.
В предварительном релизе Mistral сообщали, что Large 4 обучали на 3 800 ускорителях NVIDIA Grace Blackwell в собственных дата-центрах. Но мало у кого из читающих эту новость есть свой дата-центр. Для самостоятельного запуска на версии FP8 понадобится около 1 ТБ дискового пространства, а вариант NVFP4 займет около 610 ГБ, и то с оговоркой — нужны GPU поколения Blackwell.
Иными словами, открытые веса не говорят о доступности модели для любого желающего. «Le Chonk» даже своим названием говорит, что он съест всю вашу память.
Лицензия, но с оговоркой
Веса распределяются по Mistral Ecosystem Open-Weight License — модифицированной версии MIT. Она разрешает использовать модель, дообучать ее и применять в бизнесе. Но для предоставления доступа по формату Model-as-a-Service необходимо получить коммерческую лицензию от Mistral.
Выходит, что рынок порешал и тут: чтобы самостоятельно развернуть модель, необходимы большие мощности, а если захотите построить на основе модели продукт — договаривайтесь с Mistral.
Что в итоге
Mistral Large 4 — попытка заявить о себе со стороны европейских разработчиков моделей. Компания хочет показать, что способна конкурировать с ведущими китайскими и американскими лабораториями в агентном программировании и безопасности моделей. GLM-5.3 по сравнению с «Le Chonk» потребляет в два раза больше токенов при чуть большей эффективности, что заставит китайцев задуматься над оптимизацией потребления токенов при сохранении эффективности модели.
Ограничения у модели все же есть — ее вес и лицензия от Mistral, которые не позволят свободно развернуть и коммерциализировать модель большому количеству пользователей.