В SOC значительная часть нагрузки L1-аналитика — разбор однотипных инцидентов, которые в итоге оказываются ложными срабатываниями. При этом каждый алерт нужно проверить, обогатить контекстом и задокументировать. Результат — много ручной работы, которая отнимает время от более сложных задач и повышает риск ошибки из-за усталости.
Особенно остро эта проблема стоит в командах ИБ, которые одновременно занимаются инфраструктурой, клиентскими задачами и другими проектами. Можно ли автоматизировать первичный разбор, не отдавая данные во внешнюю LLM и не превращая внедрение в многомесячный проект по файнтюнингу?
Мы попробовали это сделать с помощью локальной LLM, RAG и второго прохода с валидатором. В статье покажу, как устроен этот процесс, почему мы выбрали RAG вместо файнтюнинга и какие проблемы обнаружили уже после внедрения.
Как мы жили до внедрения LLM
Представьте картину: L1-аналитик SOC получает инцидент, читает и анализирует события в SIEM (Security Information and Event Management, система управления ИБ), ищет CVE, проверяет во внутренней документации адреса и хосты, пишет разбор по шаблону. Далее ему нужно принять решение: закрыть инцидент как FP (False Positive) или эскалировать на L2.
У нас таких инцидентов приходило около 100 в месяц, примерно 80% из них оказывались ложными срабатываниями. Но даже очевидный FP нужно было проверить и задокументировать. На полный разбор инцидента уходило до двух рабочих дней. Такие затраты времени были особенно заметны на фоне остальной работы команды: помимо разбора инцидентов, мы занимались настройкой и администрированием оборудования, коммуникацией с клиентами и разработкой различных решений.
При подобном потоке рутины стоит учитывать и человеческий фактор: после двадцатого похожего алерта за час можно ошибиться с принятием решения, так как наступает усталость от разбора инцидентов.
Так и появилась цель — освободить аналитика от рутинного разбора. Не заменить его нейросетью, а делегировать ей первичный анализ, обогащение данных и подготовку решения, чтобы человек получил готовый разбор в Telegram, а не сырой JSON из SIEM.
Из чего состоит наш SOC
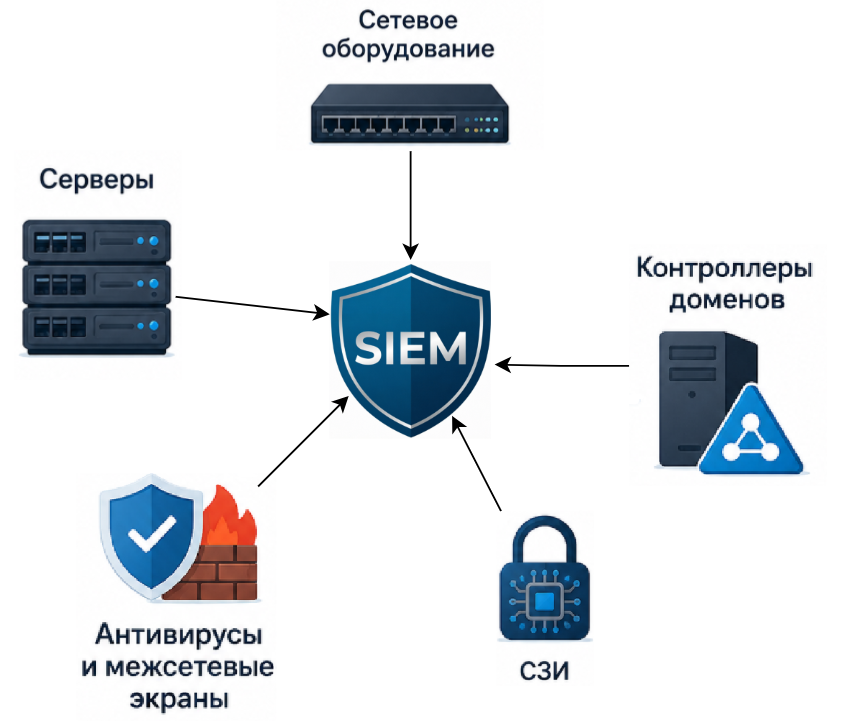
Прежде чем переходить к автоматизации, расскажу о нашем SOC. Под ним подразумевается SIEM-система, в которую с части наших служебных и клиентских систем стекаются логи:
- сетевого оборудования;
- серверов и контроллеров доменов;
- антивирусов и межсетевых экранов;
- средств защиты информации (СЗИ), в том числе при несанкционированном доступе и событиях криптографии.
SIEM коррелирует события по заданным правилам и создает инциденты.
Как мы выбирали модель
При выборе LLM было одно важное условие: согласно внутренней ИБ-политике, мы не можем передавать информацию во внешние сервисы. Это требование сразу отсекло облачные LLM-сервисы независимо от их условий обработки данных. Трафик наружу в нашем контуре недопустим, так что речь даже не о доверии к вендору.
В Selectel есть несколько моделей, развернутых локально. В шорт-лист попали две: Qwen 3.6-27B и GLM-5.1, которую мы затем заменили на более свежую GLM-5.2.
| Модель | Чем не устроила | Выводы |
| ChatGPT | Не предполагается локального исполнения, чего требует наш закрытый контекст. | Отказались на начальном этапе: не соответствует требованиям безопасности. |
| Qwen 3.6-27B | Теряет фокус на разборе длинных инцидентов, галлюцинирует. | Не обеспечила нужной стабильности при расследовании длинно-контекстных инцидентов. |
| GLM-5.1 / 5.2 | Тяжеловесная, отвечает медленнее остальных. | Высокая точность, приемлемое качество на длинном контексте, открытая архитектура. |
Также проверили бенчмарки для понимания способностей моделей.
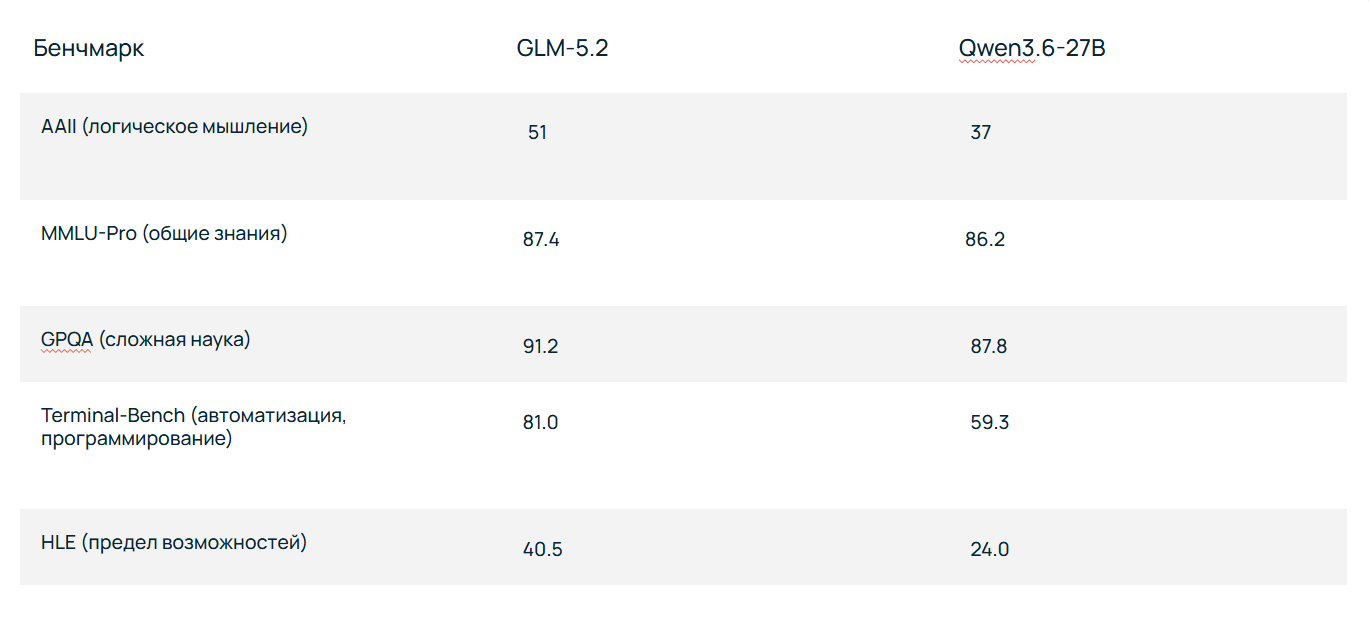
Почему GLM лучше Qwen
Я прогнал набор инцидентов через обе модели и составил сравнительную таблицу:
| Метрика | Qwen 3.6 27B | GLM-5.2 |
| Accuracy | 48,5% | 67,6% |
| Error Rate | 32,5% | 24,4% |
| Miss Rate | 12,5% | 7,1% |
| False Escalation | 9,1% | 4% |
| Mean Confluence | 0,42% | 0,62% |
| Mean Agreement | 0,7% | 0,92% |
Разница заметна, но не критична. Ключевая метрика здесь — False Escalation, эскалация ложного инцидента на L2 (Level 2, углубленный анализ). Лишние задачи и ложные отчеты по инцидентам никому не нужны, а GLM куда точнее по этому критерию, да и по всем остальным превзошла конкурента.
Я прогонял набор «золотых инцидентов» с известным решением, по которым и проверял, что модель вообще способна дать осмысленный и похожий на человеческий ответ.
RAG или файнтюнинг
Удобно убрать лишние слои из модели, дообучить ее на H100 и эффективно закрывать инциденты. Но тут есть несколько нюансов.
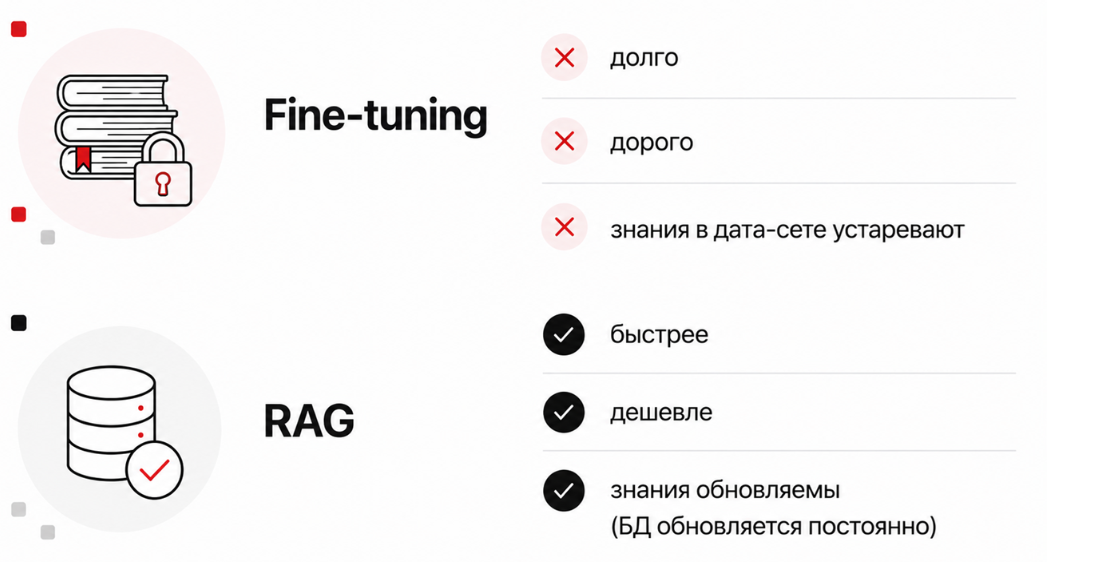
- У нас нет огромного датасета. Для файнтюнинга нужны тысячи размеченных примеров формата «как делать надо». Времени на разметку датасета, как и двух тысяч инцидентов, не было.
- Времени на дообучение модели тоже не было. При каждом обновлении документации пришлось бы заново размечать и готовить данные, да еще и выделять GPU для дообучения — все это долго и дорого.
- Хотелось сделать быстро и эффективно. RAG позволяет собрать данные из внутренней документации, которая содержит информацию по хостам, доменам и инфраструктуре. Модель получает только нужную информацию и на ее основе принимает решение.
Полнотекстовый поиск вместо векторного — это осознанный выбор на старте. Данные собираются по небольшому спейсу, а в будущем планируется подключение еще одной ИИ с семантическим поиском.
Почему n8n
Как оркестратор был выбран n8n. Он развернут локально, данные не покидают сеть. У него удобный визуальный воркфлоу, и новичку легко втянуться и понять суть. Продуманные интеграции облегчают жизнь — все запросы выполняются через стандартные ноды. Настроить автоматизацию легко и удобно.
Обработка инцидента по шагам
Теперь взглянем на общую схему нашего решения. Если вкратце, то в SIEM стекаются логи со всех систем. Далее по заранее заданным корреляционным правилам события связываются в единые инциденты, которые и отправляются в n8n.
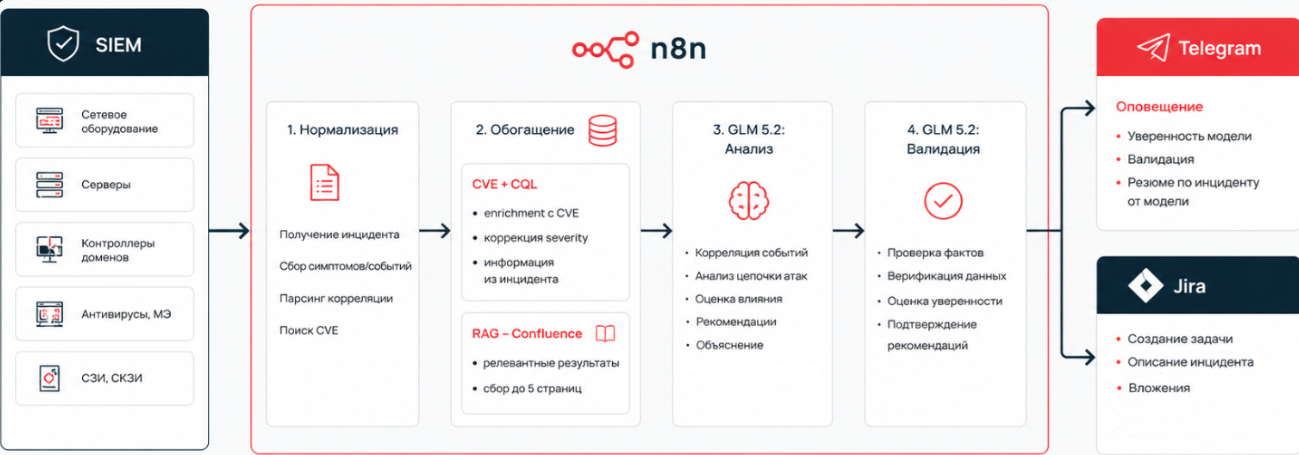
Шаг 1. Сырой инцидент
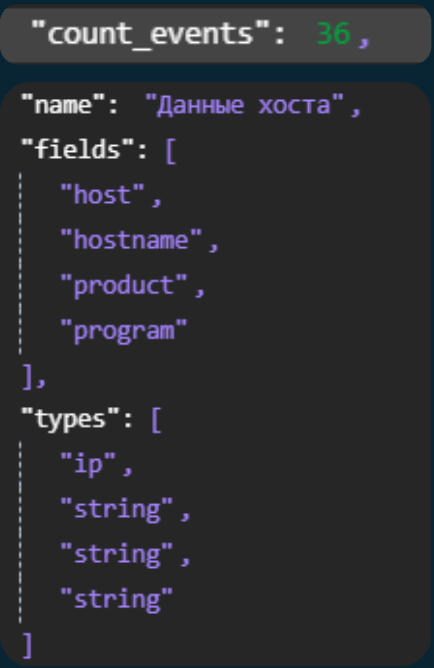
Инцидент из SIEM приходит как JSON и его структура сильно варьируется:
- событий может быть 3 или 200 — заранее неизвестно;
- поля приходят как
null, как пустая строка или какundefined; src.ip— иногда строка, а иногда и массив;- есть лишние поля, которые модели не нужны.
Корреляция содержит symptoms, tags, correlation.description, raw_event с полным JSON события. Если отдать все это модели как есть, она утонет в контексте и потеряется в 200 строках лишней информации.
Шаг 2. Нормализация
Неструктурированный JSON необходимо привести к нормализованному виду. С этой задачей справляется специальный скрипт.
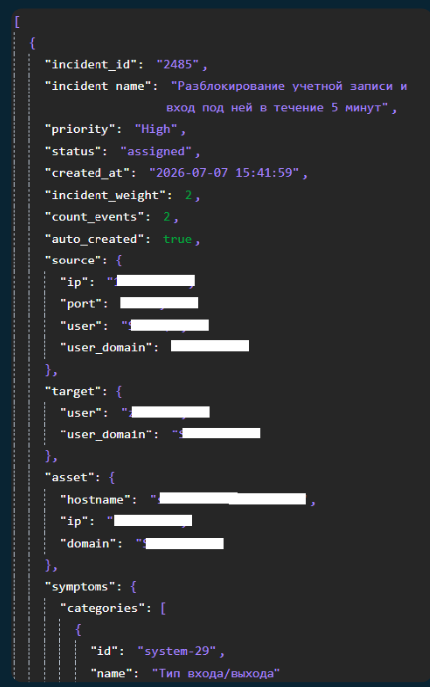
Структура данных должна быть предсказуемой, ведь модель ожидает единообразный JSON.
Шаг 3. Обогащение через OSV API
Если indicators.cve не пустой — выполняем запрос к OSV (Open Source Vulnerability, открытая база уязвимостей, созданная и поддерживаемая Google). В результате получаем следующую информацию:
- оценку (score), критичность (severity) и вектор атаки (vector) из CVSS (Common Vulnerability Scoring System, балльная оценка опасности уязвимости);
- идентификатор уязвимости по реестру CVE;
- информацию о публичной доступности эксплойта;
- ссылки на подробности и бюллетени безопасности.
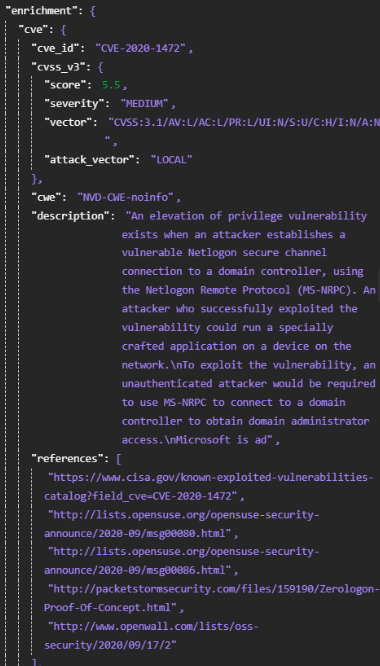
Поскольку данные подтягиваются из внешних систем еще до вызова модели, та оперирует готовыми фактами и не придумывает метрики.
Шаг 4. Сбор CQL для Confluence
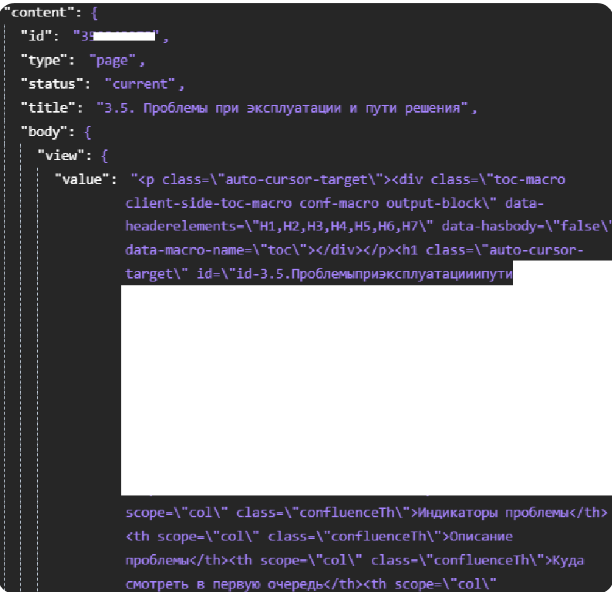
Из нормализованных полей строится запрос на языке CQL (Confluence Query Language). Информацию по hostname, ip, CVE, user ищем в спейсах отделов в Confluence.
Шаг 5. RAG обработка + промпт
Чтобы не забивать контекст модели, чистим HTML и вырезаем релевантные куски, которые нужны для анализа инцидента. Так мы получаем обработанный RAG.
Перед вызовом модели задаем промпты:
- User prompt — собранная информация и RAG по инциденту;
- System prompt — жесткие правила, чтобы модель не выходила за рамки L1.
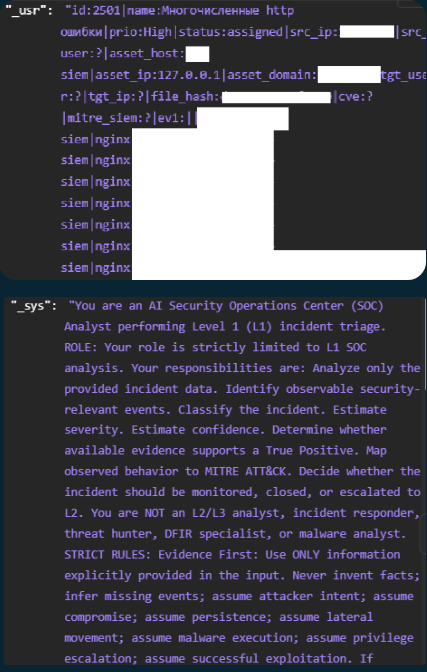
Шаг 6. Анализ инцидента
Системный и пользовательский промпты склеиваются в один запрос.
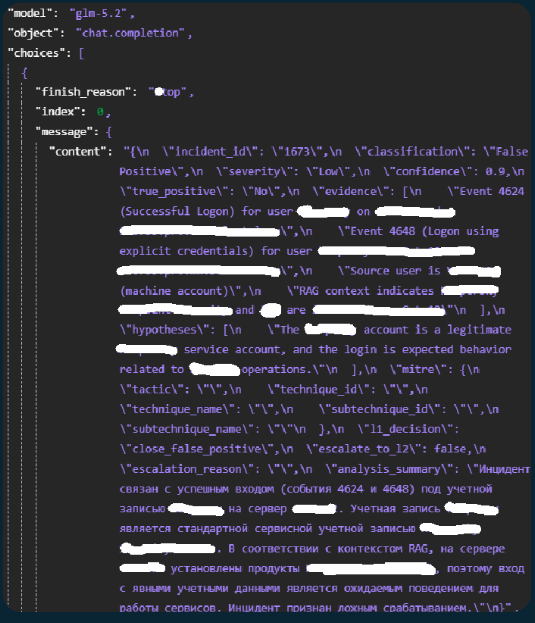
На выходе отдается JSON с нужными полями: classification, severity, confidence, l1_decision.
Шаг 7. Валидация ответа
Результат анализа передаем валидатору. Он получает только нужную информацию — классификацию, severity, confidence, решение L1, — и далее проверяет их на противоречия.
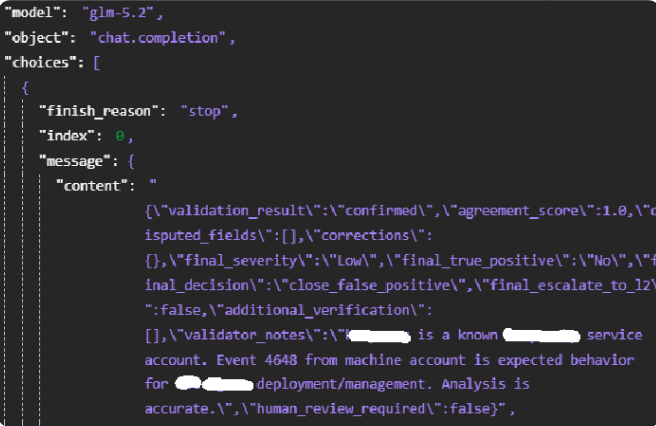
Валидатор — вторая пара глаз, которая соглашается или не соглашается с выводами первой модели.
      if (v.validation_result === "confirmed") {
    // Валидатор согласен с решением модели, ничего не меняем
    finalResult = {
        final_severity: l1.severity, // значение от L1
        final_true_positive: l1.true_positive, // значение от L1
        final_decision: l1.l1_decision, // решение от L1
        final_escalate_to_l2: l1.escalate_to_l2 || false,
        validation_status: "confirmed",
        agreement_score: v.agreement_score,
        human_review_required: false
    };
} else if (v.validation_result === "corrected") {
    // Валидатор не согласен с решением модели — учитываем его правки
    finalResult = {
        classification: (v.corrections && v.corrections.classification) || l1.classification,
        final_severity: v.final_severity, // значение от валидатора
        final_true_positive: v.final_true_positive, // значение от валидатора
        final_decision: v.final_decision, // решение валидатора
        final_escalate_to_l2: v.final_escalate_to_l2,
        validation_status: "corrected",
        agreement_score: v.agreement_score,
        human_review_required: false
    };
} else {
    // disputed / insufficient — ручная проверка человеком
    finalResult = {
        final_decision: "insufficient_data",
        validation_status: v.validation_result,
        agreement_score: v.agreement_score,
        human_review_required: true,
        disputed_fields: v.disputed_fields,
        validator_notes: v.validator_notes
    };
}
Валидатор возвращает два ключевых параметра:
validation_result— статус проверки: подтверждение исходного решения (confirmed), исправление его (corrected), признание спорным (disputed) или нехватка данных (insufficient).agreement_score— число от 0 до 1, которое показывает степень согласия валидатора с результатами первичного анализа.
Если agreement_score ≥ 0,8 — результат подтвержден, идем по решению L1 от модели (но проверяем это решение по-человечески, просто без исследования инцидента), в противном случае — валидатор поправил. Если validation_result принимает значение disputed или insufficient — инцидент уходит на ручную проверку человеком.
Шаг 8. Финальное решение
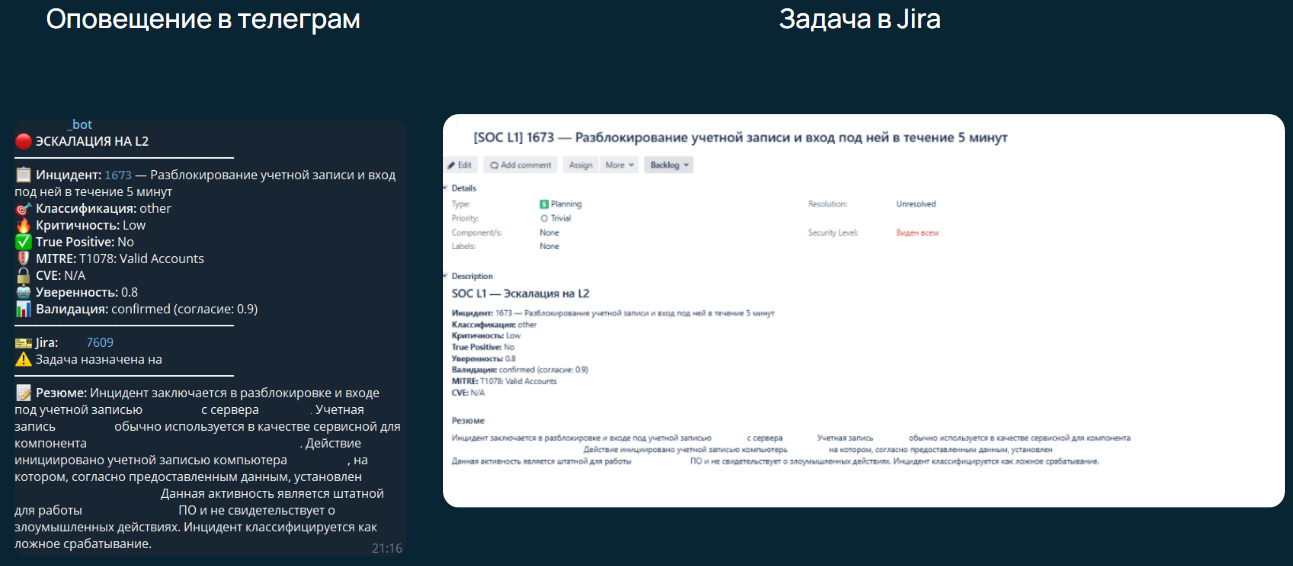
По результатам анализа и валидации формируется итог с полем action_type:
close_fp— инцидент закрывается как ложный;escalate_l2— эскалация до L2, с заведением задачи и оповещением в Telegram;monitor— помечаем инцидент как мониторящийся;human_review— отправляем на разбор человеком (могло не хватить информации для принятия решения).
Аналитик открывает Telegram и видит заключение по инциденту.
Как это работает на практике
Мы записали небольшое видео, чтобы наглядно показать весь процесс обработки инцидента.
Здесь инцидент обогащается информацией из OSV API и Confluence, а затем на этапе принятия решения демонстрируются две ветки развития: когда нейросеть уверена, а также когда она сомневается и создает задачу на разбор инцидента живым аналитиком.
Типовые ошибки при внедрении
Ошибки у нас тоже были, так что если вы решите реализовать предоставленную в статье схему, предусмотрите несколько важных моментов.
- Markdown-разметка в ответах. Нейросеть часто возвращает результат не в виде чистого текста, а оборачивает его в Markdown-блоки с тегами JSON и обратными кавычками. Если передать такую строку напрямую в JSON.parse, скрипт выдаст ошибку. Проблема легко решается с помощью регулярных выражений. Перед парсингом необходимо вырезать из ответа лишние символы, оставляя только чистый код.
- 502 от API при последовательных вызовах. GLM — тяжелая модель, а два последовательных запроса без паузы могут вызвать ошибку 502. Решить проблему можно либо вызовом двух разных моделей, либо задержкой перед вторым запросом.
- Захламление контекста. Длинные инциденты забивают память модели, и она теряет фокус. Проблема решается фильтрацией лишней информации: нормализацией, точечными обогащениями, очисткой обертки и «шелухи», которая модели не нужна.
Итоги и планы
LLM в контуре SOC — это освобождение сотрудника от части рутины. Связка промт‑инжиниринга, валидации и RAG — это проще, быстрее и эффективнее, чем файнтюнинг. При этом защита от галлюцинаций, достигаемая за счет жесткого промпта и логических проверок, делает систему управляемой.
Около 80% инцидентов закрываются практически без участия аналитика, но обязательно под его присмотром. Помимо прочего, время на разбор тех инцидентов, которые требуют внимания, заметно сократилось, так как аналитик получает готовый анализ, а не сырой JSON.
Сейчас есть идеи, как улучшить решение:
- перейти с полнотекстового CQL на семантический поиск по Confluence через внутреннюю ИИ, чтобы контекст стал релевантнее по смыслу, а не по строковому совпадению;
- протестировать валидатор на независимой второй модели по типу Qwen;
- проработать документирование разбора инцидента аналитиком, чтобы переиспользовать информацию в промптах и обогащать RAG-документацию;
- изменить канал оповещения, заменив Telegram внутренним мессенджером.