Microsoft анонсировала следующее поколение специализированных ускорителей для машинного обучения — Azure® Maia 300. В отличие от универсальных графических процессоров, проект Maia позиционируется как XPU, сфокусированный на ускорении инференса LLM и генеративных сервисов.
Инференс все больше смещается в сторону агентских сценариев, требующих многоступенчатого выполнения задач, длинноконтекстного декодирования и постоянного обращения к «внешним» инструментам. Чтобы эффективно обрабатывать такие алгоритмы, был сделан упор на устранение узкого места — пропускной способности памяти и задержек при передаче данных.
Архитектура
Maia 300 построен по мультичиплетной компоновке, где вычислительные ядра производятся по техпроцессу TSMC N2P. Архитектурно чип разделен на изолированные домены вычислений, контроллеров памяти и физических интерфейсов ввода-вывода.
В основе Maia 300 лежит архитектура SDLA с программным управлением потоками данных. Она позволяет размещать данные максимально близко к использующим их вычислительным блокам и явно управлять передачей между памятью, вычислительными движками и сетью. Переход к NUMA-топологии между чиплетами помогает сократить нецелевые перемещения данных и связанные с ними энергозатраты.
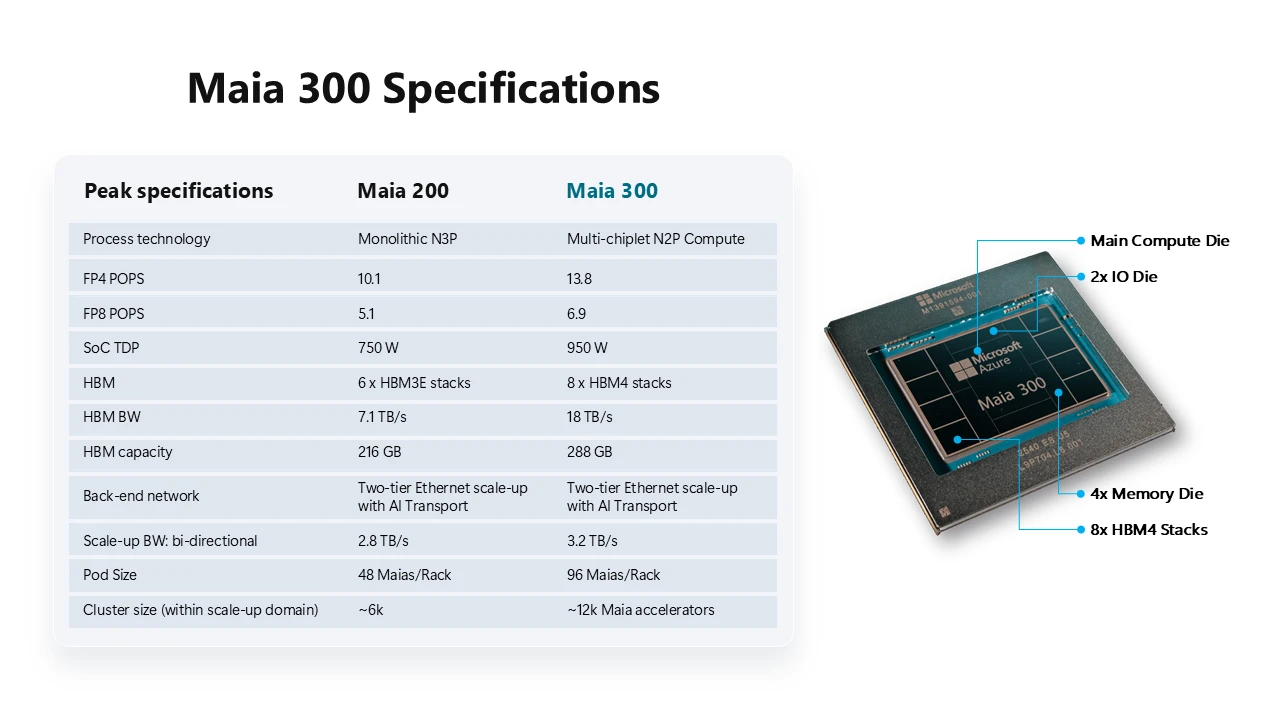
Используются восемь стеков HBM4 суммарным объемом 288 ГБ. Пиковая пропускная способность памяти достигает 18 ТБ/с на один ускоритель. По сравнению с прошлым поколением Maia 200 новинка демонстрирует рост ПСП в 2,5 раза, увеличение объема памяти на 33% и двукратное повышение эффективности HBM в расчете на Ватт при общем теплопакете чипа в 950 Вт.
Для оптимизации инференса реализована поддержка форматов пониженной точности, включая улучшенный MXFP4 и «суб-3-битные» форматы хранения: более компактные представления данных сокращают объем занимаемой памяти и интенсивность ее «пересылок». Это позволяет более оптимально удерживать контекст и KV-кэш больших моделей, а также обслуживать больше параллельных сессий в рамках такого же энергопотребления.
Стойки и узлы
Microsoft отказалась от концепции раздельных процессорных хост-узлов и отдельной платы ускорителей. Вместо этого инженеры применили объединенную архитектуру вычислительных блоков. Один блок содержит четыре ускорителя Maia 300, скомпонованных с хост-процессором, оперативной памятью, накопителями и компонентами жидкостного охлаждения.
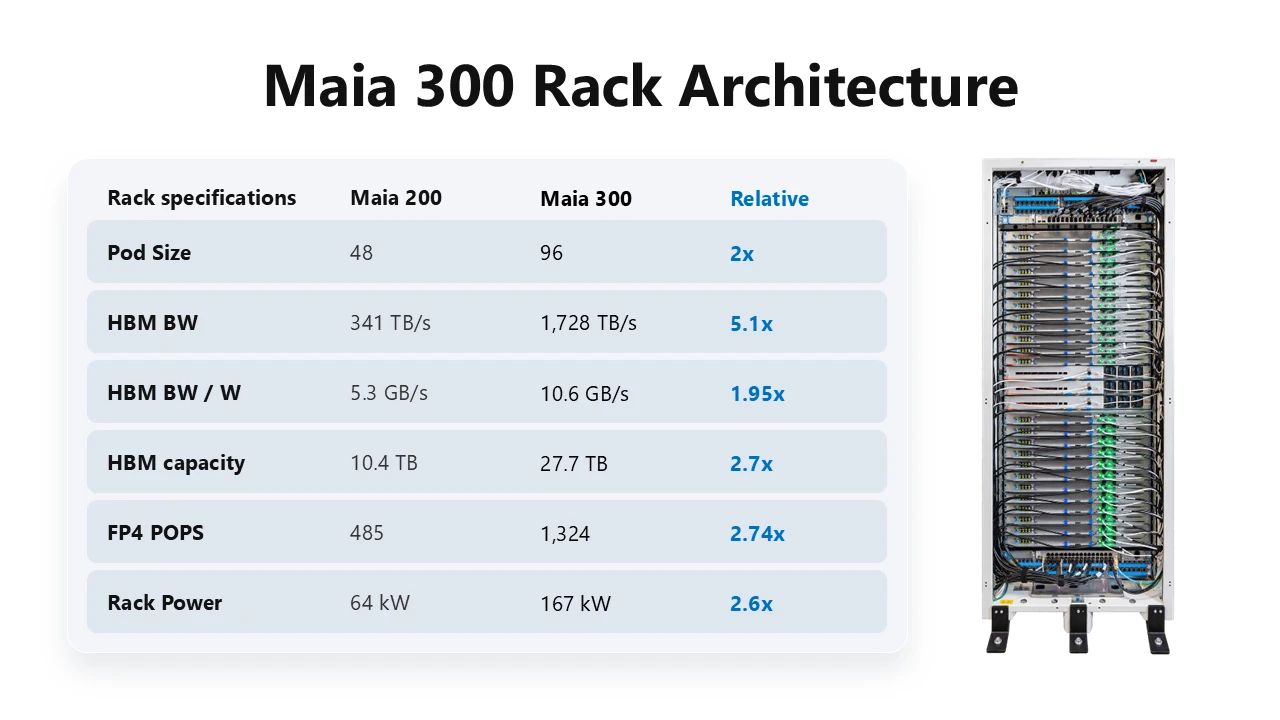
Полная серверная стойка включает 24 таких блока, что в сумме дает 96 ускорителей Maia 300 и 27,6 ТБ памяти HBM4 с общим энергопотреблением около 167 кВт. Коммутация внутри стойки обеспечивается шестью ASIC-коммутаторами, размещенными в трех блоках жидкостного охлаждения. Система поддерживает как прямое подключение к жидкостному контуру ЦОД, так и работу через промежуточные теплообменники вода-воздух для быстрой интеграции в существующую инфраструктуру.
Масштабирование до суперпода
Сетевая архитектура продолжает подход SDLA за пределами отдельного ускорителя. Вместо изоляции доменов scale-up и scale-out используется единая двухуровневая сеть на базе Ethernet, обеспечивающая взаимодействие как внутри стойки, так и между стойками суперпода.
На первом уровне внутри стойки используются медные соединения. Каждая пара чипов внутри блока имеет прямые связи, а остальная коммутация стойки организована по полукоммутируемой топологии, что снижает накладные расходы и энергопотребление. На втором уровне происходит объединение до 128 стоек с помощью оптических коммутаторов второго уровня в единый суперпод, включающий до 12 288 ускорителей Maia 300.
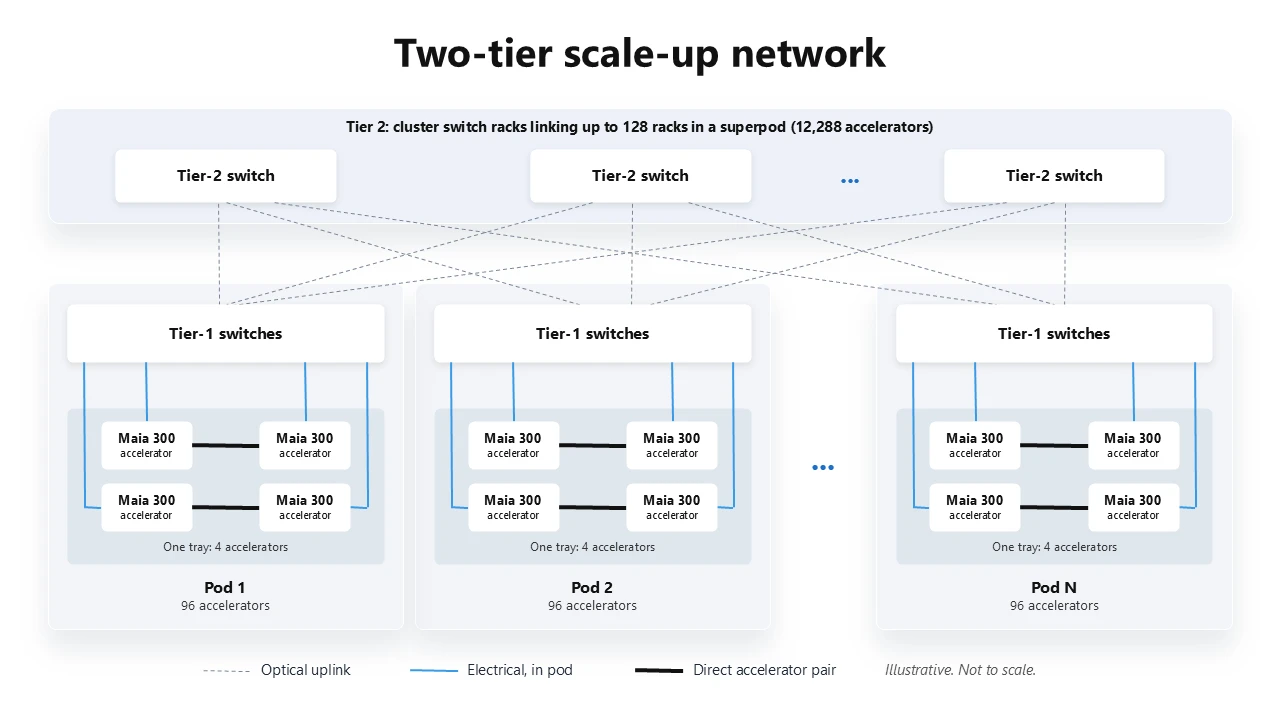
Гибкая архитектура сети позволяет перераспределять полосу пропускания до 750 ГБ/с между любыми чипами в суперподе. Это дает возможность удерживать трафик тензорного параллелизма внутри одной стойки на 96 ускорителей с минимальной задержкой, а параллелизм экспертов и конвейерный параллелизм распределять по всему суперподу без риска простоя вычислительных блоков.
Что в итоге
По расчетам Microsoft, на уровне стойки Maia 300 дает семикратный прирост пропускной способности генерируемых токенов по сравнению с Maia 200 и обеспечивает на 40% больше токенов на мегаватт мощности по сравнению с традиционными GPU-решениями.
Развертывание Maia 300 в промышленной инфраструктуре Azure намечено на 2027 год. Новые чипы станут базовой платформой для обработки инференса в сервисах Microsoft Copilot, Teams, GitHub Copilot и других внутренних системах обработки естественного языка.