У нас есть курьер, у него есть 20 адресов и склад. Задача — объехать всех и вернуться, потратив как можно меньше времени. Количество вариантов объезда будет немногим больше 60 квадриллионов (а если точнее, то 60 822 550 204 416 000). Для сравнения: столько секунд прошло бы за два миллиарда лет. И это так называемая задача коммивояжера.
Почему нельзя просто взять и перебрать
Первая мысль у любого нормального человека: ну так а в чем проблема? Нужно лишь посмотреть все варианты и выбрать короткий. Компьютер быстрый, пусть считает.
Проблема в том, как растут эти «все варианты». Маршрут — это порядок объезда, то есть перестановка точек. Из одной точки мы стартуем, направление объезда не важно, поэтому вариантов получается (n−1)!/2.
Посмотрим лесенку сложности:
- 5 точек — 12 вариантов;
- 8 точек — 2 520 вариантов;
- 10 точек — 181 440 вариантов;
- 12 точек — 19 958 400 вариантов;
- 15 точек — 43 589 145 600 вариантов;
- 17 точек — 10 461 394 944 000 вариантов;
- 20 точек — 60 822 550 204 416 000 вариантов.
Вариантов объезда 20 точек в 335 млрд раз больше, чем если бы их было 10. А ведь мы просто добавили 10 адресов. Это и называется комбинаторный взрыв: линейно растет условие, факториально растет перебор.
Но тут важный момент: «задача трудная» и «задачу невозможно решить» — не одно и то же. Курьерские приложения ведь как-то работают, и работают неплохо.
Дело в том, что перебор задачи — это отказ ее решать, замаскированный под грубую силу. Нормальный алгоритм не смотрит все варианты, а лишь доказывает, что большинство смотреть не надо.
Вот например, я взял два алгоритма и протестировал их на одном ноутбуке:
- Первый — прямой перебор: сгенерировать все маршруты, посчитать длину каждого, выбрать минимум.
- Второй — алгоритм Хелда-Карпа. Он тоже дает точный ответ, тоже гарантированно оптимальный, но запоминает промежуточные результаты.
Если он уже выяснил, как дешевле всего пройти через точки {A, B, C} и закончить в C, то для всех маршрутов, начинающихся с этой тройки, он больше не пересчитывает ее заново.
| n | Перебор в лоб | Хелд-Карп | Во сколько раз |
| 8 | 0,004 с ± 0.000 (n=6) | 0,0007 с ± 0.0005 (n=6) | ×6 |
| 9 | 0,037 с ± 0.001 (n=6) | 0,0012 с ± 0.0001 (n=6) | ×32 |
| 10 | 0,345 с ± 0.003 (n=5) | 0,0030 с ± 0.0001 (n=5) | ×115 |
| 11 | 3,704 с ± 0.078 (n=3) | 0,0071 с ± 0.0002 (n=5) | ×520 |
| 12 | 42,367 с ± 0.347 (n=2) | 0,0172 с ± 0.0007 (n=5) | ×2466 |
Слева время в секундах, ± разброс между запусками, n — сколько раз гонял. Оба на голом Python, в один поток.
Для 12 точек прямому перебору потребовалось 42 секунды, а алгоритму Хелда — Карпа — всего 17 миллисекунд. Разница в 2 500 раз, и она растет с каждой точкой. Оба алгоритма дают один и тот же точный ответ. Просто первый смотрит 20 млн маршрутов, а второй — не смотрит.
Призываю дорогого читателя запомнить эту таблицу, она пригодится в конце.
Идея, которая напрашивается
И вот тут возникает соблазн, из которого выросла целая область. Перебор прямолинеен, зато он идеально параллелится. Каждый маршрут можно проверять независимо от остальных, они друг о друге ничего не знают. Если бы у нас был миллиард процессоров, перебор бы внезапно стал ничего так.
А где взять миллиард процессоров? Они уже рядом с вами. В миллилитре воды из лужи живет примерно миллиард бактерий. Они бесплатные, они сами себя копируют каждые 20 минут, и с каждым делением процессоров становится вдвое больше. Звучит интригующе, и в 2009 году это попробовали.
И отдельно скажу: работа, которую я разбираю, хорошая, аккуратная и все ограничения в ней написаны прямым текстом. Претензия, скорее, не к ней, а к слою пересказов, который из нее вырос, — там обычно остается только «бактерии решили NP-полную задачу», а все интересное отваливается.
Как из бактерии сделать вычислитель
Статья о которой пойдет речь: Baumgardner et al., «Solving a Hamiltonian Path Problem with a bacterial computer», Journal of Biological Engineering, 2009. Ее делали студенты-бакалавры в рамках iGEM, и для студенческой работы это сделано очень круто.
Чтобы дальше было понятно, надо договориться о четырех вводных для вхождения в курс дела. Ну а если вы и так в теме — переходите к следующему разделу.
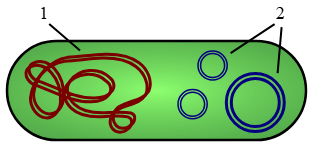
Плазмида. Бактерии, помимо основной хромосомы, содержат в себе маленькие кольцевые молекулы ДНК. Это что-то вроде флешки: вставляется отдельно, копируется отдельно, и в одну клетку их влезает под сотню штук. Именно в плазмиду синтетические биологи и пишут свой код.
Ген и флуоресцентный белок. Ген — это участок ДНК, по которому клетка синтезирует конкретный белок. Есть готовые гены, кодирующие белки, которые светятся: GFP — зеленым, RFP — красным. Их используют как индикаторную лампочку: собрался ген целиком — колония светится, не собрался — не светится. Если работают оба сразу, красный плюс зеленый дают желтый.
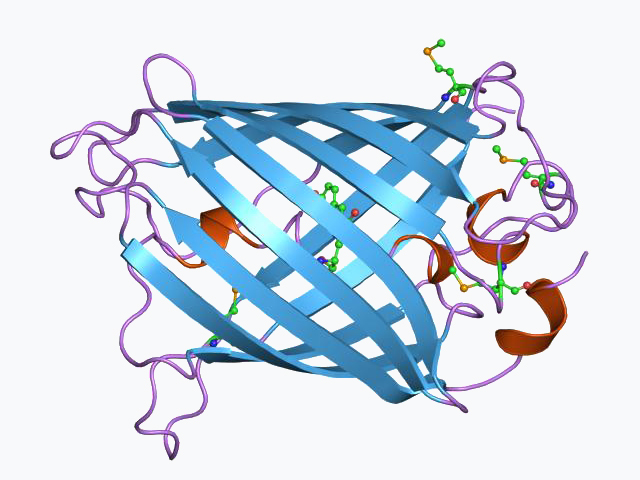
Hin-рекомбиназа и сайты hixC. Hin — это фермент, заимствованный у сальмонеллы. Он умеет находить в ДНК пару специальных меток (они называются hixC) и переворачивать кусок между ними задом наперед. Вслепую, туда-сюда, пока фермент в клетке есть. Представьте кусок текста между двумя закладками, который сам себя периодически разворачивает, вот это и оно.
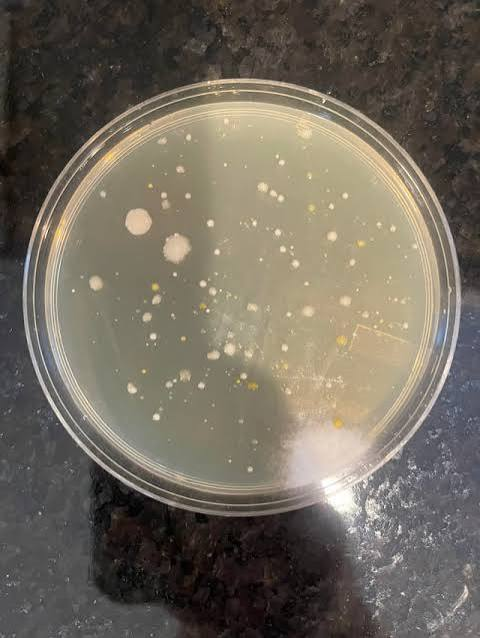
Колония. Если размазать бактерий по питательной среде в чашке достаточно редко, каждая отдельная клетка вырастет в отдельное пятнышко из миллионов своих потомков — все с одной и той же плазмидой. Кстати, это можно увидеть глазом.
Из этих четырех поинтов и собирается вычислитель.
Что же сделали
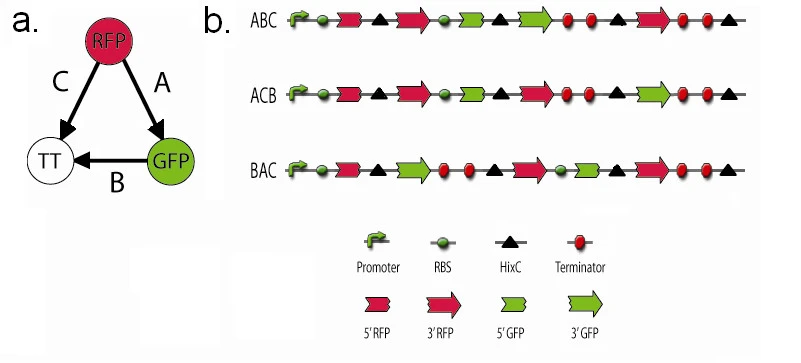
Ребра графа (дороги между городами) кодируются кусками ДНК, зажатыми между метками hixC. Hin их непрерывно тасует — меняет порядок и ориентацию.
Узлы графа (города) кодируются генами светящихся белков, разрезанными пополам. Ребро, входящее в узел, несет первую половину гена. Ребро, выходящее из узла — вторую. Поодиночке половинки не светятся, это авторы проверили отдельно.
И вот если ребра случайно встали в правильном порядке и в правильной ориентации, половинки состыковались, гены собрались целиком — колония светится. Заметьте, бактерия ничего не вычисляет, она тасует карты. А правильная комбинация сама себя подсвечивает.
Граф взяли из трех узлов: красный белок → зеленый белок → стоп-сигнал. Плюс третье ребро, ведущее из красного прямо в стоп-сигнал, минуя зеленый — это ловушка, короткий путь. Если бактерия нашла маршрут через все три узла, у нее целы оба гена, и она светится желтым.
Вот и весь компьютер, где желтая колония — это ответ.
Не верю
Первым делом я решил проверить их числа. Если арифметика сойдется, дальше можно доверять остальному. Три ребра, у каждого две ориентации, порядок любой: 3!·2³ = 48 конфигураций. В статье 48, значит — сходится.
Дальше они прикидывают, что было бы на графе из семи узлов — том самом, с которым в 1994 году Леонард Адлеман сделал первый ДНК-компьютер. 14 ребер дают 14!·2¹⁴ конфигураций, из них решениями будут 8!·2⁸.
14!*214 = 1.428e+15 (в статье 1.42e15)
8!*28 = 10321920 (в статье 10321920)
Отношение 1 к 138378240 (в статье 138378240)
Все до последней цифры. Хорошо, работаем дальше. Я попытался воспроизвести их математическую модель целиком, не подглядывая в их MATLAB, которого у меня и нет.
Модель называется марковская цепь, и звучит страшнее, чем есть на самом деле. Смысл такой: у системы есть конечный набор состояний (у нас — 48 вариантов раскладки ребер), и на каждом шаге она случайно перепрыгивает в соседнее по известным правилам. Один шаг — один переворот куска ДНК ферментом. Зная правила, можно посчитать «с какой вероятностью что будет» после любого количества шагов.
Отдельно закодировал правила фенотипа — какая раскладка какой цвет колонии дает. Я не стал списывать их таблицу, а сделал с нуля, исходя из логики чтения ДНК: где стартует транскрипция, в каком порядке идут половинки, где ее глушит стоп-сигнал.
Конфигураций по фенотипам (в статье: 2 / 14 / 1 / 31):
- желтый — 2 конфигурации = 4,2% ← решение
- красный — 14 конфигураций = 29,2%
- зеленый — 1 конфигурация = 2,1%
- бесцветный — 31 конфигурация = 64,6%
Совпало по всем четырем. Это не просто хорошо, модель вполне правильная — четыре независимых числа случайно не попадают. Дальше проверил их главное утверждение: что 20 переворотов хватает, чтобы система забыла, откуда стартовала, и все 48 вариантов стали равновероятны.
Сходимость к равновесию (расстояние до равномерного распределения):
старт ABC 1:0.8750 2:0.6458 4:0.3434 6:0.2230 10:0.1077 20:0.0174 40:0.0005
старт ACB 1:0.8750 2:0.6458 4:0.3434 6:0.2230 10:0.1077 20:0.0174 40:0.0005
старт BAC 1:0.8750 2:0.6458 4:0.3434 6:0.2230 10:0.1077 20:0.0174 40:0.0005
Заметьте: все три строки совпадают до последнего знака. Это не копипаста — перевороты действуют на позиции, поэтому цепочка забывает свой старт с одинаковой скоростью из любой точки.
Цифры после двоеточия показывают, насколько распределение еще отличается от идеально равномерного: единица — это «совсем не перемешалось», ноль — это «перемешалось полностью». На 20 перевороте — 1,7%.
В статье также описана аномалия: на реальных чашках каждый вариант сохранил больше своего исходного цвета, чем предсказывает равновесие. Авторы предположили, что Hin просто не успевает доработать — ему для реакции нужна закрученность плазмиды, а каждая реакция ее раскручивает, так что за одно поколение выходит не 20 переворотов, а 4–6.
Я подставил в свою модель эти 4–6 переворотов. Доля желтых колоний после k переворотов (равновесие дает 4,2%):
| Старт | 0 | 2 | 4 | 6 | 10 | 20 |
| ABC | 100,0% | 16,7% | 7,3% | 5,1% | 4,3% | 4,2% |
| ACB | 0,0% | 5,6% | 4,9% | 4,5% | 4,2% | 4,2% |
| BAC | 0,0% | 0,0% | 2,8% | 3,7% | 4,1% | 4,2% |
Вот аномалия, прям как у авторов статьи: на четырех переворотах стартовая конфигурация ABC дает 7,3% желтых вместо положенных 4,2%, а самая далекая от решения BAC — 2,8%. Перекос в сторону старта, в обе стороны.
Модель воспроизводит не только то, что предсказывали в материале, но и то, что у них пошло не по плану. Пока радуемся.
А сколько ее надо
Все вышеописанное работает на трех узлах. Мой вопрос был — а сколько бактерий нужно на нормальную задачу.
Формулу беру их же, из той же статьи, чтобы не жульничать: вероятность того, что хотя бы одна из m плазмид держит решение, есть 1−(1−p)m, где p — доля раскладок-решений. Хотим 99,9% уверенности — решаем относительно m.
Допущения я нарочно беру все в пользу бактерий:
- клетка весит один пикограмм и занимает один кубический микрон (округлил вверх, реальная мельче);
- в клетке 100 копий плазмиды, и каждая считается отдельным кандидатом — то есть одна клетка равна 100 процессорам;
- насыщенная культура — миллиард клеток на миллилитр;
- перебираем сразу маршруты, которых (n−1)!/2, а не раскладки ребер по схеме 2009 года. Это гораздо щедрее: на семи узлах у них одно решение приходится на 138 млн раскладок, а маршрутов там всего 360.
То есть, я строю не кишечную палочку, а идеальную сферическую кишечную палочку в вакууме, которой все удается.
def cells_needed(n, copies=PLASMID_COPY, conf=CONF):
“””
Каждая копия плазмиды — один случайный кандидат.
P (хотя бы одна из m копий держит решение) = 1-(1-p)m, где p = 1/routes(n).
Формула из статьи Baumgardner et al. 2009, беру их же.
“””
N = routes(n)
if N <= 1: # на трех городах маршрут ровно один
return 1.0 / copies
m = math.log(1 – conf) / math.log1p(-1.0 / N)
return m / copies
| n | Маршрутов | Клеток | Масса | Объем культуры | |
| 10 | 1,814e+05 | 1,253e+04 | 12,5 нг | 1,253e-08 л | |
| 12 | 1,996e+07 | 1,379e+06 | 1,38 мкг | 1,379e-06 л | |
| 15 | 4,359e+10 | 3,011e+09 | 3,01 мг | 3,011e-03 л | |
| 17 | 1,046e+13 | 7,226e+11 | 723 мг | 7,226e-01 л | ← флакон |
| 20 | 6,082e+16 | 4,201e+15 | 4,2 кг | 4,201e+03 л | ← ферментер |
| 22 | 2,555e+19 | 1,765e+18 | 1,76 т | 1,765e+06 л | |
| 24 | 1,293e+22 | 8,929e+20 | 893 т | 8,929e+08 л | |
| 26 | 7,756e+24 | 5,357e+23 | 5,36e+05 т | 5,357e+11 л | |
| 30 | 4,421e+30 | 3,054e+29 | 3,05e+14 кг | 3,054e+17 л |
Читается так. 15 городов — три миллиграмма бактерий и три миллилитра бульона, отлично, работает. 17 — флакон на 700 миллилитров, все еще лабораторный масштаб. 20 — четыре килограмма бактерий и четыре кубометра культуры, это уже промышленный ферментер. 24 — 893 тонны, а это уже железнодорожный состав бактерий, для 24 точек на карте.
А теперь вернемся к ноутбуку. Хелд-Карп, тот самый, из таблицы в начале, на чистом Python в один поток:
- n=16 (0,538с ± 0,016);
- n=18 (3,368с ± 0,122);
- n=20 (21,638с ± 0,350).
20 городов — 22 секунды. Против четырех кубометров бульона и суток инкубации. На этом можно закрывать вопрос. Кишечная палочка начинает проигрывать медленному питону примерно с 17 города, дальше разрыв растет как факториал.
А это прям точно?
Меня не отпускала одна фраза из статьи. Авторы пишут, что время, за которое биологический компьютер переберет все 14!·2¹⁴ раскладок, пропорционально логарифму от этого числа — то есть примерно 14·log(14). Тогда как обычному компьютеру нужно время, пропорциональное самому 14!·2¹⁴.
Это заявка на логарифмическое время для NP-полной задачи, ну и очевидно же, что так не бывает. Я хотел это опровергнуть, но не смог, они правы.
Логика такая: бактерии делятся, популяция растет вдвое каждые 20 минут, значит чтобы вырастить N клеток, нужно log₂(N) поколений. Посчитал:
| n | Клеток | Поколений | Время роста |
| 15 | 3,01e+09 | 31 | 10,5 ч |
| 17 | 7,23e+11 | 39 | 13,1 ч |
| 20 | 4,20e+15 | 52 | 17,3 ч |
| 24 | 8,93e+20 | 70 | 23,2 ч |
| 30 | 3,05e+29 | 98 | 32,6 ч |
15 городов — 10,5 часов. 30 городов — почти 33 часа. Пространство поиска выросло в 100 миллиардов миллиардов раз, время выросло втрое. Это настоящий логарифм. Экспонента действительно съедена, и если бы вопрос стоял только о времени, кишечная палочка обыграла бы все на свете. Только вот экспонента никуда не делась.
Куда переехала экспонента
Когда бактерия делится, она не создает вторую бактерию из ничего, она ее строит из сахара. Экспоненциальный рост популяции — это экспоненциальный рост потребления еды, просто в формуле log₂(N) этого не написано, потому что там негде написать.
Считаем. Выход биомассы у кишечной палочки — примерно полграмма сухих клеток на грамм глюкозы, это стандартная цифра. Сухая масса — около 30% от сырой. Значит, на килограмм сырых бактерий нужно грубо 600 граммов сахара. Посмотрим, как это выглядит:
- 15 городов — 1,8 микрограмма (незаметно);
- 20 городов — 2,5 килограмма (пакет из магазина);
- 24 города — 536 тонн (уже фура и не одна);
- 30 городов — 1,83·10¹¹ тонн.
Последнее число стоит развернуть. Мировое производство сахара — около 185 млн тонн в год. Делим: 1,83·10¹¹ / 1,85·10⁸ = 990.
Приблизительно 1 000 лет. То есть весь сахар, который человечество произведет за 1 000 лет, уйдет на перебор маршрутов для 30 точек. Хелд-Карп же закроет их за несколько часов. Правда, ему понадобится 1,5 терабайта памяти. Так что, если так можно выразиться, свою цену за экспоненту платит и кремний, просто не в тоннах сахара.
Здесь, кстати, становится понятно, почему логарифм по времени ничего не спасает. Время у бактерий действительно логарифмическое. Но ресурс — экспоненциальный, и одно другое не отменяет. В общем, для компьютера по экспоненте растет время, потому что железо одно, а работы много. Для бактерий по ней же растет масса.
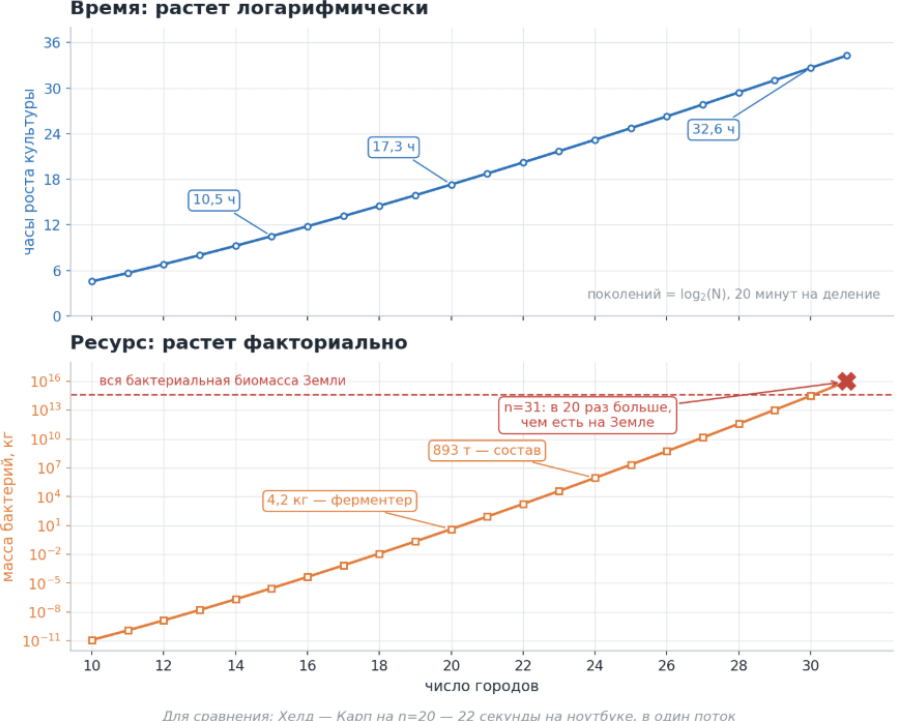
Ну и вся бактериальная биомасса Земли — около 70 гигатонн углерода, это порядка 4,6·10¹⁴ килограммов сырого веса. Есть подозрение, что в какой-то момент нам просто не хватит всех бактерий планеты. Проверим:
- все бактерии Земли: 4,62e+14 кг сырого веса;
- n=30: 3,05e+14 кг ← еще влезаем;
- n=31: 9,16e+15 кг ← уже нет.
На 30 городах вам нужно 2/3 всех бактерий планеты. На 31 — в 20 раз больше, чем их есть вообще.
Тупики
Расчет выше выглядит простым, но в нем есть три тупика.
Первый. При n=3 маршрут ровно один, вероятность попадания равна единице, и math.log1p(-1/N) отдает логарифм нуля. Функция падает на трех городах — на той самой размерности, которую бактерии реально осилили. Отсюда проверка if N <= 1 в коде.
Второй — соблазн считать клетки как маршруты. Кажется логичным: по клетке на кандидата, значит клеток нужно столько же, сколько маршрутов. Но раскладка в каждой клетке случайная и независимая, клетки свободно повторяют друг друга. Чтобы с вероятностью 99,9% накрыть хотя бы один конкретный маршрут, нужно примерно в семь раз больше клеток, чем маршрутов. Разница в семь раз на фоне факториала выглядит мелочью, но она работает против бактерий, и выкидывать ее не стоит.
Третий — отбор. Здесь напрашивается сильное возражение, и авторы статьи сами его формулируют в конце: зачем ждать полного решения, если можно давать антибиотик на промежуточных шагах и оставлять только тех, кто прошел первую половину графа.
Это действительно ломает всю оценку — но ломает в сторону «это уже не перебор». Направленная эволюция с отбором частичных решений — это эвристика: она дает хороший ответ без гарантии, что он лучший. И сравнивать ее надо с двухоптом и муравьиными алгоритмами, где кремний, мягко говоря, тоже кое-что умеет.
То есть выход у бактерий есть. Просто на нем висит табличка «мы больше не решаем задачу точно», а вся красота исходной идеи была ровно в том, что точно.
Все, что вы хотели знать про желтые колонии, но боялись высеять
Второй раунд. Допустим, вы каким-то чудом достали сахар и вырастили культуру. В ней есть ответ. Как вы его оттуда достанете?
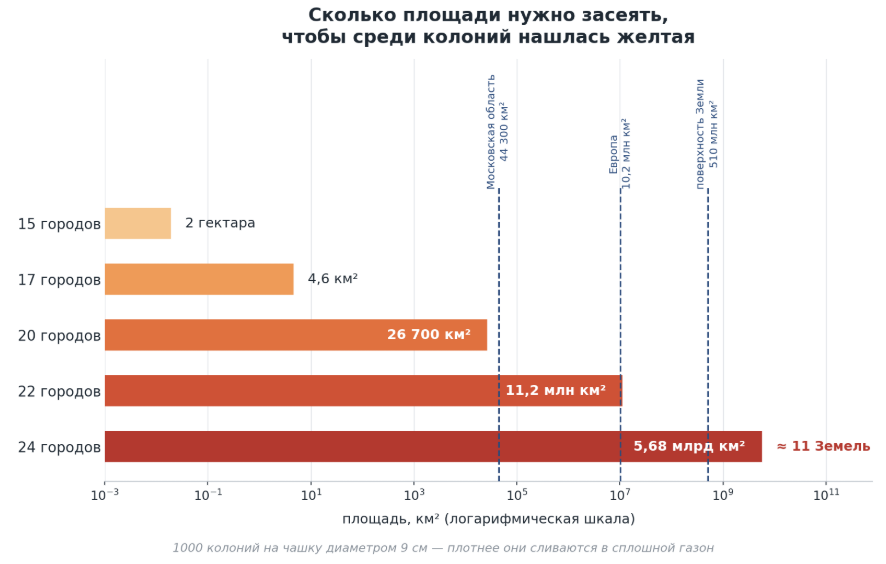
Про это в пересказах не пишут никогда, а это отдельная стена, с массой никак не связанная. Чтобы найти желтую колонию, культуру надо размазать по чашкам так, чтобы колонии не слились в сплошной газон — это примерно 1 000 штук на стандартную чашку диаметром девять сантиметров.
| n | Клеток | Чашек Петри | Площадь |
| 15 | 3,01e+09 | 3,01e+06 | 1,92e+04 м² |
| 17 | 7,23e+11 | 7,23e+08 | 4,6 км² |
| 20 | 4,20e+15 | 4,20e+12 | 2,67e+04 км² |
| 22 | 1,76e+18 | 1,76e+15 | 1,12e+07 км² |
| 24 | 8,93e+20 | 8,93e+17 | 5,68e+09 км² |
15 городов — два гектара чашек Петри. Уже не настольный прибор. 20 — 27 000 квадратных километров. Две трети Московской области, засеянной чашками, и это вплотную, без дорог. 24 — 5,5 млрд квадратных километров, при том что вся поверхность Земли вместе с океанами это 5,1·10⁸. 11 «Земель», в чашках Петри.
И это еще оптимистично, потому что я считаю, что желтую колонию видно. На трех узлах ее действительно видно: желтый дают ровно две раскладки из 48. А на семиузловом графе авторы посчитали сами: истинных решений 10 321 920, а всего раскладок, дающих правильный набор цветов — 168 006 848.
10321920 / 168006848 = 0,061 (то есть 6%)
94% желтых колоний на семи узлах при этом вранье: гены собрались, а маршрут при этом неправильный. И с ростом задачи доля истинных падает дальше, это тоже их слова.
То есть визуальное считывание — то самое, что было главной находкой работы — становится невозможным раньше, чем кончается сахар. Остается секвенировать пул из миллиарда плазмид.
Палочка умеет оптимизировать
Пока я читал про хемотаксис (надо же понимать, что бактерия умеет на самом деле) выяснилась смешная вещь. Кишечная палочка действительно решает задачу оптимизации. Постоянно и без всяких плазмид, и всю свою жизнь, буквально всю. Просто она решает немного другую задачу оптимизации.
Она плывет по прямой, потом кувыркается и меняет направление наугад. Если концентрация вкусного растет — прямые участки делаются длиннее. Падает — кувыркается чаще. Вот и все. Никакого сравнения направлений, никакой карты, никакой памяти дальше нескольких секунд. Только «сейчас лучше, чем полсекунды назад».
Это стохастический градиентный спуск, реализованный в железе, на паре десятков белков, в клетке размером в микрон. И работает он прекрасно — потому что решает задачу, у которой есть градиент, направление «теплее-холоднее». У задачи коммивояжера градиента нет, у нее факториальное пространство без структуры. Заставлять бактерию перебирать маршруты — это как заставлять градиентный спуск играть в судоку (хотя может я чего-то не понимаю, думаю, умные люди поправят в комментариях).
Отдельная интермедия для тех, кто читал про «амебу, решившую задачу коммивояжера за линейное время». Это работа Zhu, Kim, Hara и Aono, Royal Society Open Science, 2018. Так вот, тут надо сделать два уточнения.
Во-первых, речь не про бактерии. Physarum polycephalum — слизевик, и к бактериям он отношения не имеет примерно никакого. Их валят в одну кучу под общим «микроорганизмы умнее нас».
Во-вторых, в контуре сидит компьютер. Амеба расползается по 64 каналам чипа, а подсветку каналов — то самое, что заставляет ее отдергиваться и перестраиваться — считает обычная электронная система по нейросетевой модели и в реальном времени. Уберите из установки компьютер и останется мокрая клякса на агаре.
Вот это, по-моему, и есть главная мысль всей истории. Все известные мне «живые вычислители» при ближайшем рассмотрении оказываются гибридами, где живая часть делает эффектную, но маленькую работу, а всю неэффектную — отбор, считывание, управление, проверку — по-прежнему тащит компьютер.
Ну а чтобы не раздувать хронометраж, три скрипта лежат под катом: бенчмарк перебора против Хелда-Карпа, симуляция бактериального компьютера на марковской цепи и расчет массы, сахара и чашек Петри. Если возникнет желание перепроверить цифры, то берите и запускайте.
Спойлер: расчет массы, сахара и чашек Петри целиком
      #!/usr/bin/env python3
"""
Сколько кишечной палочки нужно, чтобы перебрать все маршруты
задачи коммивояжера, и во что это обходится по массе, еде и месту.
"""
import math
CELL_MASS_G  = 1e-12   # ~1 пг сырого веса на клетку, округлено вверх
DENSITY_ML   = 1e9     # насыщенная культура, клеток/мл
PLASMID_COPY = 100     # копий плазмиды на клетку, щедро, в пользу бактерий
CONF         = 0.999   # хотим найти решение с вероятностью 99,9%
GEN_TIME_MIN = 20      # деление E. coli в идеальных условиях
DRY_FRACTION = 0.30    # сухая масса от сырой
SUGAR_PER_DRY = 2.0    # ~0,5 г сухих клеток на грамм глюкозы
DISH_CM2     = math.pi * (9 / 2) ** 2   # чашка Петри 9 см
PER_DISH     = 1000    # колоний на чашку, чтобы не слились в газон
# бактерии Земли: 70 Гт углерода (Bar-On, Phillips & Milo, PNAS 2018),
# сухая масса ~2x углерода, сырая ~3,3x сухой
EARTH_BACTERIA_KG = 70e15 / 1e3 * 2 * 3.3
def routes(n):
    """число различных маршрутов симметричной задачи коммивояжера"""
    return math.factorial(n - 1) // 2
def cells_needed(n, copies=PLASMID_COPY, conf=CONF):
    N = routes(n)
    if N <= 1:
        return 1.0 / copies
    m = math.log(1 - conf) / math.log1p(-1.0 / N)
    return m / copies
def fmt_mass(kg):
    if kg < 1e-9:  return f"{kg*1e12:.3g} нг"
    if kg < 1e-6:  return f"{kg*1e9:.3g} мкг"
    if kg < 1e-3:  return f"{kg*1e6:.3g} мг"
    if kg < 1:     return f"{kg*1e3:.3g} г"
    if kg < 1e3:   return f"{kg:.3g} кг"
    if kg < 1e12:  return f"{kg/1e3:.3g} т"
    return f"{kg:.3g} кг"
print(f"{'n':>3} {'маршрутов':>11} {'клеток':>11} {'масса':>12} {'объем культуры':>16}")
for n in [10, 12, 15, 17, 20, 22, 24, 26, 30]:
    c = cells_needed(n)
    print(f"{n:>3} {routes(n):>11.3e} {c:>11.3e} "
          f"{fmt_mass(c * CELL_MASS_G / 1e3):>12} "
          f"{c / (DENSITY_ML * 1e3):>13.3e} л")
print("\nВремя роста культуры:")
print(f"{'n':>3} {'клеток':>10} {'поколений':>10} {'время роста':>13}")
for n in [15, 17, 20, 24, 30]:
    c = cells_needed(n)
    gen = math.log2(c)
    print(f"{n:>3} {c:>10.2e} {gen:>10.0f} {gen*GEN_TIME_MIN/60:>11.1f} ч")
print("\nСколько на это нужно сахара:")
for n in [15, 20, 24, 30]:
    wet_kg = cells_needed(n) * CELL_MASS_G / 1e3
    print(f"  {n:>2} городов: {fmt_mass(wet_kg * DRY_FRACTION * SUGAR_PER_DRY)}")
sugar_30_t = cells_needed(30) * CELL_MASS_G / 1e3 * DRY_FRACTION * SUGAR_PER_DRY / 1e3
print(f"  на 30 городов это {sugar_30_t:.2e} тонн, "
      f"а мировое производство ~1,85e8 т/год")
print(f"  то есть {sugar_30_t / 1.85e8:.0f} лет всего мирового производства сахара")
print("\nГде кончаются бактерии:")
n = 4
while cells_needed(n) * CELL_MASS_G / 1e3 < EARTH_BACTERIA_KG:
    n += 1
print(f"  все бактерии Земли: {EARTH_BACTERIA_KG:.2e} кг сырого веса "
      f"-> пробивается на n = {n}")
print(f"  n={n-1}: {cells_needed(n-1)*CELL_MASS_G/1e3:.2e} кг     <- еще влезаем")
print(f"  n={n}: {cells_needed(n)*CELL_MASS_G/1e3:.2e} кг     <- уже нет")
print("\nСколько чашек Петри нужно, чтобы найти желтую колонию:")
print(f"{'n':>3} {'клеток':>10} {'чашек Петри':>13} {'площадь':>14}")

for n in [15, 17, 20, 22, 24]:
    c = cells_needed(n)
    dishes = c / PER_DISH
    m2 = dishes * DISH_CM2 / 1e4
    area = f"{m2:.3g} м2" if m2 < 1e6 else f"{m2/1e6:.3g} км2"
    print(f"{n:>3} {c:>10.2e} {dishes:>13.2e} {area:>14}")
Спойлер: симуляция бактериального компьютера, марковская цепь
      #!/usr/bin/env python3
"""
Воспроизвожу бактериальный компьютер Baumgardner et al. 2009.
Три ДНК-ребра A, B, C между hixC-сайтами. Hin-рекомбиназа инвертирует
непрерывный блок ребер: порядок в блоке разворачивается, ориентация
каждого ребра меняется. Состояние = знаковая перестановка (A,B,C).
Всего 3! * 2^3 = 48 состояний.
"""
import itertools, collections
EDGES = "ABC"
def all_states():
    for perm in itertools.permutations(range(3)):
        for signs in itertools.product([1, -1], repeat=3):
            yield tuple(zip(perm, signs))
def show(s):
    return "".join(EDGES[e] + ("" if sg > 0 else "'") for e, sg in s)
def flips(s):
    """все инверсии непрерывных блоков: 6 штук для трех ребер"""
    out = []
    for i in range(3):
        for j in range(i, 3):
            block = [(e, -sg) for e, sg in s[i:j + 1]][::-1]
            out.append(tuple(s[:i]) + tuple(block) + tuple(s[j + 1:]))
    return out
def color(s):
    """
    Фенотип, выведенный с нуля из логики транскрипции.
    Кассета: T7-промотор - RBS - 5'RFP - [ребро1][ребро2][ребро3]
    A = 3'RFP -> 5'GFP;  B = 3'GFP -> TT;  C = 3'RFP -> TT
    Терминатор в обратной ориентации не работает - это они и обнаружили.
    """
    (e1, s1), (e2, s2), _ = s
    first_fwd = EDGES[e1] if s1 > 0 else None
    # RFP цел, если первое ребро - прямое A или прямое C
    if first_fwd == "A":
        # GFP цел, только если второе ребро - прямое B
        if EDGES[e2] == "B" and s2 > 0:
            return "желтый"       # RFP + GFP -> решение
        return "красный"          # только RFP
    if first_fwd == "C":
        return "красный"          # C упирается в TT, дальше транскрипции нет
    # первое ребро C': RFP не собран, но A и B ниже могут собрать GFP
    if EDGES[e1] == "C" and s1 < 0:
        if show(s) == "C'AB":
            return "зеленый"
    return "бесцветный"
states = list(all_states())
assert len(states) == 48
idx = {s: i for i, s in enumerate(states)}
cnt = collections.Counter(color(s) for s in states)
print("Конфигураций по фенотипам (в статье: 2 / 14 / 1 / 31):")
for k in ["желтый", "красный", "зеленый", "бесцветный"]:
    print(f"  {k:<12} {cnt[k]:>3}  = {cnt[k]/48*100:5.1f}%")
print()
# марковская цепь: строка = состояние, 6 равновероятных переворотов
P = [[0.0] * 48 for _ in range(48)]
for s in states:
    for t in flips(s):
        P[idx[s]][idx[t]] += 1 / 6
def step(v):
    out = [0.0] * 48
    for i, pi in enumerate(v):
        if pi:
            row = P[i]
            for j in range(48):
                out[j] += pi * row[j]
    return out
def tv(v):
    return 0.5 * sum(abs(x - 1 / 48) for x in v)
print("Сходимость к равновесию (расстояние до равномерного распределения):")
for start in ["ABC", "ACB", "BAC"]:
    s0 = next(s for s in states if show(s) == start)
    v = [0.0] * 48; v[idx[s0]] = 1.0
    line = []
    for k in range(1, 41):
        v = step(v)
        if k in (1, 2, 4, 6, 10, 20, 40):
            line.append(f"{k}:{tv(v):.4f}")
    print(f"  старт {start:<4} " + "  ".join(line))
print()
print("Доля желтых колоний после k переворотов (равновесие дает 4.2%):")
print("  старт  " + "".join(f"{k:>8}" for k in [0, 2, 4, 6, 10, 20]))
for start in ["ABC", "ACB", "BAC"]:
    s0 = next(s for s in states if show(s) == start)
    v = [0.0] * 48; v[idx[s0]] = 1.0
    row = []
    for k in range(0, 21):
        if k in (0, 2, 4, 6, 10, 20):
            y = sum(v[idx[s]] for s in states if color(s) == "желтый")
            row.append(f"{y*100:7.1f}%")
        v = step(v)
    print(f"  {start:<7}" + "".join(row))
Спойлер: бенчмарк — перебор в лоб против Хелда-Карпа
      #!/usr/bin/env python3
"""
Перебор в лоб против Хелда-Карпа на одних и тех же точках.
Оба дают точный оптимум. Разница только в том, сколько работы делается зря.
"""
import math, time, statistics, itertools, random
def brute_force(d, n):
    """сгенерировать все маршруты, посчитать каждый, выбрать минимум"""
    best = float("inf")
    for p in itertools.permutations(range(1, n)):
        t = (0,) + p
        s = sum(d[t[i]][t[(i + 1) % n]] for i in range(n))
        if s < best:
            best = s
    return best
def held_karp(d, n):
    """динамика по подмножествам: O(2^n * n^2) вместо O(n!)"""
    C = {(1 << k, k): (d[0][k], 0) for k in range(1, n)}
    for size in range(2, n):
        for sub in itertools.combinations(range(1, n), size):
            bits = 0
            for b in sub:
                bits |= 1 << b
            for k in sub:
                prev = bits & ~(1 << k)
                C[(bits, k)] = min((C[(prev, m)][0] + d[m][k], m)
                                   for m in sub if m != k)
    bits = (2 ** n - 1) - 1
    return min(C[(bits, k)][0] + d[k][0] for k in range(1, n))
def make(n, seed):
    """n случайных точек на единичном квадрате -> матрица расстояний"""
    rnd = random.Random(seed)
    pts = [(rnd.random(), rnd.random()) for _ in range(n)]
    return [[math.dist(a, b) for b in pts] for a in pts]
def bench(fn, n, runs):
    ts = []
    for r in range(runs):
        d = make(n, 100 + r)
        t0 = time.perf_counter()
        fn(d, n)
        ts.append(time.perf_counter() - t0)
    return (statistics.mean(ts),
            statistics.stdev(ts) if len(ts) > 1 else 0.0,
            len(ts))
print(" n |        перебор в лоб |          Хелд-Карп | во сколько раз")
for n, rb, rh in [(8, 6, 6), (9, 6, 6), (10, 5, 5), (11, 3, 5), (12, 2, 5)]:
    mb, sb, kb = bench(brute_force, n, rb)
    mh, sh, kh = bench(held_karp, n, rh)
    print(f"{n:>2} | {mb:8.3f}s ± {sb:.3f} (n={kb}) | "
          f"{mh:7.4f}s ± {sh:.4f} (n={kh}) | {mb/mh:7.0f}x")
# дальше перебор уже не дождаться, гоняем только динамику
print("\nХелд-Карп, python3, один поток:")
for n, runs in [(16, 3), (18, 2), (20, 2)]:
    m, s, k = bench(held_karp, n, runs)
    print(f"  n={n:<3} {m:8.3f}s ± {s:.3f} (n={k})")