Как автоматизировать оценку 400 резюме с помощью FMC и ничего не сломать
Гайд по настройке автоматической проверки содержимого резюме требованиям вакансии с помощью ИИ.
Когда в день вам присылают 400 резюме на одну вакансию, «посмотреть всех» физически не получится. Зато это выглядит прямо как задача под автоматизацию!
Итак, у меня есть вакансия и огромная пачка PDF-файлов с резюме. Надо понять, в каких из них действительно подтверждаются нужные компетенции, где информации не хватает и кого стоит посмотреть в первую очередь. Мы не будем автоматизировать сам найм или отправку отказов. В кейсе ниже LLM будет составлять техническую выжимку и помогать разобрать очередь. Но финальное решение останется за человеком.
По идее можно было бы открыть любую ИИшницу, загрузить туда пачку резюме и собрать результаты. Но это не автоматизация, а ерунда. Поэтому мне нужен API, который можно подключить и встроить в собственный процесс проверки резюме. Для меня тут важен именно уровень абстракции. Я не хочу искать GPU, скачивать веса модели, подбирать версию CUDA, поднимать vLLM, рассчитывать, влезет ли модель в видеопамять, настраивать масштабирование, мониторить отдельный ML-зоопарк и выяснять, почему после обновления драйвера все снова упало.
Статью написал Роман Шубин, CTO и автор Telegram-канала Bash Days.
Идея и подготовка
Да, у меня есть домашний LLM-стек, собранный до всех этих кризисов с памятью, но это решение мне не подошло. Оно требует постоянно держать эту махину включенной, а я частенько нахожусь в перелетах и сильно тревожусь, если оставил дома «включенный утюг». Поэтому выбор пал на FMC. Все работает в одном из московских дата-центров Selectel, не потребляет мое электричество и доступно в любое время и в любом месте. То что нужно! Self-hosted — это хорошо, но под некоторые задачи все же лучше выбирать инструмент, который будет комфортнее.
Интеграция модели в мой проект и бизнес-логика остаются на моей стороне, сервис разделяет эти зоны. То есть Selectel дает мне работающий эндпоинт, а я уже решаю, как использовать его в своем коде.
На момент моего тестирования, FMC находится на стадии public preview. Инференс-сервисы работают синхронно, а загрузка собственных моделей в каталог пока не поддерживается.
Наша задача — взять описание конкретной вакансии, извлечь текст из резюме, проверить наличие подтвержденного опыта по заранее заданным критериям и собрать понятный отчет для HR. Важно — не улучшать резюме, не оценивать человека, не анализировать фотографию, возраст или семейное положение. А именно сопоставить профессиональный опыт из документа с требованиями конкретной вакансии.
В результате вместо папки с 400 резюме я хочу получить таблицу:
| Кандидат | Соответствие | Итог |
| resume-001.pdf | 88/100 | соответствует профилю |
| resume-002.pdf | 61/100 | требуется ручная проверка |
| resume-003.pdf | 34/100 | недостаточно подтверждений |
| resume-004.pdf | 42/100 | много ключевых слов, мало доказательств |
| resume-005.pdf | 84/100 | соответствует профилю |
При этом по каждому баллу должны быть видны доказательства из исходного текста:
Критерий: CI/CD
Уровень: 4 из 4
Доказательства:
- Разработал GitLab CI pipeline для сборки, тестирования и развертывания 18 сервисов.
- Сократил время деплоя с 35 до 12 минут.
Если доказательства нет, модель должна честно написать: «В тексте резюме подтверждение не найдено», а не додумывать опыт кандидата.
Для анализа резюме подойдет обычная text-to-text-модель. На вход отправляем вакансию, критерии и извлеченный текст, на выходе ожидаем структурированный JSON. Никакие model tools для этого не потребуются. Последовательностью действий управляет Python:

Модель не должна сама открывать файл, выполнять команды или менять статус кандидата в кадровой системе. Она решает только одну задачу — делает структурированную оценку по заданным критериям на основе текста из резюме.
Для эксперимента я взял t-tech/T-pro-it-2.1. Модель доступна в актуальном каталоге FMC вместе с T-lite, Qwen, Gemma и другими text-to-text-моделями.
Почему именно она? Потому что входные данные у меня русскоязычные. При этом в резюме встречаются английские названия технологий, команды, аббревиатуры и описание технических проектов. От модели мне нужен не творческий текст, а строгое следование инструкции:
- обработать заранее заданный список критериев,
- не придумывать отсутствующий опыт,
- привести доказательства,
- вернуть валидный JSON,
- не рассчитывать итоговый балл самостоятельно.
Последний пункт тут очень важен. Модель определяет уровень подтвержденного опыта, итоговую математику выполняет Python. Иначе одинаковые оценки критериев однажды могут превратиться в 78 баллов, а в другой раз — в 83. Модели, конечно, виднее, но меня такой гидрометцентр не устраивает.
По архитектуре получилась следующая схема:
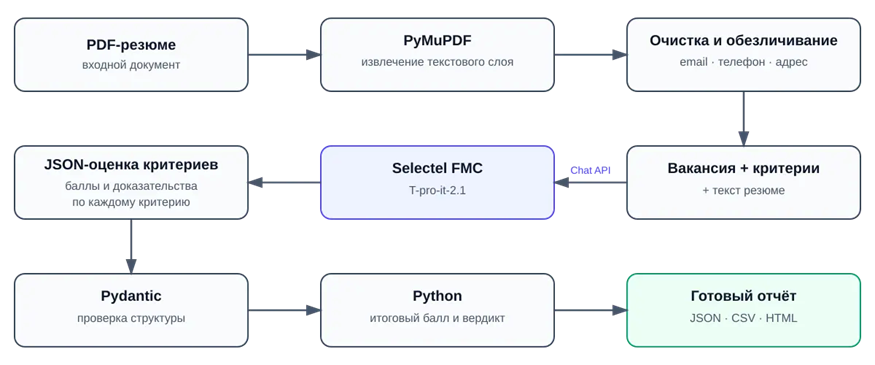
LLM находится примерно в середине конвейера. Она не управляет процессом, не принимает кадровое решение и не формирует итоговый балл. Все опасные операции остаются в обычном коде. Роботу отдаем только самую рутину, все остальное реализуем самостоятельно.
Для эксперимента я придумал вакансию DevOps-инженера уровня middle. Так мне будет проще проверить модель самостоятельно, если она вдруг решит, что человек с четырьмя годами Django и одним домашним Docker Compose идеально подходит на эксплуатацию кластера Kubernetes.
Мок с описанием вакансии (чуть позже закинем его в /vacancies/middle-devops.yaml):
      id: middle-devops
title: Middle DevOps инженер

description: |
  Ищем DevOps-инженера для поддержки и развития внутренней
  платформы разработки.

  Основные задачи:

  - администрирование Linux-серверов;
  - автоматизация конфигурации;
  - развитие CI/CD;
  - контейнеризация приложений;
  - мониторинг и диагностика production-инфраструктуры;
  - участие в разборе инцидентов.

scoring_scale:
  0: Подтверждений в резюме нет
  1: Технология только упомянута
  2: Есть базовый практический опыт
  3: Есть самостоятельный production-опыт
  4: Есть сложный опыт, ответственность или измеримый результат

criteria:
  - id: linux_production
	title: Администрирование Linux в production
	required: true
	weight: 20
	expected_evidence:
  	- сопровождение production-серверов
  	- диагностика проблем
  	- systemd
  	- сеть
  	- файловые системы
  	- управление сервисами

  - id: automation
	title: Автоматизация конфигурации
	required: true
	weight: 15
	expected_evidence:
  	- Ansible
  	- SaltStack
  	- Puppet
  	- собственные инструменты автоматизации

  - id: containers
	title: Работа с контейнерами
	required: true
	weight: 15
	expected_evidence:
  	- Docker
  	- Docker Compose
  	- сборка образов
      - диагностика контейнеров

  - id: ci_cd
	title: Построение и поддержка CI/CD
	required: true
	weight: 15
	expected_evidence:
  	- GitLab CI
  	- Jenkins
  	- GitHub Actions
  	- Argo CD
  	- автоматизация деплоя

  - id: monitoring
	title: Мониторинг и логирование
	required: true
	weight: 10
	expected_evidence:
  	- Prometheus
  	- Grafana
  	- Zabbix
  	- Loki
  	- Alertmanager

  - id: troubleshooting
	title: Диагностика сложных проблем
	required: true
	weight: 10
	expected_evidence:
  	- разбор аварий
  	- поиск первопричины
  	- работа с логами и метриками
  	- сокращение времени восстановления

  - id: kubernetes
	title: Kubernetes
	required: false
	weight: 10
	expected_evidence:
  	- эксплуатация кластера
  	- Helm
  	- обновление
  	- диагностика

  - id: terraform_cloud
	title: Terraform и облачная инфраструктура
	required: false
	weight: 5
	expected_evidence:
  	- Terraform
  	- OpenStack
  	- Selectel
  	- Yandex Cloud
  	- AWS
  	- другие публичные облака
Сумма всех весов == 100. Каждый критерий модель оценивает от 0 до 4. Python переводит уровень в баллы: баллы критерия = вес × уровень / 4.
Например:
Linux production
Вес: 20
Уровень: 3 из 4
20 × 3 / 4 = 15 баллов
Почему нельзя просто искать ключевые слова? Изначально я хотел решить это регулярными выражениями:
      if "kubernetes" in resume.lower():
	score += 10
Но тогда возникнет неувязочка с кандидатом, у которого есть такой блок:
Навыки:
Linux, Docker, Kubernetes, Terraform, Ansible, GitLab CI, Jenkins, Prometheus, Grafana, AWS, Azure, GCP, OpenStack, Helm, Argo CD, Python, Bash, Go.
Он всех обманет и получит максимальный балл, хотя из текста вообще не ясно:
- использовал ли он эти инструменты в работе,
- настраивал ли что-нибудь самостоятельно,
- видел ли продакшен,
- отвечал ли за результат,
- или просто скопировал список из вакансии.
С другой стороны, сильный SRE может не использовать Ansible, но несколько лет управлять конфигурацией через SaltStack. Поиск по ключевым словам скажет: «Ansible не найден — ноль баллов». А нормальный анализ должен выявить, что SaltStack решает тот же класс задач и подтверждает опыт автоматизации конфигурации.
Вот здесь модель будет прям полезна и в тему. Для статьи я не стал брать настоящие резюме. Вместо этого подготовил пять синтетических PDF с заранее известными особенностями. Так я сразу проверю работу пайплайна без слива персональных данных и буду понимать, что моя система должна найти. Ну или как говорят в простонародье — использую моки.
DevOps-инженер
Опыт работы: 4 года
ООО «Рога и копыта»
DevOps-инженер
Май 2023 — настоящее время
- Администрировал 60 виртуальных машин Ubuntu и Debian
- Автоматизировал настройку серверов через Ansible
- Разработал GitLab CI pipeline для сборки, тестирования и развертывания 18 сервисов
- Перевел приложения в Docker и Docker Compose
- Сократил среднее время деплоя с 35 до 12 минут
- Настроил Prometheus, Grafana, Loki и Alertmanager
- Участвовал в устранении production-инцидентов и подготовке postmortem
- Поддерживал Kubernetes-кластер из восьми worker узлов
- Создавал виртуальные машины в OpenStack через Terraform
Навыки:
Linux, Bash, Python, Ansible, Terraform, Docker, Kubernetes, GitLab CI, Prometheus, Grafana, Loki.
Ручная оценка — соответствует профилю вакансии.
Системный администратор
Опыт работы: 6 летПроизводственная компания
Системный администратор
2019 — настоящее время
- Поддерживал серверы CentOS и Ubuntu
- Настраивал nginx, systemd, DNS и резервное копирование
- Использовал Bash скрипты для типовых операций
- Настроил Zabbix для серверов и сетевого оборудования
- Разбирал проблемы с дисками, сетью и производительностью
- Запускал отдельные приложения в Docker
- Использовал GitLab CI для запуска двух внутренних скриптов
- Писал небольшие Ansible playbook
Kubernetes и Terraform в работе не использовал
Ручная оценка — есть хорошая Linux-база, но требуется ручная проверка.
Python-разработчик
Опыт работы: 4 года
- Разрабатывал backend на Python, Django и FastAPI
- Использовал PostgreSQL и Redis
- Собирал Docker-образы приложений
- Настроил несколько workflow в GitHub Actions
- Разворачивал проекты на тестовом сервере Ubuntu
- Работал с Sentry и логами приложений
Навыки:
Python, Django, FastAPI, Docker, PostgreSQL, Redis, GitHub Actions.
Ручная оценка — не соответствует текущему профилю вакансии. Не потому, что кандидат плохой. Просто в резюме не подтверждена большая часть требований именно этой позиции.
DevOps / SRE / Cloud Engineer
Навыки:
Linux, Docker, Kubernetes, Terraform, Ansible, Jenkins, GitLab CI, Prometheus, Grafana, Loki, ELK, AWS, Azure, GCP, OpenStack, Helm, Argo CD, Python, Bash, Go.
Опыт работы:
Системный администратор
2023–2025
Работа с серверами, облаками, контейнерами, автоматизацией и мониторингом.
Ручная оценка — требуется ручная проверка. Технологий много, доказательств почти нет. Это отдельный тест на то, сможет ли модель отличить реальный опыт от кейворд-стафинга (попытки обойти АТС).
Site Reliability Engineer
Опыт работы: 3 года
- Поддерживал Linux инфраструктуру крупного сервиса
- Управлял конфигурацией серверов через SaltStack
- Сопровождал Kubernetes-кластеры и Helm-чарты
- Настроил Argo CD для GitOps деплоя
- Создавал инфраструктуру в AWS через Terraform
- Построил мониторинг на Prometheus и Grafana
- Снизил MTTR production-инцидентов с 50 до 20 минут
- Проводил разбор аварий
- Автоматизировал типовые диагностические проверки
Навыки:
Linux, SaltStack, Kubernetes, Helm, Argo CD, Terraform, AWS, Prometheus, Grafana, Python.
Ручная оценка — соответствует профилю вакансии. Ansible и GitLab CI не указаны, но есть близкий и сильный опыт с SaltStack и Argo CD.
Если модель занимается только поиском ключевых слов, она занижает оценку.
Так, болванки готовы, теперь рисуем структуру проекта, у меня получилось так:
      resume-matcher/
├── .env
├── requirements.txt
├── vacancies/
│   └── middle-devops.yaml
├── resumes/
│   ├── resume-001.pdf
│   ├── resume-002.pdf
│   ├── resume-003.pdf
│   ├── resume-004.pdf
│   └── resume-005.pdf
├── results/
├── templates/
│   └── report.html.j2
└── src/
	├── __init__.py
	├── models.py
	├── pdf_parser.py
	├── anonymizer.py
	├── fmc_client.py
	├── scoring.py
	├── report.py
	└── main.py
Создаем сервис в облаке
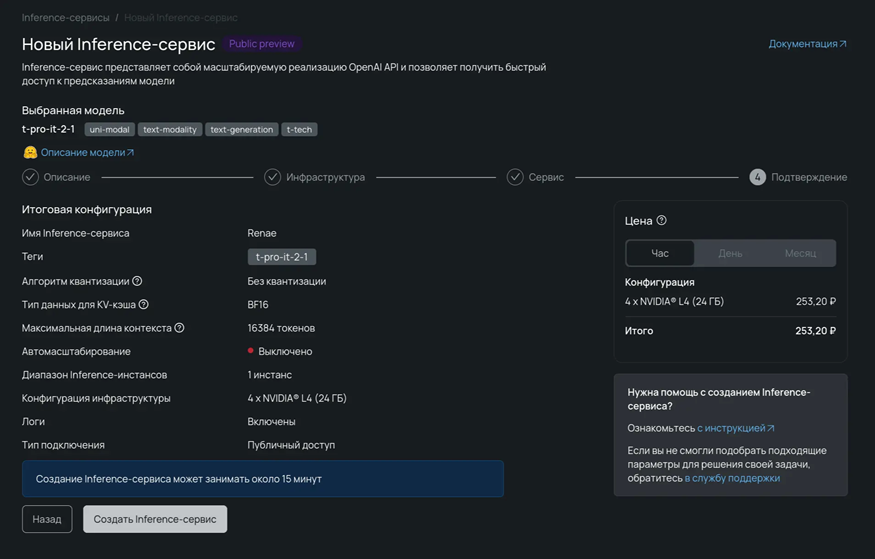
Теперь надо создать инференс-сервис. Идем в панель управления → Продукты → Foundation Models Catalog и выбираем:
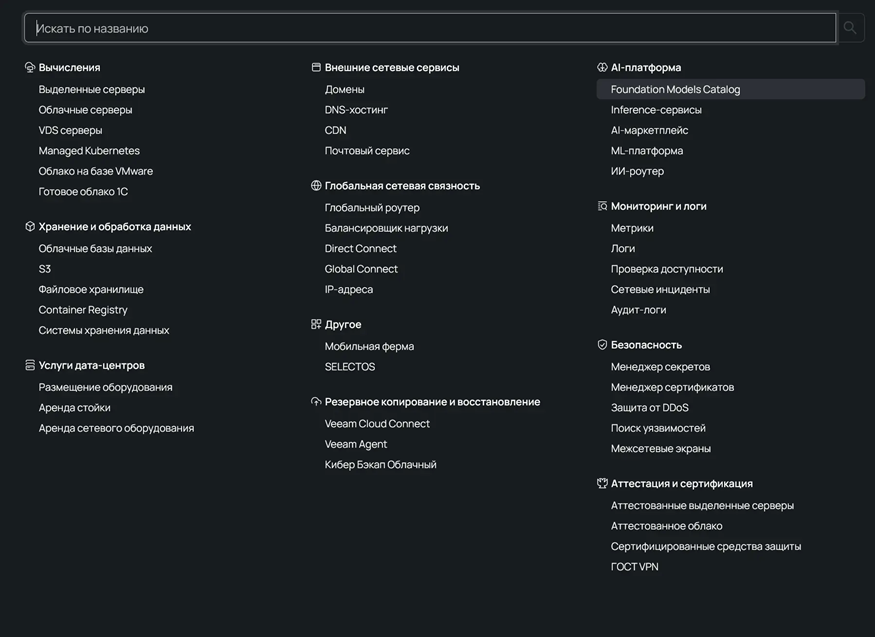
Для теста я выбрал:
- Модель: t-pro-it-2-1,
- Инстансы: 1,
- Масштабирование: фиксированное,
- GPU: 4 x NVIDIA L4 (24 ГБ),
- Контекст: 16 384.
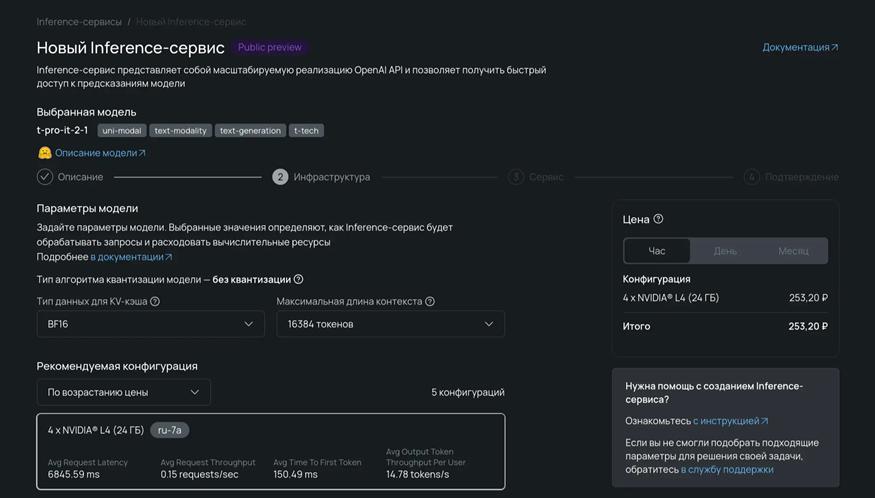
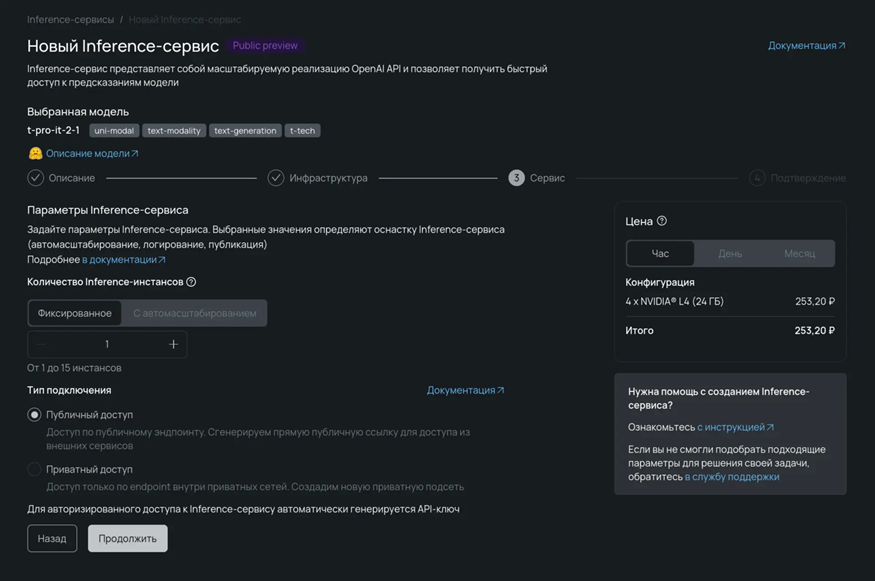
Конфигурацию после создания изменить нельзя, а количество инстансов можно масштабировать потом отдельно. Создание сервиса может занимать около 15 минут, так что наберитесь терпения и попейте кофейку.
Кстати, дополнительно можно взгромоздить WebUI. Но в моей задаче оно не требуется, поэтому этот шаг пропускаю.
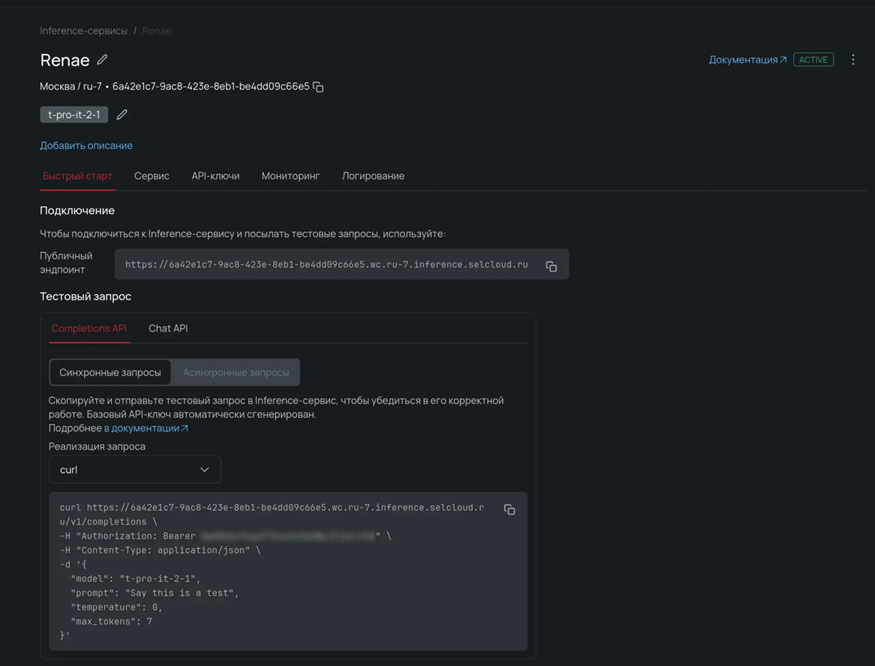
После запуска сервис выдал креды:
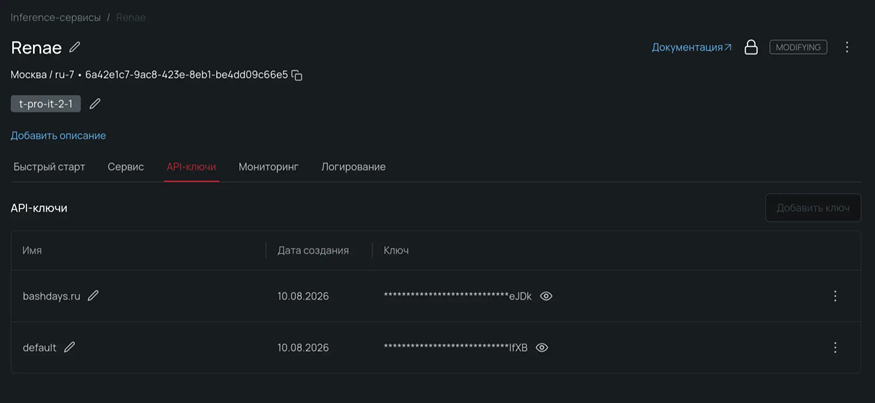
Для каждого инференс-сервиса используются отдельные API ключи. При создании первый ключ выпускается автоматически.
Создаем .env-файл и заполняем его полученными кредами:
      FMC_ENDPOINT=https://6a42e1c7-9ac8-423e-8eb1-be4dd09c66e5.wc.ru-7.inference.selcloud.ru
FMC_API_KEY=1234567890
FMC_MODEL=t-pro-it-2-1
И сразу добавляем его в .gitignore, API-ключу делать в Git нечего.
      .env
.venv/
__pycache__/
results/
Перед написанием приложения отправляем банальный запрос через curl, чтобы сразу все проверить и не городить огород с багами.
      curl https://6a42e1c7-9ac8-423e-8eb1-be4dd09c66e5.wc.ru-7.inference.selcloud.ru/v1/completions \
-H "Authorization: Bearer 1234567890" \
-H "Content-Type: application/json" \
-d '{
  "model": "t-pro-it-2-1",
  "prompt": "Say this is a test",
  "temperature": 0,
  "max_tokens": 7
}'
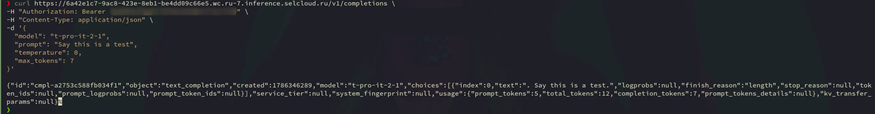
Тестовый запрос прошел, давайте сделаем еще один и смажем JQ:
      cd ~/dev/resume-matcher
source .env

curl -sS \
  "${FMC_ENDPOINT}/v1/chat/completions" \
  -H "Authorization: Bearer ${FMC_API_KEY}" \
  -H "Content-Type: application/json" \
  -d "{
	\"model\": \"${FMC_MODEL}\",
	\"temperature\": 0,
	\"max_tokens\": 700,
	\"messages\": [
  	{
    	\"role\": \"system\",
    	\"content\": \"Ты анализируешь профессиональный опыт из резюме.\"
  	},
  	{
    	\"role\": \"user\",
    	\"content\": \"Верни JSON с одним полем status и значением ok.\"
  	}
	]
  }" |
jq -r '.choices[0].message.content'
Ожидаемый результат получен, можно ехать дальше.
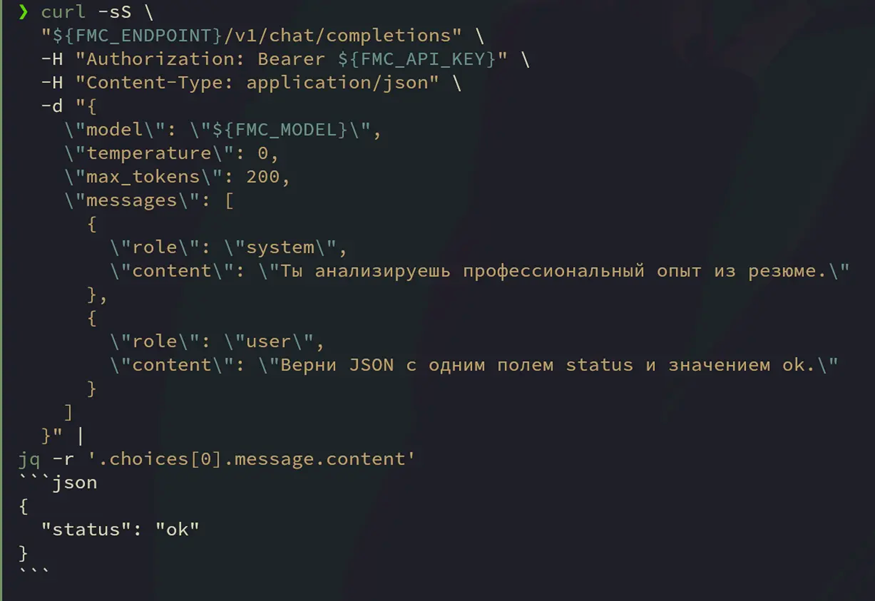
FMC поддерживает Chat API по адресу /v1/chat/completions, Bearer-авторизацию и ответы в формате OpenAI API. Эндпоинт, API-ключ и имя модели можно скопировать из панели управления.
Если получаете 401 Unauthorized, то проверяйте креды. Вот для этого тесты и нужны, чтобы потом вся задумка не превратилась в тыкву.
Теперь устанавливаем зависимости:
      python3 -m venv .venv
source .venv/bin/activate
Далее устанавливаем пакеты:
pip install pymupdf requests pydantic python-dotenv pyyaml jinja2
Набор пакетов я выбрал, потому, что:
- pymupdf извлекает текст из PDF,
- requests обращается к FMC,
- pydantic проверяет ответ модели,
- pyyaml читает описание вакансии,
- jinja2 формирует HTML-отчет,
- python-dotenv загружает настройки.
Дальше будет много кода. На роль Python-разработчика я не претендую, поэтому для профильного специалиста код может выглядеть как лапша. В любом случае код рабочий и меня он вполне устраивает.
Создаем src/pdf_parser.py:
      from __future__ import annotations

import re
from pathlib import Path
from typing import cast

import pymupdf as fitz


class PdfTextError(RuntimeError):
	pass


def normalize_text(text: str) -> str:
	text = text.replace("\u00a0", " ")
	text = text.replace("\u200b", "")
	text = text.replace("\xad", "")

	lines = [
    	re.sub(r"[ \t]+", " ", line).strip()
    	for line in text.splitlines()
	]

	text = "\n".join(lines)
	text = re.sub(r"\n{3,}", "\n\n", text)

	return text.strip()


def extract_pdf_text(pdf_path: Path) -> str:
	if not pdf_path.is_file():
    	raise FileNotFoundError(
        	f"PDF не найден: {pdf_path}"
    	)

	pages: list[str] = []

	try:
    	with fitz.open(pdf_path) as document:
        	if document.page_count == 0:
            	raise PdfTextError(
                	"В PDF нет страниц"
            	)

        	for page_index in range(
            	document.page_count
        	):
    	        page_number = page_index + 1
            	page = document.load_page(
                	page_index
            	)

            	page_text = cast(
                	str,
                	page.get_text(
                    	"text",
                    	sort=True,
                	),
            	)

            	page_text = normalize_text(
                	page_text
            	)

            	if not page_text:
                	continue

            	pages.append(
                	f"--- Страница {page_number} ---\n"
                	f"{page_text}"
            	)

	except fitz.FileDataError as error:
    	raise PdfTextError(
            f"Не удалось прочитать PDF: {error}"
    	) from error

	result = "\n\n".join(pages).strip()

	if len(result) < 300:
    	raise PdfTextError(
        	"Из PDF извлечено слишком мало текста. "
        	"Возможно, документ является сканом "
        	"без текстового слоя."
    	)

	return result
Проверяем:
      from pathlib import Path

from src.pdf_parser import extract_pdf_text


text = extract_pdf_text(
	Path("resumes/resume-001.pdf")
)

print(text[:1500])
В результате получаем:
      --- Страница 1 ---
 DevOps-инженер

 Опыт работы: 4 года

 ООО «Рога и копыта»
 DevOps-инженер
 Май 2022 — настоящее время

 Администрировал 60 виртуальных машин Ubuntu и Debian.
PyMuPDF не выполняет OCR. Если PDF состоит из отсканированных изображений, текстового слоя там может не быть. В этом случае я не отправляю пустой документ в модель, а помещаю резюме в очередь ручной проверки:
      extraction_quality: poor
verdict: manual_review
Теоретически можно подключить Tesseract или отдельную OCR-модель, но я предпочитаю, чтобы под один проект была одна модель. Поэтому в эксперименте я использую PDF с нормальным текстовым слоем.
Обезличиваем документ
В настоящем резюме содержатся персональные данные:
- имя;
- телефон;
- почта;
- адрес;
- дата рождения;
- ссылки на соцсети.
Для проверки профессионального соответствия они не нужны, да и трудовое законодательство запрещает ограничения и преимущества по обстоятельствам, не связанным с деловыми качествами кандидата. Это часть цитаты из Консультанта.
Создаем src/anonymizer.py:
      from __future__ import annotations
import re

EMAIL_PATTERN = re.compile(
	r"\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\.[A-Z]{2,}\b",
	flags=re.IGNORECASE,
)

PHONE_PATTERN = re.compile(
	r"(?<!\d)(?:\+7|8)"
	r"[\s\-()]*(?:\d[\s\-()]*){10}(?!\d)"
)

URL_PATTERN = re.compile(
	r"(?:https?://|www\.|t\.me/)\S+",
	flags=re.IGNORECASE,
)

SENSITIVE_LINE_PATTERN = re.compile(
	r"^(?:"
	r"дата рождения|"
	r"возраст|"
	r"пол|"
	r"семейное положение|"
	r"гражданство|"
	r"адрес|"
	r"место проживания"
	r")\s*:.*$",
	flags=re.IGNORECASE | re.MULTILINE,
)

def anonymize_resume(text: str) -> str:
	result = EMAIL_PATTERN.sub(
    	"[EMAIL REMOVED]",
    	text,
	)

	result = PHONE_PATTERN.sub(
    	"[PHONE REMOVED]",
    	result,
	)

	result = URL_PATTERN.sub(
    	"[LINK REMOVED]",
    	result,
	)

	result = SENSITIVE_LINE_PATTERN.sub(
    	"[PERSONAL DATA REMOVED]",
    	result,
	)

	return result
Оговорюсь, что здесь у меня демонстрационный фильтр, а не продакшен-система обезличивания. Фильтр удалит очевидный телефон и email, но может не распознать имя или необычно записанный адрес. В продакшене такой этап придется усиливать и отдельно проверять с юристами и специалистами по ИБ. Но для синтетических документов этого достаточно.
Описываем ожидаемый ответ
Создаем src/models.py:
      from __future__ import annotations
from typing import Literal
from pydantic import (
	BaseModel,
	Field,
	field_validator,
)


CriterionStatus = Literal[
	"confirmed",
	"partial",
	"not_found",
	"contradicted",
]

class CriterionAssessment(BaseModel):
	id: str

	level: int = Field(
    	ge=0,
    	le=4,
	)

	status: CriterionStatus

	evidence: list[str] = Field(
    	default_factory=list,
    	max_length=5,
	)

	comment: str = Field(
    	min_length=1,
    	max_length=800,
	)

	@field_validator("evidence")
	@classmethod
	def clean_evidence(
    	cls,
    	values: list[str],
	) -> list[str]:
    	result = []

    	for value in values:
        	value = value.strip()

        	if value and value not in result:
            	result.append(value)

    	return result

class ModelAssessment(BaseModel):
	candidate_summary: str = Field(
    	min_length=1,
    	max_length=1000,
	)

	extraction_quality: Literal[
    	"good",
    	"partial",
    	"poor",
	]

	criteria: list[CriterionAssessment]

	missing_required: list[str] = Field(
    	default_factory=list,
	)

	unclear_points: list[str] = Field(
   	 default_factory=list,
    	max_length=10,
	)

	interview_questions: list[str] = Field(
    	default_factory=list,
    	max_length=10,
	)

	short_reason: str = Field(
    	min_length=1,
    	max_length=1200,
	)
Библиотека pydantic проверяет:
- наличие всех полей,
- типы значений,
- диапазон уровня от 0 до 4,
- допустимые статусы,
- максимальное количество доказательств и вопросов.
Модель может вернуть вот такой результат:
      {
   "level": "отлично"
}
Тогда проверка завершится ошибкой.
Создаем промпт
Теперь пришло время создать промт. Создаем файл src/fmc_client.py и сначала пишем системную инструкцию:
      SYSTEM_PROMPT = """
Ты анализируешь соответствие профессионального опыта
из резюме требованиям конкретной вакансии.

Это не оценка личности кандидата и не окончательное
решение о найме или отказе.

Оценивай только сведения, которые явно присутствуют
в переданном тексте резюме.

Правила:

1. Не учитывай имя, пол, возраст, семейное положение,
   гражданство, адрес, фотографию и другие личные признаки.

2. Не придумывай опыт, которого нет в резюме.

3. Упоминание технологии без описания ее применения
   дает не более 1 балла.

4. Статус not_found означает только отсутствие
   подтверждения в тексте. Он не означает, что кандидат
   точно не обладает навыком.

5. Учитывай эквивалентные инструменты и подходы.
   Например:
   - SaltStack подтверждает опыт управления конфигурацией;
   - Argo CD подтверждает опыт автоматизации деплоя и GitOps;
   - Zabbix подтверждает опыт мониторинга.

6. Для каждого критерия приводи короткие дословные
   доказательства из резюме.

7. Не давай рекомендации по улучшению резюме.

8. Не принимай решение о найме или автоматическом отказе.

9. Не рассчитывай общий балл.

10. Верни только JSON без Markdown, вступления и пояснений.

Шкала уровня:

0 — в тексте нет подтверждения;
1 — технология только упомянута;
2 — подтвержден базовый практический опыт;
3 — подтвержден самостоятельный production-опыт;
4 — подтвержден сложный опыт, ответственность
	за результат или измеримое достижение.
""".strip()
Пользовательский промт будет содержать:
КРИТЕРИИ ВАКАНСИИ
…
ТЕКСТ РЕЗЮМЕ
…
ОЖИДАЕМАЯ JSON-СХЕМА
…
Так модель знает, какие именно поля мы будем проверять.
Запускаем FMC
Дополняем файл src/fmc_client.py:
      from __future__ import annotations

import json
import os
import re
import time

from typing import Any
import requests

from src.models import ModelAssessment

class FmcError(RuntimeError):
	pass

def extract_json_object(
	raw_content: str,
) -> dict[str, Any]:
	raw_content = raw_content.strip()

	raw_content = re.sub(
    	r"^```(?:json)?\s*",
    	"",
    	raw_content,
    	flags=re.IGNORECASE,
	)

	raw_content = re.sub(
    	r"\s*```$",
    	"",
    	raw_content,
	)

	start = raw_content.find("{")
	end = raw_content.rfind("}")

	if start == -1 or end == -1 or end < start:
    	raise FmcError(
        	"Модель не вернула JSON-объект"
    	)

	try:
    	parsed = json.loads(
        	raw_content[start:end + 1]
    	)
	except json.JSONDecodeError as error:
    	raise FmcError(
        	f"Некорректный JSON: {error}"
    	) from error

	if not isinstance(parsed, dict):
    	raise FmcError(
        	"Корнем ответа должен быть JSON-объект"
    	)

	return parsed

class FmcClient:
	def __init__(self) -> None:
    	self.endpoint = os.environ[
        	"FMC_ENDPOINT"
    	].rstrip("/")

    	self.api_key = os.environ[
        	"FMC_API_KEY"
    	]

    	self.model = os.environ[
        	"FMC_MODEL"
    	]

    	self.session = requests.Session()

    	self.session.headers.update(
        	{
            	"Authorization": (
                	f"Bearer {self.api_key}"
            	),
            	"Content-Type": (
                	"application/json"
            	),
        	}
    	)

	def analyze(
    	self,
    	vacancy: dict[str, Any],
    	resume_text: str,
	) -> tuple[ModelAssessment, float]:
    	response_schema = (
        	ModelAssessment.model_json_schema()
    	)

    	user_prompt = (
        	"КРИТЕРИИ ВАКАНСИИ:\n"
        	+ json.dumps(
            	vacancy,
            	ensure_ascii=False,
            	indent=2,
        	)
        	+ "\n\nТЕКСТ РЕЗЮМЕ:\n"
        	+ resume_text
        	+ "\n\nОЖИДАЕМАЯ JSON-СХЕМА:\n"
        	+ json.dumps(
            	response_schema,
            	ensure_ascii=False,
            	indent=2,
        	)
    	)

    	payload = {
        	"model": self.model,
        	"temperature": 0,
        	"max_tokens": 700,
        	"messages": [
            	{
                	"role": "system",
                	"content": SYSTEM_PROMPT,
            	},
            	{
                	"role": "user",
                	"content": user_prompt,
            	},
        	],
        }

    	started = time.perf_counter()

    	response = self.session.post(
        	(
            	f"{self.endpoint}"
            	"/v1/chat/completions"
        	),
        	json=payload,
        	timeout=240,
    	)

  	  elapsed = (
        	time.perf_counter()
        	- started
    	)

    	if not response.ok:
        	raise FmcError(
            	f"FMC API error "
            	f"{response.status_code}: "
            	f"{response.text}"
        	)

    	try:
        	response_payload = (
            	response.json()
        	)

        	raw_content = (
            	response_payload["choices"][0]
            	["message"]["content"]
        	)

    	except (
            ValueError,
        	KeyError,
        	IndexError,
        	TypeError,
    	) as error:
        	raise FmcError(
            	"Не удалось разобрать ответ FMC"
        	) from error

    	parsed = extract_json_object(
        	raw_content
    	)

    	assessment = (
        	ModelAssessment.model_validate(
            	parsed
        	)
    	)

    	return assessment, elapsed
Параметр temperature я устанавливаю в ноль, чтобы снизить случайность ответа.
Но даже при нулевой температуре полная повторяемость не гарантируется. Поэтому позже отдельно проверим стабильность на нескольких запусках.
Не доверяем цитатам модели
В ответе модель должна приводить доказательства из резюме. Но что мешает ей меня обмануть или вообще придумать красивую цитату? Чтобы избежать этого, создаем функцию:
      import re
from dataclasses import dataclass

from src.models import ModelAssessment

@dataclass
class EvidenceCheck:
	total: int
	matched: int
	missing: list[str]

def normalize_for_matching(
	text: str,
) -> str:
	text = text.lower()
	text = text.replace("ё", "е")
	text = re.sub(r"\s+", " ", text)

	return text.strip()

def check_evidence(
	resume_text: str,
	assessment: ModelAssessment,
) -> EvidenceCheck:
	normalized_resume = (
    	normalize_for_matching(
        	resume_text
    	)
	)

	total = 0
	matched = 0
	missing: list[str] = []

	for criterion in assessment.criteria:
        for evidence in criterion.evidence:
        	total += 1

        	normalized_evidence = (
            	normalize_for_matching(
                	evidence
            	)
        	)

        	if (
            	normalized_evidence
            	in normalized_resume
        	):
            	matched += 1
        	else:
            	missing.append(evidence)

	return EvidenceCheck(
    	total=total,
    	matched=matched,
   	 missing=missing,
	)
Если модель вернула Самостоятельно спроектировал Kubernetes-кластер, а в резюме такой строки нет, доказательство помечается как неподтвержденное. Это не идеальная проверка: модель может убрать знак препинания или сократить цитату. Но для первого варианта я специально сделал дословные фрагменты, чтобы результат можно было проверить обычным поиском по строке.
Считаем итоговый балл
Создаем файл src/scoring.py:
      from __future__ import annotations
from typing import Any
from src.models import ModelAssessment

def calculate_result(
	vacancy: dict[str, Any],
	assessment: ModelAssessment,
) -> dict[str, Any]:
	criteria_config = {
    	item["id"]: item
    	for item in vacancy["criteria"]
	}

	model_results = {
    	item.id: item
    	for item in assessment.criteria
	}

	weighted_score = 0.0
	required_gaps: list[str] = []
	criterion_results = []

	for criterion_id, config in (
    	criteria_config.items()
	):
 	   model_result = (
        	model_results.get(
            	criterion_id
        	)
    	)

    	if model_result is None:
        	level = 0
        	status = "not_found"
        	evidence: list[str] = []
        	comment = (
            	"Модель не вернула "
            	"оценку критерия"
        	)
    	else:
        	level = model_result.level
        	status = model_result.status
        	evidence = model_result.evidence
    	    comment = model_result.comment

    	weight = int(config["weight"])

    	points = (
        	weight * level / 4
    	)

    	weighted_score += points

    	if (
        	bool(config["required"])
        	and level < 2
    	):
        	required_gaps.append(
            	criterion_id
        	)

    	criterion_results.append(
        	{
            	"id": criterion_id,
            	"title": config["title"],
            	"required": bool(
                	config["required"]
            	),
            	"weight": weight,
            	"level": level,
            	"status": status,
            	"points": round(
                	points,
                	2,
          	  ),
            	"evidence": evidence,
            	"comment": comment,
        	}
    	)

	fit_score = round(
    	weighted_score
	)

	if (
    	assessment.extraction_quality
    	!= "good"
	):
    	verdict = "manual_review"

	elif (
    	fit_score >= 75
    	and not required_gaps
	):
    	verdict = "match"

	elif (
    	fit_score >= 50
    	and len(required_gaps) <= 1
	):
    	verdict = "manual_review"

	else:
    	verdict = "no_match"

	return {
    	"fit_score": fit_score,
    	"verdict": verdict,
    	"candidate_summary": (
        	assessment.candidate_summary
    	),
    	"criteria": criterion_results,
    	"required_gaps": required_gaps,
    	"unclear_points": (
        	assessment.unclear_points
    	),
    	"interview_questions": (
        	assessment.interview_questions
    	),
    	"short_reason": (
        	assessment.short_reason
    	),
    	"extraction_quality": (
        	assessment.extraction_quality
    	),
	}
Как трактовать результаты:
match— в резюме достаточно подтверждений, чтобы посмотреть кандидата в приоритетном порядке.manual_review— есть спорные места, проблемы с извлечением текста или неполное покрытие требований. Такое резюме нужно проверить вручную.no_match— в документе недостаточно подтверждений по текущему профилю вакансии.
В общем, no_match не должен автоматически отправлять кандидату отказ. Это результат сопоставления текста с конкретной рубрикой, который HR может проверить и изменить.
Загружаем вакансию
      from __future__ import annotations
from pathlib import Path
from typing import Any

import yaml

def load_vacancy(
	path: Path,
) -> dict[str, Any]:
	with path.open(
    	encoding="utf-8"
	) as file:
    	vacancy = yaml.safe_load(
        	file
    	)

	if not isinstance(vacancy, dict):
    	raise ValueError(
        	"Вакансия должна быть "
        	"YAML-объектом"
    	)

	criteria = vacancy.get(
    	"criteria"
	)

	if not isinstance(criteria, list):
    	raise ValueError(
        	"В вакансии отсутствует "
        	"список criteria"
    	)

	weight_sum = sum(
    	int(item["weight"])
    	for item in criteria
	)

	if weight_sum != 100:
    	raise ValueError(
        	"Сумма весов критериев "
        	f"должна быть 100, сейчас: "
        	f"{weight_sum}"
    	)

	return vacancy
Проверка суммы весов спасет от ситуации, когда после добавления нового критерия максимальный результат становится 115 из 100. Нам такое, естественно, не подходит, поэтому тут лучше переборщить со внимательностью к деталям.
Собираем HTML-отчет
Создаем templates/report.html:
      <!doctype html>
<html lang="ru">
<head>
  <meta charset="utf-8">

  <meta
	name="viewport"
	content="width=device-width, initial-scale=1"
  >

  <title>
	{{ candidate_id }} — проверка вакансии
  </title>

  <style>
	:root {
  	color-scheme: dark;

  	--background: #080a0f;
  	--panel: #0d1016;
  	--panel-light: #151920;
  	--border: #303640;
  	--text: #e5e7eb;
  	--muted: #a4a9b3;
  	--accent: #c9ff35;
  	--warning: #ffca58;
  	--danger: #ff7070;
	}

	* {
  	box-sizing: border-box;
	}

	body {
  	margin: 0;
  	padding: 40px 24px;
  	color: var(--text);
  	background: var(--background);
  	font-family:
    	Inter,
    	system-ui,
    	-apple-system,
    	sans-serif;
  	line-height: 1.55;
	}

	main {
  	max-width: 1280px;
  	margin: 0 auto;
	}

	h1,
	h2,
	h3 {
  	margin-top: 0;
	}

	h1 {
  	margin-bottom: 8px;
  	font-size: 32px;
	}

	.muted {
  	color: var(--muted);
    }

	.summary-grid {
  	display: grid;
  	grid-template-columns:
    	repeat(3, minmax(0, 1fr));
  	gap: 16px;
  	margin: 32px 0;
	}

	.card {
  	padding: 24px;
  	border: 1px solid var(--border);
  	background: var(--panel);
	}

	.card__label {
  	color: var(--muted);
  	font-size: 13px;
  	text-transform: uppercase;
  	letter-spacing: 0.08em;
	}

	.card__value {
  	margin-top: 10px;
  	color: var(--accent);
  	font-family: monospace;
	  font-size: 30px;
  	font-weight: 700;
	}

	table {
  	width: 100%;
  	border-collapse: collapse;
  	margin: 32px 0;
  	background: var(--panel);
	}

	th,
	td {
  	padding: 18px;
  	border-bottom:
    	1px solid var(--border);
  	text-align: left;
  	vertical-align: top;
	}

	th {
  	color: var(--muted);
  	background: var(--panel-light);
  	font-size: 12px;
  	text-transform: uppercase;
  	letter-spacing: 0.06em;
	}

	.points {
  	color: var(--accent);
  	font-family: monospace;
  	font-weight: 700;
  	white-space: nowrap;
	}

	.status {
  	display: inline-block;
  	padding: 4px 9px;
  	border: 1px solid var(--border);
  	font-family: monospace;
  	font-size: 12px;
	}

	.status--confirmed {
  	color: var(--accent);
	}

	.status--partial {
  	color: var(--warning);
	}

	.status--not_found,
	.status--contradicted {
  	color: var(--danger);
	}

	.evidence {
  	margin: 10px 0 0;
  	padding-left: 20px;
  	color: var(--muted);
	}

	.two-columns {
  	display: grid;
  	grid-template-columns:
    	repeat(2, minmax(0, 1fr));
  	gap: 24px;
  	margin-top: 32px;
	}

	.list {
  	margin: 0;
  	padding-left: 24px;
	}

	.list li + li {
  	margin-top: 12px;
	}

	.verdict {
  	color: var(--accent);
  	font-size: 20px;
  	font-weight: 700;
	}

	@media (max-width: 800px) {
  	.summary-grid,
  	.two-columns {
    	grid-template-columns: 1fr;
  	}

  	body {
    	padding: 24px 12px;
  	}

  	th,
  	td {
    	padding: 12px;
  	}
	}
  </style>
</head>

<body>
<main>
  <h1>Соответствие вакансии</h1>

  <p class="muted">
	{{ vacancy_title }} · {{ candidate_id }}
  </p>

  <div class="summary-grid">
	<section class="card">
  	<div class="card__label">
    	Итоговый балл
  	</div>

  	<div class="card__value">
        {{ result.fit_score }}/100
  	</div>
	</section>

	<section class="card">
  	<div class="card__label">
    	Результат
  	</div>

  	<div class="card__value">
    	{{ result.verdict }}
  	</div>
	</section>

	<section class="card">
  	<div class="card__label">
    	Время обработки
  	</div>

  	<div class="card__value">
    	{{ "%.2f"|format(latency) }} с
  	</div>
	</section>
  </div>

  <section class="card">
	<h2>Краткая выжимка</h2>

	<p>
  	{{ result.candidate_summary }}
	</p>

	<p class="muted">
  	{{ result.short_reason }}
	</p>
  </section>

  <table>
	<thead>
  	<tr>
    	<th>Критерий</th>
    	<th>Статус</th>
    	<th>Баллы</th>
    	<th>Доказательства</th>
  	</tr>
	</thead>

	<tbody>
	{% for criterion in result.criteria %}
  	<tr>
    	<td>
      	<strong>
        	{{ criterion.title }}
      	</strong>

      	{% if criterion.required %}
        	<div class="muted">
          	Обязательный критерий
        	</div>
      	{% endif %}
    	</td>

    	<td>
      	<span
        	class="
          	status
          	status--{{ criterion.status }}
        	"
      	>
        	{{ criterion.status }}
      	</span>

      	<p class="muted">
        	{{ criterion.comment }}
      	</p>
    	</td>

    	<td class="points">
      	{{ criterion.points }}
      	/
      	{{ criterion.weight }}
        </td>

    	<td>
      	{% if criterion.evidence %}
        	<ul class="evidence">
        	{% for evidence in criterion.evidence %}
          	<li>{{ evidence }}</li>
        	{% endfor %}
        	</ul>
      	{% else %}
            <span class="muted">
          	Подтверждение не найдено
        	</span>
      	{% endif %}
    	</td>
  	</tr>
	{% endfor %}
	</tbody>
  </table>

  <div class="two-columns">
	<section class="card">
  	<h2>Что надо уточнить</h2>

  	{% if result.unclear_points %}
    	<ul class="list">
    	{% for item in result.unclear_points %}
      	<li>{{ item }}</li>
    	{% endfor %}
    	</ul>
  	{% else %}
    	<p class="muted">
      	Явных спорных мест не найдено.
    	</p>
  	{% endif %}
	</section>

	<section class="card">
  	<h2>Вопросы на интервью</h2>

  	{% if result.interview_questions %}
    	<ul class="list">
    	{% for question in result.interview_questions %}
      	<li>{{ question }}</li>
    	{% endfor %}
    	</ul>
  	{% else %}
    	<p class="muted">
      	Вопросы не сформированы.
    	</p>
  	{% endif %}
	</section>
  </div>
</main>
</body>
</html>
Рендерим отчет
Создаем src/report.py:
      from __future__ import annotations
from pathlib import Path
from typing import Any
from jinja2 import (
	Environment,
	FileSystemLoader,
	select_autoescape,
)


def render_report(
	candidate_id: str,
	vacancy_title: str,
	result: dict[str, Any],
	latency: float,
	output_path: Path,
) -> None:
	environment = Environment(
    	loader=FileSystemLoader(
        	"templates"
    	),
    	autoescape=select_autoescape(
        	["html", "xml"]
    	),
	)

	template = environment.get_template(
    	"report.html.j2"
	)

	html = template.render(
    	candidate_id=candidate_id,
    	vacancy_title=vacancy_title,
    	result=result,
    	latency=latency,
	)

	output_path.parent.mkdir(
    	parents=True,
    	exist_ok=True,
	)

	output_path.write_text(
    	html,
    	encoding="utf-8",
	)
Собираем все в один запуск
Создаем src/main.py:
      from __future__ import annotations
import argparse
import csv
import json
from pathlib import Path
from typing import Any
from dotenv import load_dotenv
from src.anonymizer import (
	anonymize_resume,
)
from src.fmc_client import (
	FmcClient,
	FmcError,
)
from src.pdf_parser import (
	PdfTextError,
	extract_pdf_text,
)
from src.report import render_report
from src.scoring import (
	calculate_result,
)

def load_vacancy(
	path: Path,
) -> dict[str, Any]:
	import yaml

	with path.open(
    	encoding="utf-8"
	) as file:
    	vacancy = yaml.safe_load(
        	file
    	)

	if not isinstance(vacancy, dict):
    	raise ValueError(
        	"Вакансия должна быть "
        	"YAML-объектом"
    	)

	criteria = vacancy.get(
    	"criteria"
	)

    if not isinstance(criteria, list):
    	raise ValueError(
        	"В вакансии нет criteria"
    	)

	weight_sum = sum(
    	int(item["weight"])
    	for item in criteria
	)

	if weight_sum != 100:
    	raise ValueError(
        	"Сумма весов должна быть 100, "
        	f"сейчас: {weight_sum}"
    	)

	return vacancy


def save_json(
	path: Path,
	payload: dict[str, Any],
) -> None:
	path.parent.mkdir(
    	parents=True,
    	exist_ok=True,
	)

	path.write_text(
    	json.dumps(
        	payload,
        	ensure_ascii=False,
        	indent=2,
    	),
    	encoding="utf-8",
	)

def write_summary_csv(
	rows: list[dict[str, Any]],
	output_path: Path,
) -> None:
	output_path.parent.mkdir(
    	parents=True,
    	exist_ok=True,
	)

	with output_path.open(
    	"w",
    	encoding="utf-8",
    	newline="",
	) as file:
    	writer = csv.DictWriter(
  	      file,
        	fieldnames=[
            	"candidate_id",
            	"fit_score",
            	"verdict",
            	"latency_seconds",
            	"required_gaps",
            	"error",
        	],
    	)

    	writer.writeheader()
    	writer.writerows(rows)


def process_resume(
	pdf_path: Path,
	vacancy: dict[str, Any],
	client: FmcClient,
	results_dir: Path,
) -> dict[str, Any]:
	candidate_id = pdf_path.stem

	try:
    	raw_text = extract_pdf_text(
        	pdf_path
    	)

    	clean_text = anonymize_resume(
        	raw_text
    	)

    	assessment, latency = (
        	client.analyze(
            	vacancy=vacancy,
            	resume_text=clean_text,
        	)
    	)

    	result = calculate_result(
        	vacancy=vacancy,
        	assessment=assessment,
    	)

    	result["candidate_id"] = (
        	candidate_id
    	)

    	result["source_file"] = (
        	pdf_path.name
    	)

    	result["latency_seconds"] = (
        	round(latency, 3)
    	)

    	save_json(
        	(
            	results_dir
            	/ f"{candidate_id}.json"
        	),
        	result,
        )

    	render_report(
        	candidate_id=candidate_id,
        	vacancy_title=vacancy["title"],
        	result=result,
        	latency=latency,
        	output_path=(
            	results_dir
            	/ f"{candidate_id}.html"
        	),
    	)

    	return {
        	"candidate_id": candidate_id,
        	"fit_score": result["fit_score"],
        	"verdict": result["verdict"],
        	"latency_seconds": round(
            	latency,
            	3,
        	),
        	"required_gaps": ",".join(
            	result["required_gaps"]
        	),
        	"error": "",
    	}

	except (
    	PdfTextError,
    	FmcError,
    	ValueError,
	) as error:
    	return {
        	"candidate_id": candidate_id,
        	"fit_score": "",
        	"verdict": "manual_review",
        	"latency_seconds": "",
        	"required_gaps": "",
        	"error": str(error),
    	}


def main() -> None:
	load_dotenv()

	parser = argparse.ArgumentParser()

	parser.add_argument(
    	"--vacancy",
    	type=Path,
    	required=True,
	)

	parser.add_argument(
    	"--resumes",
    	type=Path,
    	required=True,
	)

	parser.add_argument(
    	"--results",
    	type=Path,
    	default=Path("results"),
	)

	args = parser.parse_args()

	vacancy = load_vacancy(
    	args.vacancy
	)

	pdf_files = sorted(
    	args.resumes.glob("*.pdf")
	)

	if not pdf_files:
    	raise RuntimeError(
        	"В каталоге нет PDF"
    	)

	client = FmcClient()

	summary_rows = []

	for number, pdf_path in enumerate(
    	pdf_files,
    	start=1,
	):
    	print(
        	f"[{number}/{len(pdf_files)}] "
        	f"{pdf_path.name}"
    	)

    	row = process_resume(
        	pdf_path=pdf_path,
        	vacancy=vacancy,
        	client=client,
        	results_dir=args.results,
    	)

    	summary_rows.append(row)

    	print(
        	f"  verdict={row['verdict']} "
        	f"score={row['fit_score']}"
    	)

	write_summary_csv(
    	summary_rows,
    	args.results / "summary.csv",
	)


if __name__ == "__main__":
	main()
Итого получаем такую структуру:
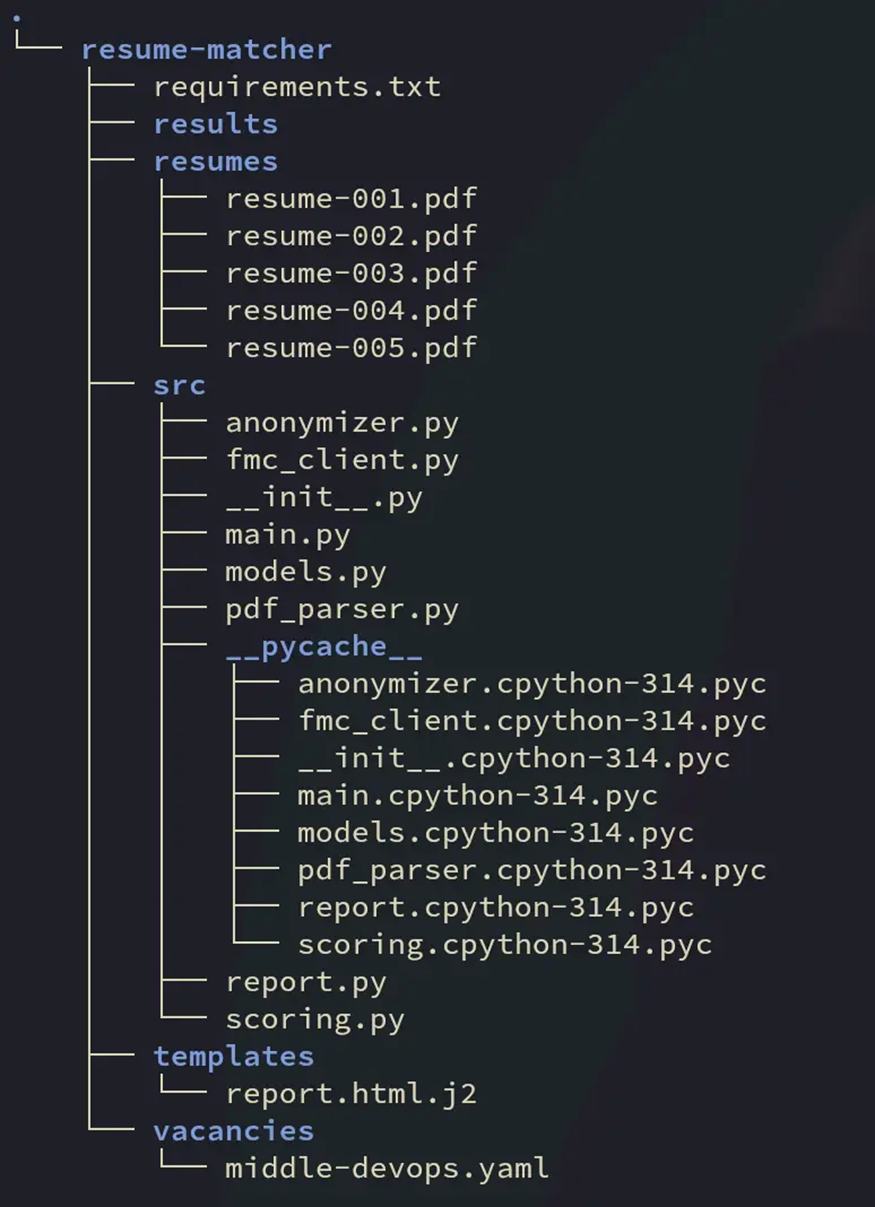
Запускаем сервис
      source .venv/bin/activate

python3 -m src.main --vacancy vacancies/middle-devops.yaml --resumes resumes --results results
Спустя пару минут, в папке results видим новые файлы и сам результат в консоли:
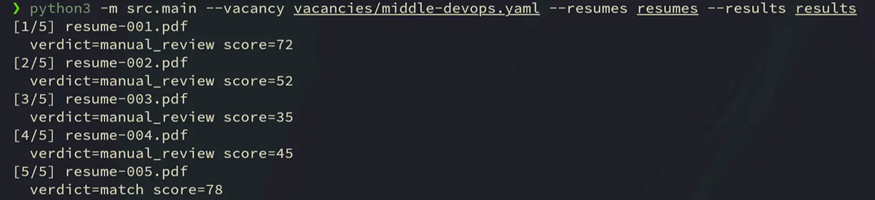
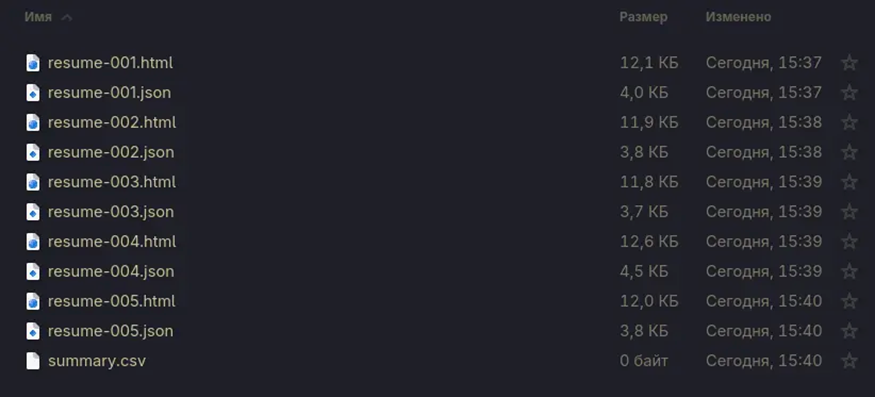
Можно сказать, это успех. Оно работает! Теперь можно посмотреть красивые отчеты по каждому резюме:
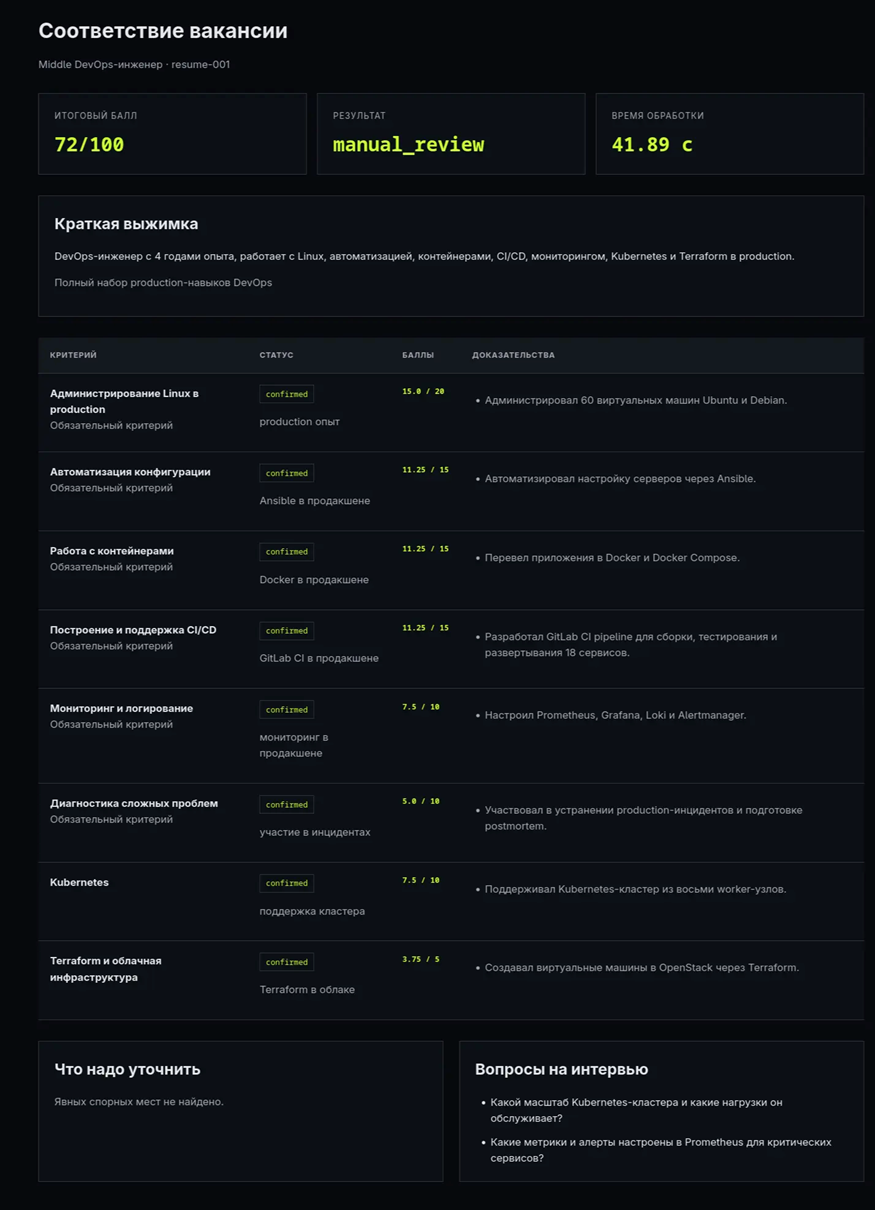
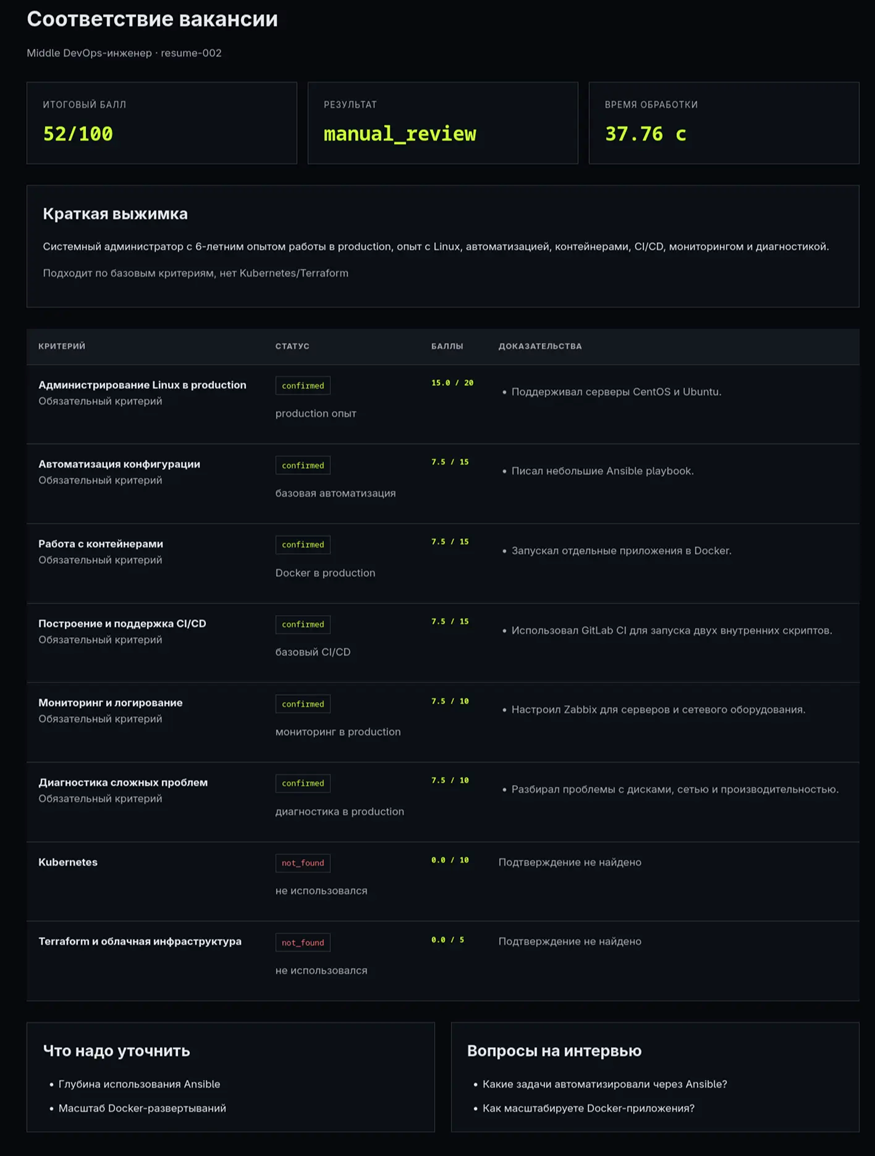
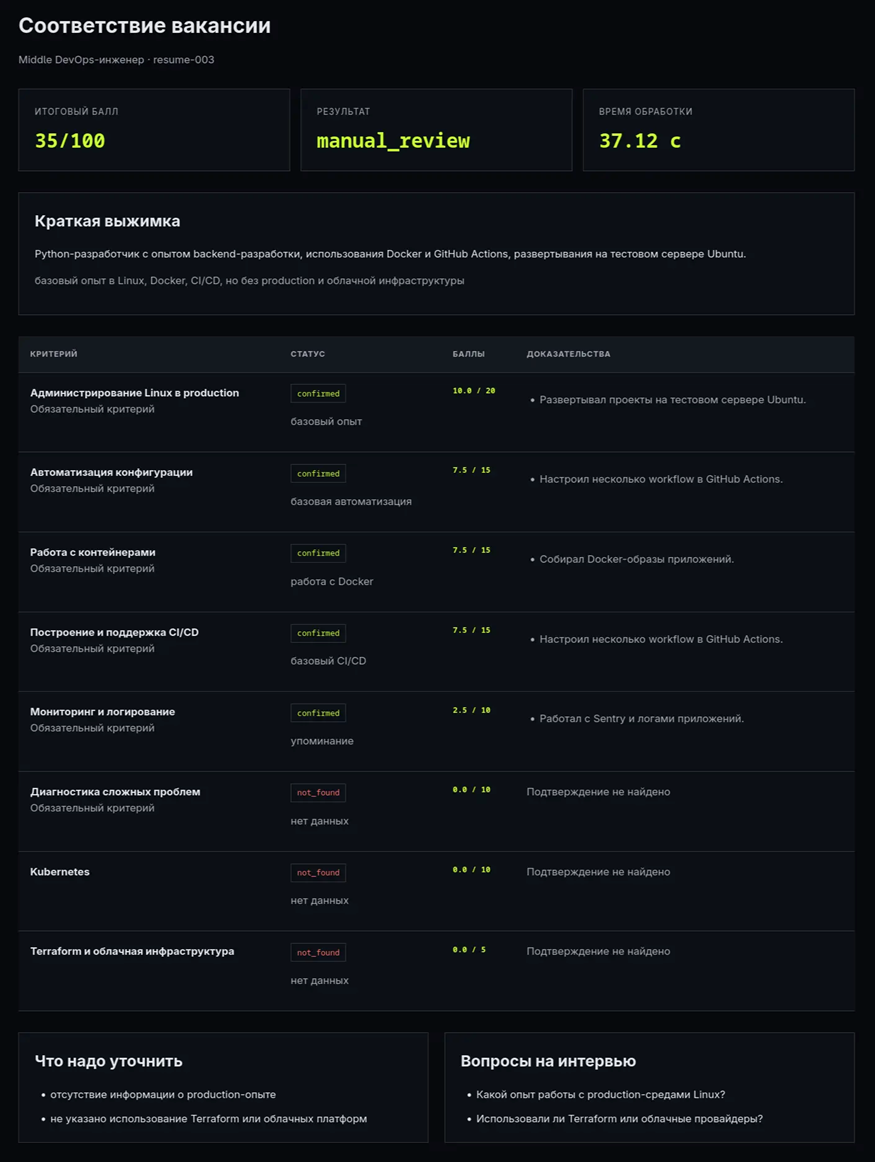
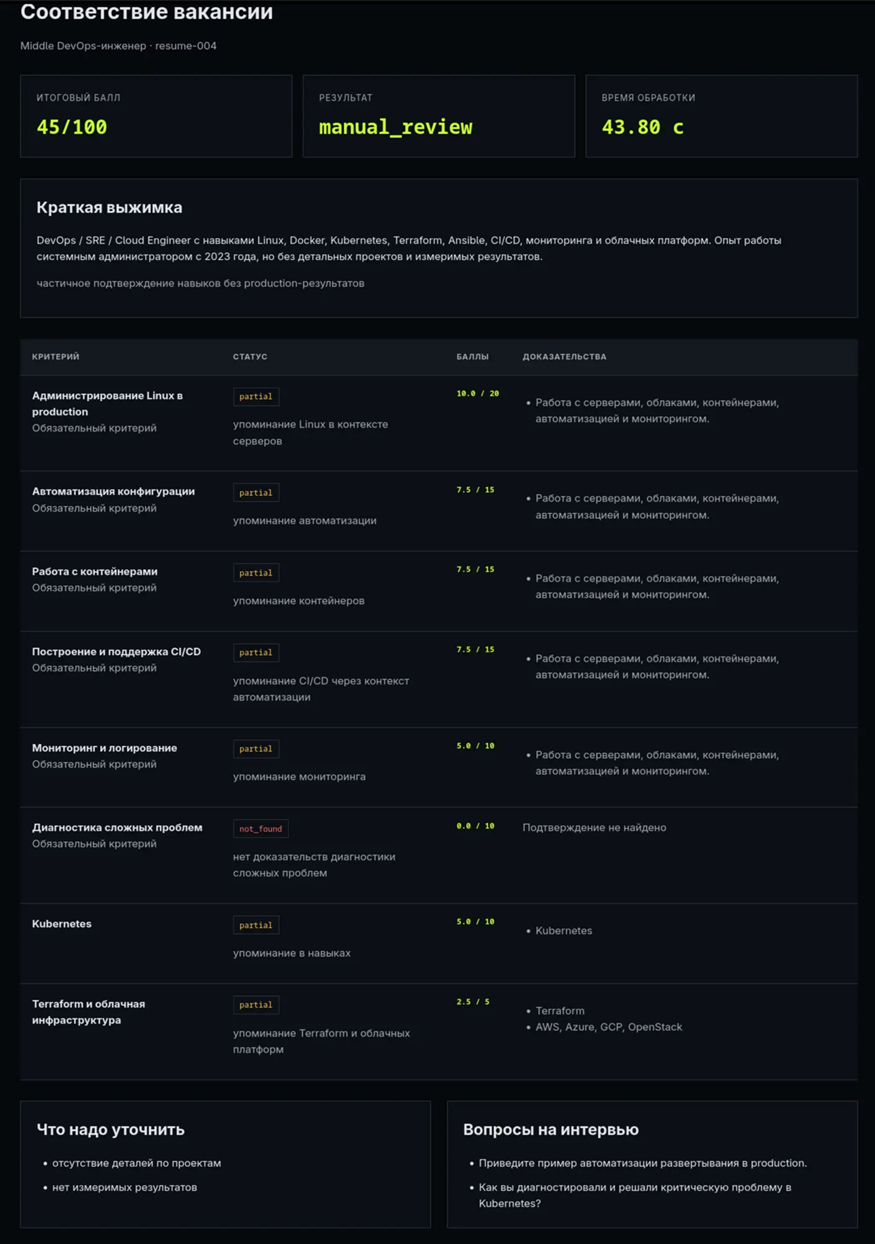
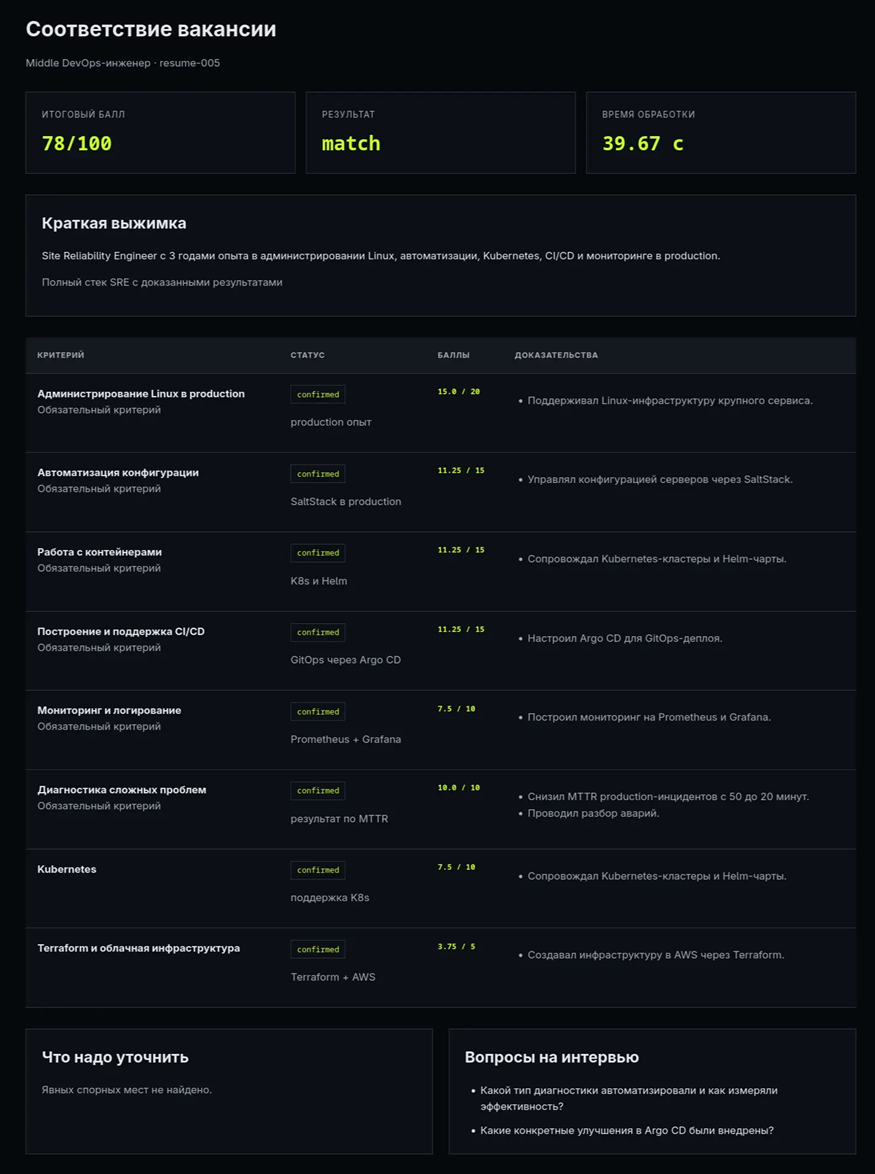
Не стал бы утверждать, что это прям готовая ATS, которую можно внедрять к себе в CRM и пачками отсеивать вайбкодеров.
Вот что получается по кандидату №5, который набрал 78 баллов:
      {
  "fit_score": 78,
  "verdict": "match",
  "candidate_summary": "Site Reliability Engineer с 3 годами опыта в администрировании Linux, автоматизации, Kubernetes, CI/CD и мониторинге в production.",
  "criteria": [
	{
  	"id": "linux_production",
  	"title": "Администрирование Linux в production",
  	"required": true,
  	"weight": 20,
  	"level": 3,
  	"status": "confirmed",
  	"points": 15.0,
  	"evidence": [
    	"Поддерживал Linux-инфраструктуру крупного сервиса."
  	],
  	"comment": "production опыт"
	},
	{
  	"id": "automation",
  	"title": "Автоматизация конфигурации",
  	"required": true,
  	"weight": 15,
  	"level": 3,
  	"status": "confirmed",
  	"points": 11.25,
  	"evidence": [
    	"Управлял конфигурацией серверов через SaltStack."
  	],
  	"comment": "SaltStack в production"
	},
	{
  	"id": "containers",
  	"title": "Работа с контейнерами",
  	"required": true,
  	"weight": 15,
  	"level": 3,
  	"status": "confirmed",
  	"points": 11.25,
  	"evidence": [
    	"Сопровождал Kubernetes-кластеры и Helm-чарты."
  	],
  	"comment": "K8s и Helm"
	},
	{
  	"id": "ci_cd",
  	"title": "Построение и поддержка CI/CD",
  	"required": true,
  	"weight": 15,
  	"level": 3,
  	"status": "confirmed",
  	"points": 11.25,
  	"evidence": [
    	"Настроил Argo CD для GitOps-деплоя."
  	],
  	"comment": "GitOps через Argo CD"
	},
	{
  	"id": "monitoring",
  	"title": "Мониторинг и логирование",
  	"required": true,
  	"weight": 10,
  	"level": 3,
  	"status": "confirmed",
  	"points": 7.5,
  	"evidence": [
    	"Построил мониторинг на Prometheus и Grafana."
  	],
  	"comment": "Prometheus + Grafana"
	},
	{
  	"id": "troubleshooting",
  	"title": "Диагностика сложных проблем",
  	"required": true,
  	"weight": 10,
  	"level": 4,
  	"status": "confirmed",
  	"points": 10.0,
  	"evidence": [
    	"Снизил MTTR production-инцидентов с 50 до 20 минут.",
    	"Проводил разбор аварий."
  	],
  	"comment": "результат по MTTR"
	},
	{
  	"id": "kubernetes",
  	"title": "Kubernetes",
  	"required": false,
  	"weight": 10,
  	"level": 3,
  	"status": "confirmed",
  	"points": 7.5,
  	"evidence": [
    	"Сопровождал Kubernetes-кластеры и Helm-чарты."
  	],
  	"comment": "поддержка K8s"
	},
	{
  	"id": "terraform_cloud",
  	"title": "Terraform и облачная инфраструктура",
  	"required": false,
  	"weight": 5,
  	"level": 3,
  	"status": "confirmed",
  	"points": 3.75,
  	"evidence": [
    	"Создавал инфраструктуру в AWS через Terraform."
  	],
  	"comment": "Terraform + AWS"
	}
  ],
  "required_gaps": [],
  "unclear_points": [],
  "interview_questions": [
    "Какой тип диагностики автоматизировали и как измеряли эффективность?",
    "Какие конкретные улучшения в Argo CD были внедрены?"
  ],
  "short_reason": "Полный стек SRE с доказанными результатами",
  "extraction_quality": "good",
  "candidate_id": "resume-005",
  "source_file": "resume-005.pdf",
  "latency_seconds": 39.67
}
Рисуем табличку, чтобы нагляднее было:
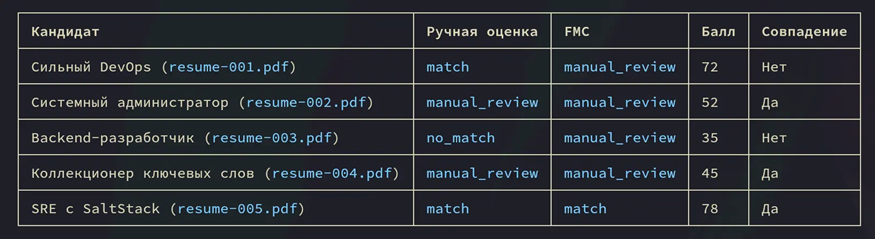
Итого: 2 совпадения из 5 (40%). два кандидата получили match, два отправлены на ручную проверку и один получил no_match. При этом модель не спрятала потенциально подходящих кандидатов в no_match, выбрав для спорных случаев более осторожный manual_review. Идем уверенно!
Самые интересные здесь два последних резюме. Кандидат №4 проверяет, даст ли модель высокий балл за красивый список технологий без доказательств. Кандидат №5 показывает, способна ли модель учитывать альтернативный стек, а не искать только точные совпадения с вакансией.
Проверяем стабильность
Одно и то же резюме прогоняю пять раз:
      for run in {1..5}; do
  mkdir -p "results/run-$run"

  python3 -m src.main \
	--vacancy vacancies/middle-devops.yaml \
	--resumes resumes-one \
	--results "results/run-$run"
done
Сравниваю итоговый балл, verdict, уровни критериев, доказательства и вопросы для интервью.
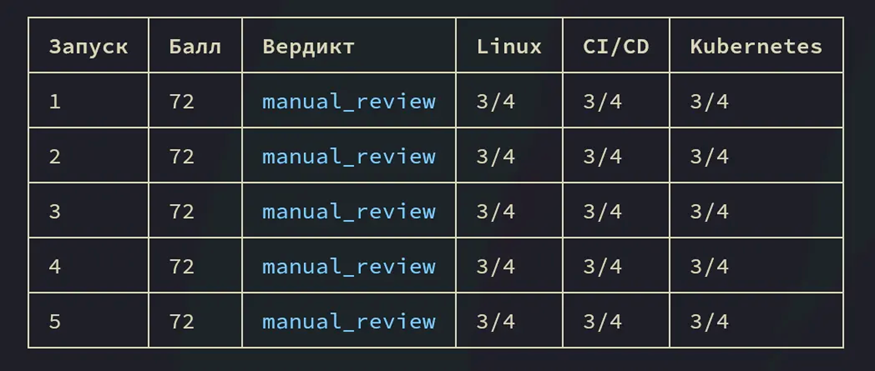
Результат полностью стабилен:
- разброс 0 баллов,
- совпадение вердиктов 5 из 5,
- уровни всех критериев совпали,
- доказательства совпали дословно,
- вопросы для интервью совпали дословно.
Тут важно, что если балл гуляет на два-три пункта, с этим еще можно жить. Если один запуск говорит match, а другой no_match, такой инструмент использовать нельзя, пока не будет стабильности. Тоже учитывай этот момент.
Больше инструкций по работе с ИИ:
Что еще можно измерить
Валидность JSON
valid_json_rate = успешно проверенные ответы / все ответы. То есть, например,
при 49 валидных ответах из 50 valid_json_rate = 98%.
Достоверность доказательств
evidence_match_rate = дословно найденные цитаты / все цитаты. Если модель придумала цитату, результат должен быть помечен для ручной проверки.
Время обработки
Для каждого PDF сохраняется latency_seconds:
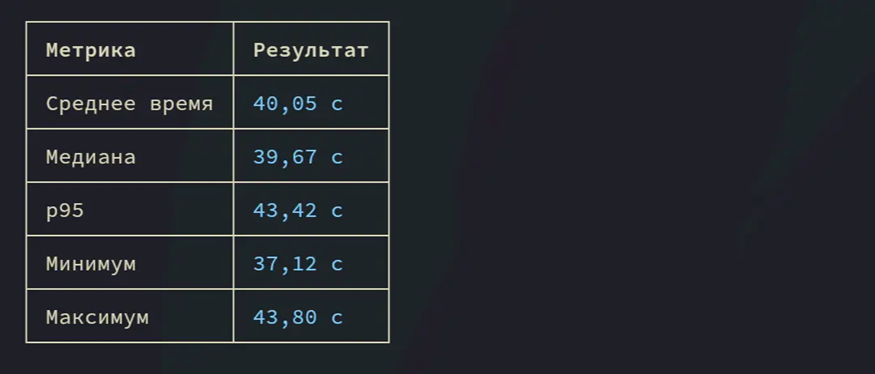
Оценка времени для 400 резюме
При последовательной обработке общее время будет равно среднему времени на проверку одного резюме × 400. То есть если одно резюме обрабатывается 12 секунд, то 12 × 400 = 4 800 секунд ≈ 80 минут. Но это пока только арифметическая оценка.
Реальное время зависит от размера резюме, конфигурации инференс-сервиса, нагрузки, количества одновременных запросов, лимитов сервиса и повторных запросов после ошибок.
После последовательного теста можно аккуратно добавить два или четыре worker-потока и сравнить throughput. Сразу запускать 50 параллельных запросов только потому, что это все надо срочно и вчера — плохая идея.
Ложные отрицательные результаты
Главный вопрос для такой системы — не спрятали ли мы сильного кандидата в хвост выдачи? Если HR вручную отметил 20 подходящих кандидатов, а система поместила 18 из них в приоритетную очередь, то recall = 18 / 20 = 0.9.
В этом сценарии лучше показать человеку несколько лишних резюме, чем потерять одного подходящего специалиста. Поэтому пороги я бы настраивал в сторону manual_review, а не агрессивного no_match. Если опасаетесь, что это будет слишком затратно для бюджета на инфраструктуру, то нет. FMC использует модель оплаты по потреблению облачных ресурсов, а не токенов. То есть средства списываются за ресурсы инференс-сервера: GPU, vCPU, RAM и диск, а количество токенов отдельно не тарифицируется.
Здесь еще важный момент в том, что модель оценивает не только ключевые слова. Это важно, чтобы сильный SRE-инженер с SaltStack и Argo CD не получил ноль баллов за отсутствие Ansible и GitLab CI. К тому же, по каждому критерию есть объяснение. Так что благодаря настройке в сторону manual_review повышается шанс, что HR увидит не абстрактные «88 баллов», а конкретные фрагменты из резюме. Например, что кандидат снизил MTTR с 50 до 20 минут.
Итоговый балл считается обычным кодом, LLM не занимается математикой и не определяет пороги. Уровни критериев всегда дают одинаковый результат. PDF не отправляется в модель целиком, сначала локально извлекается текст, затем удаляются очевидные персональные данные. Модель получает только очищенную текстовую версию.
Tools не нужны, их отсутствие вообще не мешает. Все действия заранее определены:

Где начались неожиданности
PDF — это не всегда текст. Красивое резюме может извлекаться в странном порядке. Таблица навыков иногда перемешивается с опытом, а скан вообще не содержит текстового слоя. Поэтому я сохраняю извлеченный текст, чтобы самому посмотреть, что конкретно уйдет в модель.
Ключевые слова продолжают влиять на результат. Даже с хорошим промптом модель может завышать кандидата, у которого перечислено 20 технологий. Поэтому в инструкции явно написано: Упоминание без применения — не больше 1 балла. Именно для этого нужен отдельный тест с keyword stuffing, на случай, когда кандидат пытается обмануть подобную систему распознавания.
Еще модель иногда переформулирует доказательства, поэтому я требую дословные цитаты. Но тут выясняется, что LLM может слегка переписать исходную фразу. Тогда простая проверка подстроки считает цитату неподтвержденной. Можно перейти к нечеткому сравнению, но я бы сначала оставил строгий режим. Лучше получить лишнее предупреждение, чем принять придуманное доказательство за настоящее.
Порог 75 баллов — не истина, настоящие пороги надо подбирать на размеченном наборе резюме и отдельно для каждой вакансии. Резюме не описывает человека полностью, так что если технология не указана, это еще не означает, что кандидат с ней не работал. Поэтому статусы я назвал not_found, а не candidate_does_not_know. Но это уже детали и шлифовка напильником.
Чего нет в этом сервисе
Описанный мной сервис:
- не отправляет отказы,
- не пишет кандидатам,
- не назначает встречи,
- не меняет статусы в ATS,
- не удаляет резюме,
- не принимает решение о найме,
- не оценивает личность человека,
- не анализирует возраст, пол или фотографию.
В реальном использовании HR по итогу просто получает список кандидатов и открывает оригинальные документы. Моя автоматизация помогает добраться до сильного кандидатов быстрее, но не убирает человека из процесса.
Итоги сего мероприятия
Начиналось все с простой картины: одному HR нужно было за день разобрать 400 резюме в PDF, не отсеять сильных кандидатов и не пропустить слабых.
Вся механика выполняется на обычном Python. Модель отвечает только за смысловую часть: ищет в резюме подтверждения профессионального опыта и сопоставляет их с требованиями вакансии.
Я выбрал text-to-text-модель, создал сервис и получил готовый эндпоинт, не разворачивая GPU-инфраструктуру самостоятельно.
Самое важное — я не старался превратить LLM в цифрового HR-директора. Она не решает судьбу кандидата, но помогает человеку разобрать входящий поток и показывает, на какие резюме стоит посмотреть в первую очередь. По-моему, это как раз нормальная автоматизация — не заменить специалиста, а забрать у него рутину, от которой он уже плачет кровавыми слезами.
Конец!