Агентная модель Axion 1.0-35B набирает 52,2% на Humanity’s Last Exam в режиме с инструментами. Это ровно столько же, сколько у GPT-5.5 в той же таблице, и больше, чем у Gemini 3.1 Pro. Обучена она на 18 000 примеров SFT плюс обучение с подкреплением (RL), без промежуточного дообучения, DPO и дистилляции.
Что именно выложили и под какой лицензией
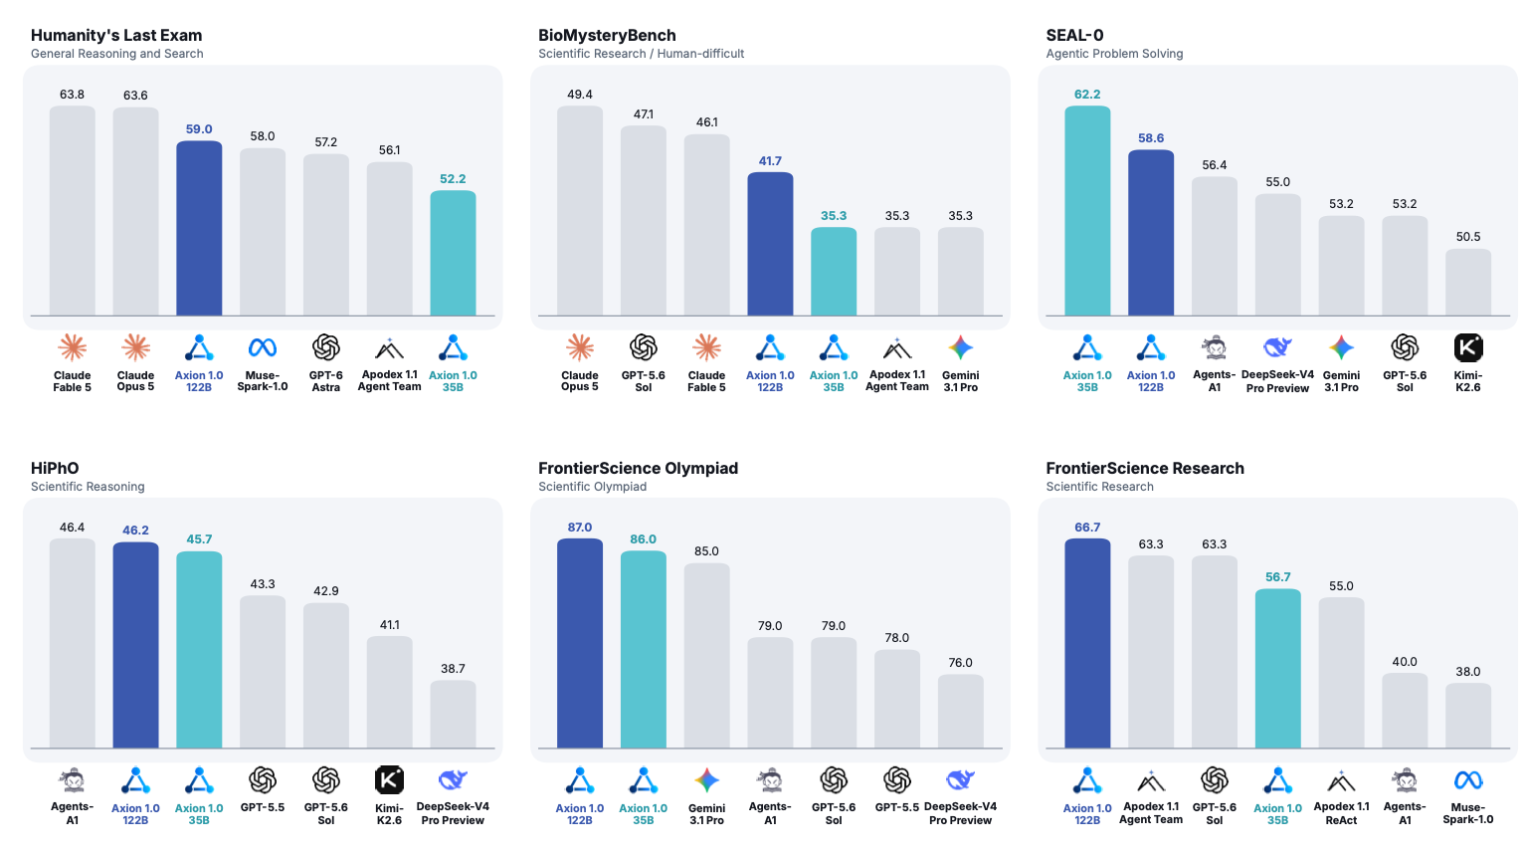
На Hugging Face доступен чекпойнт Axion-1.0-35B под Apache 2.0. Это MoE с 35 млрд параметров, из которых активны около 3 млрд, построенная на Qwen3.6-35B-A3B. Есть оговорка, в карточке он назван reproduction checkpoint, то есть это версия, воспроизведенная по опубликованному рецепту, и ее цифры немного расходятся со статьей (SEAL-0 60,4 против 62,2, HLE 52,8 против 52,2).
Старшая модель на 122B (на основе Qwen3.5-122B-A10B) в статье описана, но ссылки на ее веса на странице проекта нет. Рядом лежат обучающий датасет, промпты, фильтры, верификаторы и код. Для открытых весов это редкость. Обычно лаборатории публикуют веса и техотчет, а данные оставляют себе.
Насколько это дешево
SFT для 35B-версии занял около 90 GPU-часов, для 122B около 240. На H100 это порядка нескольких сотен долларов. RL обходится дороже. Для 122B авторы использовали 40 GPU под rollout и 16 под тренер, но общее время RL в статье не указано. Если исходить из типичных GRPO-прогонов такого масштаба, речь идет о тысячах GPU-часов. Это все еще укладывается в бюджет небольшой ML-команды.
Сам рецепт выглядит так:
- первый этап — на 10 800 траекторий учит рассуждать без инструментов на сгенерированных сложных задачах;
- второй этап — на 7 500 добавляет работу с веб-поиском, загрузкой страниц, поиском по научной литературе и Python;
- третий этап — запускает GRPO во фреймворке verl с наградой за верный ответ и частичным кредитом за проверенные промежуточные шаги.
Можно ли запустить это у себя
Да, и довольно легко. Три миллиарда активных параметров означают быстрый инференс, а 35B в четырехбитной квантизации помещаются примерно в 20 ГБ видеопамяти. Сообщество уже выложило GGUF-версию для llama.cpp. Архитектуру qwen3_5_moe поддерживают основные инференс-движки. Нюанс в том, что модель агентная, а цифры получены в ReAct-обвязке с веб-поиском и исполнением кода. Поэтому без собственного инструментального контура результаты будут скромнее.
Доверять бенчмаркам или нет
Авторы сами предупреждают, что сравнения с закрытыми моделями взяты из разных источников с разными настройками, а каждый результат — лучший из одного прогона. Часть цифр для Gemini 3.1 Pro посчитала команда Axion. Набор бенчмарков смещен в науку (HiPhO, FrontierScience, BioMysteryBench), классического кодинга вроде SWE-bench в главной таблице нет. Claude Opus 5 на HLE остается заметно впереди с 63,6%. В статье также признается, что RL улучшает метрики неравномерно, а у 35B даже ухудшает FrontierScience Research и HiPhO.