Все чаще нам приходится работать с большими объемами данных, которые нужно регулярно собирать, трансформировать и загружать в хранилища. Когда таких процессов становятся десятки или сотни, управлять ими вручную или с помощью разрозненных скриптов становится практически невозможно. Нужны инструменты, которые следят за зависимостями между задачами, перезапускают упавшие шаги и показывают, что происходит в каждый момент времени.
Поэтому на рынке появилось множество платформ оркестрации рабочих процессов, таких как Prefect, Dagster, Luigi и Argo Workflows. Среди них одним из самых популярных решений остается Apache Airflow, и в статье мы разберемся, как он устроен и почему его так часто выбирают.
Что такое Apache Airflow
Airflow — это «диспетчер» для ваших скриптов: он запускает их в нужном порядке и по расписанию, повторяет упавшие шаги и показывает в браузере, что и когда сработало. Мы разберем устройство Airflow 3, запустим пайплайн в Docker, сравним Airflow с Prefect, Dagster и Luigi и посмотрим, как запустить его на сервере. Статья рассчитана на тех, кто уже писал скрипты на Python и хочет собрать из них регулярный процесс.
Apache Airflow — это open-source платформа, предоставляющая инструменты для создания, планирования и мониторинга процессов обработки данных, запускаемых как по расписанию, так и при определенных событиях. Apache Airflow не только сам написан на Python, но и реализует подход «workflows as code»: все процессы описываются тоже на Python.
Что нового в Airflow 3
Если вы работали с Airflow 2, учтите главные изменения третьей версии: интерфейс и REST API обслуживает API-сервер вместо веб-сервера, DAG-процессор стал обязательным отдельным компонентом, задачи сообщают состояние через Task SDK, а планирование по данным строится на ассетах.
Для чего применяется
Apache Airflow применяется для построения сложных процессов обработки данных. К основным задачам можно отнести сбор, обработку и загрузку данных (ETL-пайплайны; например, ежедневная выгрузка продаж из CRM в хранилище для отчетов), переобучение, тестирование и проверку качества моделей машинного обучения. При этом сфера использования не ограничивается только работой с данными — платформу можно также использовать для автоматизации рабочих процессов (например, рассылки) и инфраструктурных задач (запуск скриптов, бэкапы и так далее).
Архитектура Apache Airflow
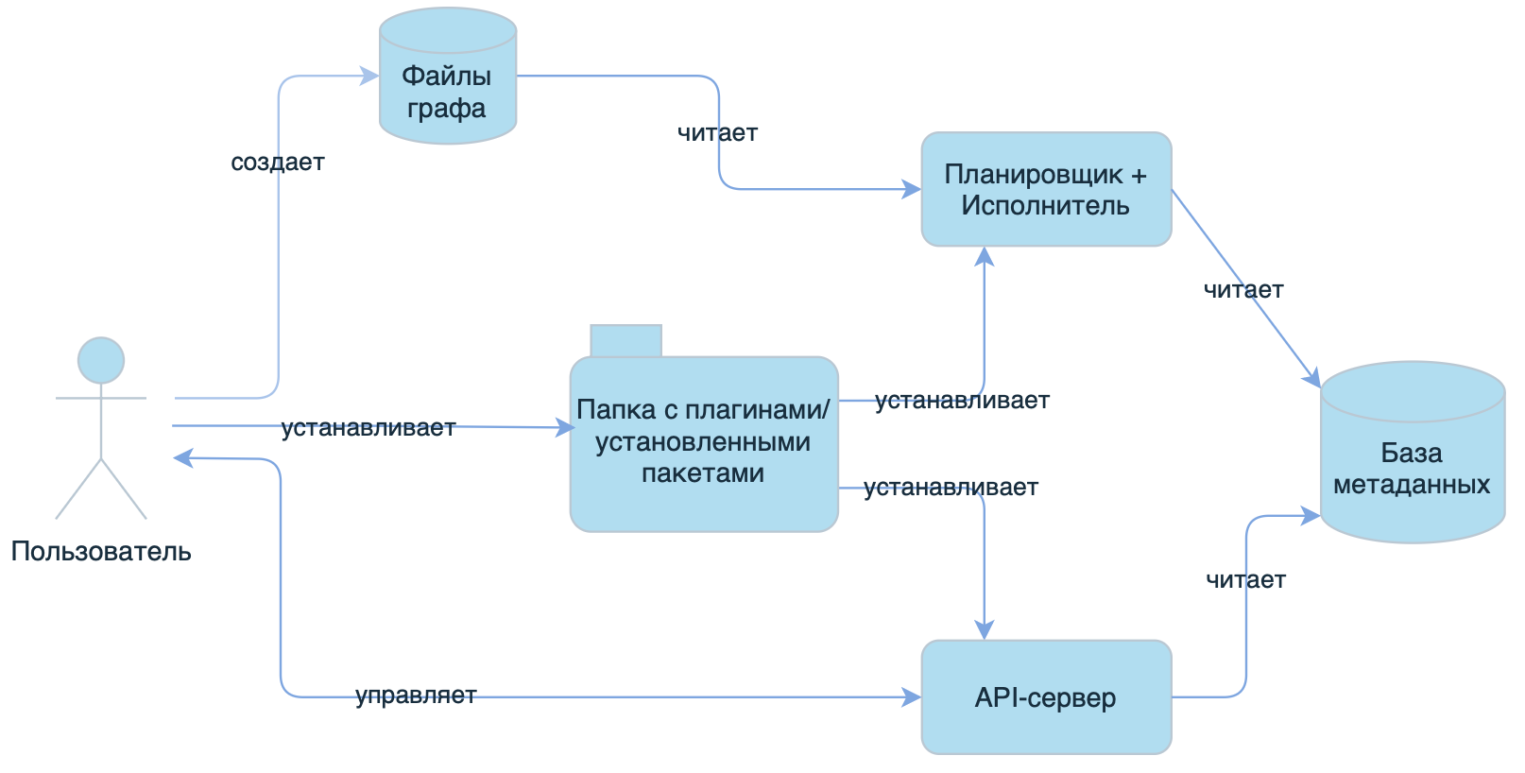
Рассмотрим архитектуру Apache Airflow на простом примере развернутого инстанса на одной машине. Для такой конфигурации, как правило, используется LocalExecutor, при котором планировщик и пайплайны выполняются в рамках одного процесса Python.
Процесс обработки графа также запускается на этой машине: он считывает файлы графа из соответствующего набора и сериализует их в базу данных метаданных, откуда их затем считывает планировщик. API-сервер работает на той же машине, что и планировщик.
Компоненты
Рассмотрим подробнее описанный выше минимальный набор компонентов, необходимый для развертывания и работы Apache Airflow.
Планировщик (Scheduler)
Планировщик Apache Airflow отслеживает все задачи и графы и запускает экземпляры задач, как только их зависимости выполнены. Сам он не читает файлы графов: их разбирает отдельный компонент — процессор графов, и сохраняет сериализованные графы в базу метаданных, откуда их берет планировщик. В каждой итерации своего цикла планировщик создает новые запуски графов, находит задачи, готовые к выполнению, и передает их исполнителю. Планировщик рассчитан на постоянную работу как служба в продакшен-среде. Запускается он командой airflow scheduler и использует настройки из файла airflow.cfg.
Исполнитель (Executor)
Исполнитель представляет собой механизм, с помощью которого запускаются экземпляры задач. Все исполнители обладают общим API и являются взаимозаменяемыми, то есть один тип исполнителя можно заменять на другой в зависимости от конкретных архитектурных требований.
Исполнитель задается опцией executor в секции [core] файла конфигурации airflow.cfg. На встроенные исполнители ссылаются по имени, например:
[core]
executor = KubernetesExecutor
Пользовательские или сторонние исполнители можно настроить, указав путь к модулю, содержащему класс исполнителя (написанный на Python), например:
[core]
executor = my.custom.executor.module.ExecutorClass
Исполнители бывают встроенными и кастомными, а также локальными и удаленными; удаленные, в свою очередь, делятся на основанные на очередях и контейнеризированные.
Из встроенных исполнителей задачи локально, то есть в процессе планировщика, запускает только LocalExecutor (так могут работать и пользовательские). Он используется по умолчанию и представляет собой самый простой вариант выполнения задач. Однако, поскольку LocalExecutor запускает процессы внутри процесса планировщика, это может повлиять на производительность самого планировщика.
Исполнители на основе очередей (CeleryExecutor, BatchExecutor, EdgeExecutor) работают с задачами из общей очереди, откуда работники забирают их для выполнения. Зачастую работники выполняют несколько задач одновременно. Из плюсов данного типа исполнителей выделяют надежность системы благодаря отделению воркеров от процесса планировщика. В качестве воркеров могут выступать мощные хосты, способные обрабатывать множество задач (часто параллельно), что экономически выгодно.
Задержки могут быть минимальными, так как воркеры могут работать постоянно, мгновенно забирая задачи из очереди. Из минусов — при использовании разделяемых воркеров возникает проблема «шумного соседа»: работники конкурируют за ресурсы общих хостов и за параметры конфигурации среды или системы.
При использовании контейнеризированных исполнителей задачи Airflow выполняются по мере необходимости внутри контейнеров или подов. Каждая задача изолирована в собственной контейнеризированной среде, которая разворачивается в момент постановки задачи Airflow в очередь. К плюсам относят решение проблемы «шумного соседа» — каждая задача Airflow выполняется в отдельном контейнере. Среду выполнения можно настроить под конкретные задачи (системные библиотеки, бинарные файлы, зависимости, объем ресурсов и так далее).
Это экономически выгодно, так как воркеры существуют только в течение времени выполнения задачи. К минусам относят задержку, возникающую при запуске, так как перед началом выполнения задачи необходимо развернуть контейнер или под. Это может быть накладно, если вы запускаете множество коротких или небольших задач. Не нужно управлять отдельными воркерами, однако приходится обслуживать инфраструктуру — например, кластера Kubernetes.
DAG-процессор
DAG-процессор парсит файлы графов из набора файлов графов — DAG bundle и сериализует их в базу метаданных. DAG bundle — это объект, настроенный таким образом, чтобы DAG-процессор мог считывать из него файлы графов, а воркеры — получать доступ к нужной версии DAG-файлов. По умолчанию это локальная папка на диске.
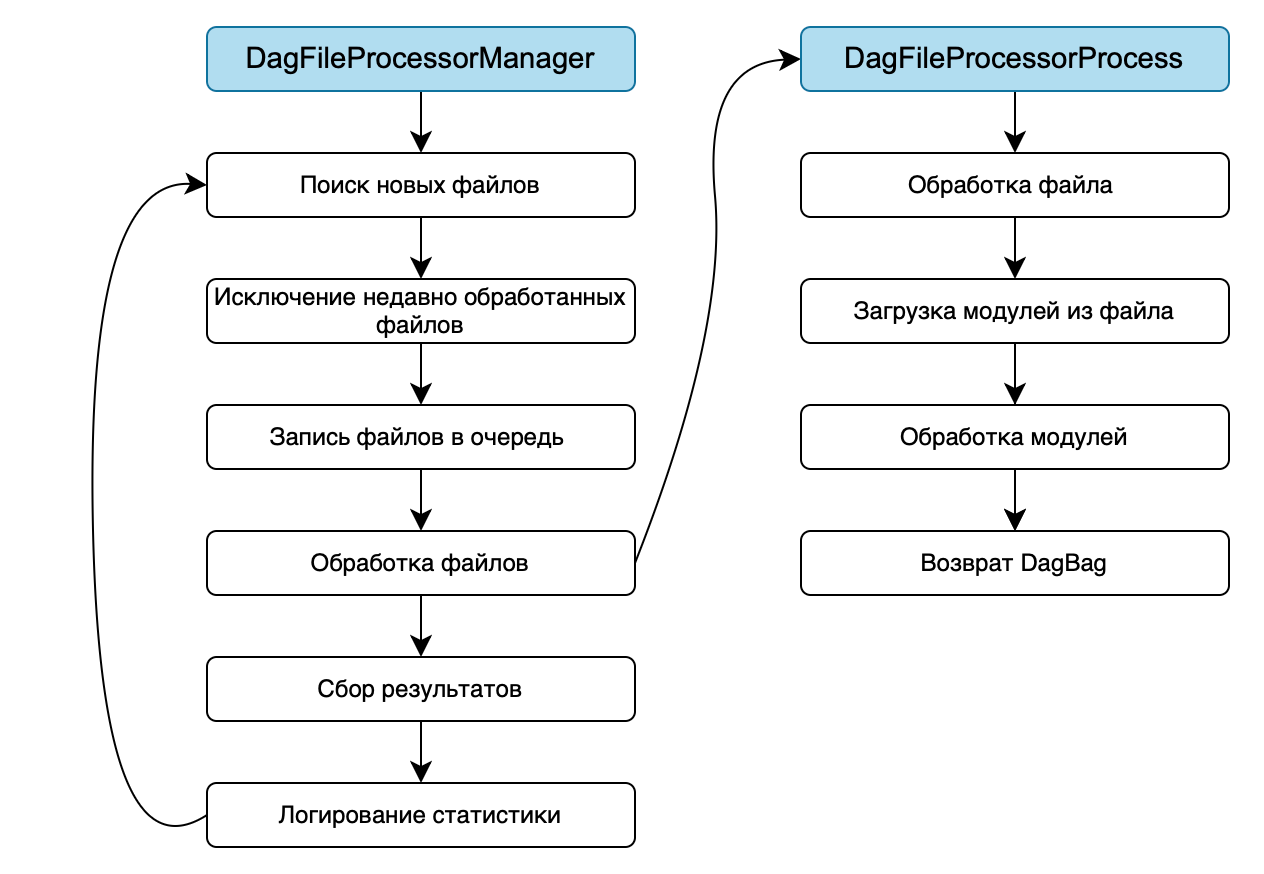
В процесс обработки файлов графов включены два основных компонента — DagFileProcessorManager и DagFileProcessorProcess. DagFileProcessorManager — это процесс с бесконечным циклом, который определяет, какие файлы необходимо обработать. DagFileProcessorProcess, в свою очередь, — отдельный процесс, конвертирующий каждый отдельный файл в один или несколько объектов DAG.
DagFileProcessorManager включает в себя следующие шаги:
- Проверка новых файлов — если время, прошедшее с момента последнего обновления DAG, превышает параметр refresh_interval, происходит обновление списка путей к файлам;
- Исключение файлов, с момента обработки которых прошло меньше min_file_process_interval и которые с тех пор не менялись;
- Добавление обнаруженных файлов в очередь;
- Обработка файлов — запуск нового DagFileProcessorProcess для каждого файла, с максимальным ограничением на количество экземпляров, задаваемых параметром parsing_processes;
- Сбор результатов от всех завершившихся DagFileProcessorProcess;
- Логирование статистики — вывод статистики и запись метрики dag_processing.total_parse_time.
DagFileProcessorProcess состоит из следующих шагов:
- Обработка файла: весь процесс должен завершиться за время, указанное в параметре dag_file_processor_timeout;
- Загрузка файлов DAG как модулей Python, причем загрузка должна завершиться за время dagbag_import_timeout;
- Обработка модулей: поиск объектов DAG в модуле Python;
- Возврат DagBag: передача DagFileProcessorManager списка найденных объектов DAG.
Сервер
API-сервер — компонент, который обслуживает REST API Airflow и предоставляет пользовательский интерфейс для просмотра, запуска и отладки графов и задач. Через этот интерфейс пользователь может следить за состоянием запусков, вручную запускать графы, изучать логи и разбираться, почему задача завершилась ошибкой.
Помимо этого, API-сервер выступает посредником между выполняемыми задачами и Airflow: задачи, использующие Task SDK, сообщают ему о своем состоянии и получают нужные данные, не обращаясь к базе метаданных напрямую. Благодаря этому воркерам не нужен доступ к базе, что повышает безопасность и упрощает развертывание в распределенных средах. В Airflow 3 API-сервер заменил веб-сервер из Airflow 2 и запускается командой airflow api-server. Как и планировщик, он получает сведения о графах из сериализованных данных в базе данных, а не из файлов.
База метаданных
База метаданных — компонент, в котором остальные компоненты Airflow хранят состояние воркеров и задач. Здесь находятся сериализованные графы, которые записывает DAG-процессор, сведения о запусках графов и экземплярах задач, их статусы и история выполнения, а также подключения, переменные и другие служебные данные. Планировщик, DAG-процессор и API-сервер постоянно читают и записывают данные в эту базу, поэтому она служит единым источником истины для всей системы, а ее настройка обязательна для работы Airflow. В продакшен-среде используют PostgreSQL или MySQL, а SQLite подходит только для разработки и тестирования. Подключение задается параметром sql_alchemy_conn в секции [database] файла airflow.cfg, а схема базы создается и обновляется командой airflow db migrate.
Работник (Worker)
Работник является непосредственным исполнителем задач, переданных ему планировщиком. В базовой конфигурации работник может быть частью планировщика, а не отдельным компонентом: за это отвечает LocalExecutor, о котором говорилось выше.
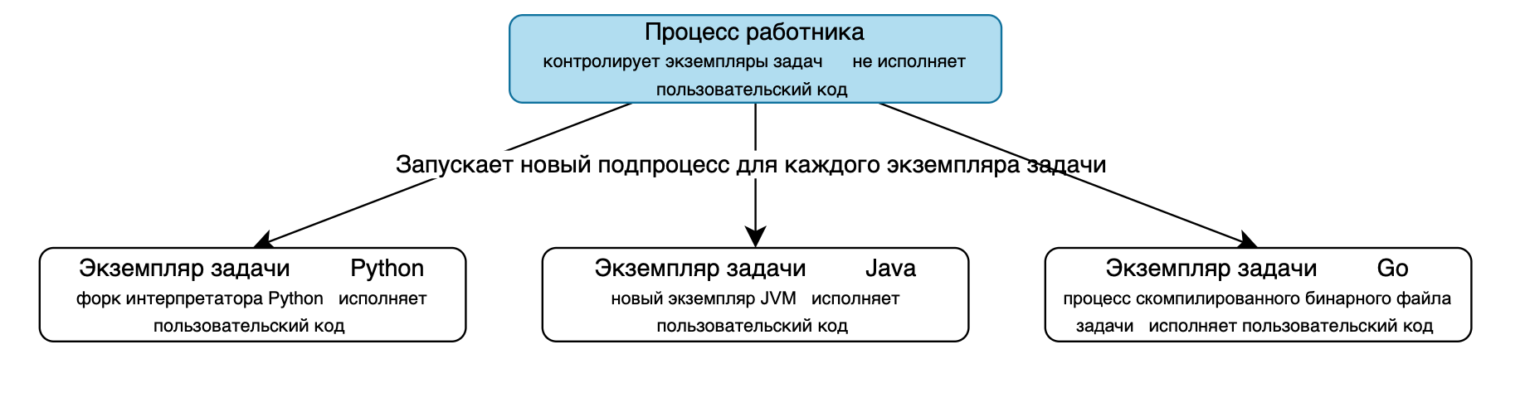
Работник никогда не запускает задачи в собственном процессе. Для каждого экземпляра задачи он начинает новый подпроцесс, мониторит его и прерывает, когда задача завершена.
В зависимости от используемого языка отличаются подпроцессы:
- Python — форкнутый интерпретатор Python;
- Java — новый экземпляр JVM;
- Go — новый процесс, соответствующий скомпилированному бинарному файлу задачи.
Экземпляры задач не делят ресурсы и не используют их повторно, поэтому одновременный запуск·N экземпляров требует N подпроцессов (плюс любые процессы, порождаемые самим кодом задачи). Таким образом, при определении параметров воркера необходимо учитывать пиковое количество одновременно выполняемых экземпляров задач, а не только сам процесс воркера.
Триггерер
Триггерер — необязательный компонент, который выполняет отложенные задачи в цикле событий asyncio. Отложенными становятся задачи, построенные на отложенных операторах (Deferrable Operators): вместо того чтобы занимать слот воркера, пока они ждут внешнего события (например, появления файла или завершения задания во внешней системе), такие задачи передают ожидание триггеру и освобождают воркер.
Триггерер асинхронно отслеживает множество таких триггеров одновременно, а когда условие выполняется, задача возобновляется и продолжает работу на воркере. Это позволяет заметно экономить ресурсы при большом количестве долгих ожиданий. Запускается триггерер командой airflow triggerer, а в базовой установке, где отложенные задачи не используются, он не нужен. Стоит учитывать, что начиная с Airflow 3.3 задачи с участием человека (Human-in-the-loop) не используют триггерер: они ожидают ввода в состоянии awaiting_input, которым управляет планировщик.
Как проходит один запуск
Соберем компоненты в одну цепочку:
- DAG-процессор читает файл графа и сохраняет его сериализованную версию в базу метаданных;
- планировщик по расписанию создает DAG run и выбирает задачи, у которых выполнены зависимости;
- он передает их исполнителю, а тот запускает задачи на воркере;
- воркер выполняет каждую задачу в отдельном подпроцессе и сообщает состояние через API-сервер;
- состояние записывается в базу метаданных, и вы видите его в интерфейсе. Если задача упала, планировщик по настройкам повторов поставит ее в очередь снова.
Основные сущности
Помимо компонентов архитектуры стоит назвать сущности, с которыми работает специалист при построении логики и структуры рабочих процессов в данном инструменте. Основной сущностью является DAG, ориентированный ациклический граф, который описывает порядок выполнения и зависимости между задачами, собирая их в единый рабочий процесс.
Граф состоит из задач, в которых описываются конкретные действия с данными. При этом задачи строятся на основе операторов, которые выступают шаблонами для задач. Также к основным сущностям относят сенсоры, являющиеся специфичным типом оператора, созданного для одного конкретного действия — ожидать какое-либо событие. Рассмотрим каждую из сущностей по отдельности ниже:
DAG
Как уже было сказано выше, DAG (Directed Acyclic Graph) — это ориентированный ациклический граф, являющийся источником описания рабочего процесса. Слово «ориентированный» означает, что процесс движется строго в одном направлении, а «ациклический» — что в нем не должно быть циклов.
Основными атрибутами графа являются:
- расписание — когда рабочий процесс будет запущен;
- задачи — дискретные элементы процесса, исполняемые на воркерах;
- зависимости задач — порядок и условия запуска задач;
- функции обратного вызова — действия, выполняемые после завершения рабочего процесса.
Сам по себе DAG не знает, что конкретно происходит внутри задач, его основная обязанность — задать порядок задач, число попыток при таймаутах и так далее.
Есть три способа объявить DAG — это можно сделать, используя контекстный менеджер:
      import datetime

from airflow.sdk import DAG

from airflow.providers.standard.operators.empty import EmptyOperator

with DAG(

     dag_id="my_dag_name",

     start_date=datetime.datetime(2021, 1, 1),

     schedule="@daily",

):

     EmptyOperator(task_id="task")
Через создание объекта класса, передавая граф в качестве параметра в нужные операторы:
      import datetime

from airflow.sdk import DAG

from airflow.providers.standard.operators.empty import EmptyOperator

my_dag = DAG(

     dag_id="my_dag_name",

     start_date=datetime.datetime(2021, 1, 1),

     schedule="@daily",

)

EmptyOperator(task_id="task", dag=my_dag)
Или можно использовать декоратор @dag, чтобы превратить функцию в генератор графов:
      import datetime

from airflow.sdk import dag

from airflow.providers.standard.operators.empty import EmptyOperator

@dag(start_date=datetime.datetime(2021, 1, 1), schedule="@daily")

def generate_dag():

EmptyOperator(task_id="task")

generate_dag()
Графы запускаются вручную, через API или по расписанию. Расписание бывает по времени и по событиям:
- когда они запускаются — вручную или через API;
- по предопределенному расписанию, которое указывается при создании графа;
- по событию, например, при обновлении ассета, от которого зависит граф.
Расписание не является обязательным полем при определении DAG, но чаще всего его указывают через аргумент schedule. Способов указать расписание достаточно много:
with DAG("my_daily_dag", schedule="@daily"):

    ...

with DAG("my_daily_dag", schedule="0 0 * * *"):

    ...

with DAG("my_one_time_dag", schedule="@once"):

    ...

with DAG("my_continuous_dag", schedule="@continuous"):

    ...
При каждом запуске DAG создается экземпляр графа, именуемый DAG run в Airflow. Для одного и того же DAG может быть запущено несколько экземпляров параллельно.
Три понятия объясняют большинство вопросов новичков. Logical date и data interval описывают период данных, который обрабатывает запуск, а не момент его старта. Параметр catchup=True заставляет Airflow создать запуски за все пропущенные периоды, начиная со start_date, а backfill — это ручной запуск за прошлый период. Для первого стенда ставьте catchup=False, чтобы после включения графа не получить сотни запусков.
Задача
Задача является базовой единицей исполнения в Apache Airflow, они объединяются в графы, выстраиваются в исходящие (downstream) и входящие (upstream) зависимости для определения порядка их выполнения.
Существует три базовых типа задач:
- операторы — готовые шаблоны задач, которые можно объединять в цепочки для быстрого создания DAG-ов;
- сенсоры — специальный подкласс операторов, основной задачей которых является ожидание какого-либо внешнего события;
- декорированная с помощью @task функция — пользовательская функция Python, оформленная в виде задачи.
Ключевой частью использования задач является определение их отношений друг к другу и зависимостей, при этом всегда сначала объявляется задача, и после этого объявляется ее зависимость по отношению к другим задачам.
Есть два способа объявить зависимость между задачами — используя операторы побитового сдвига >> и <<:
first_task >> second_task >> [third_task, fourth_task]

Или используя более явные методы set_upstream и set_downstream:

first_task.set_downstream(second_task)

third_task.set_upstream(second_task)
По умолчанию задача запускается после того, как все предшествующие (родительские) задачи успешно завершились. Однако существует множество способов изменить это поведение: например, добавить ветвление, настроить ожидание только некоторых предшествующих задач или изменить логику выполнения в зависимости от истории предыдущих запусков.
Экземпляр задачи — это конкретный запуск данной задачи в рамках конкретного графа, кроме того, это представление задачи с состоянием, отражающим текущий этап ее жизненного цикла.
Оператор
Как уже было сказано ранее, фундаментально оператор представляет собой шаблон для задачи, которую можно объявить внутри графа:
with DAG("my-dag") as dag:

    ping = HttpOperator(endpoint="http://example.com/update/")

    email = EmailOperator(to="admin@example.com", subject="Update complete")

    ping >> email
В Airflow доступен обширный набор операторов, некоторые из них входят в состав ядра системы, а другие — в предустановленные провайдеры. К числу популярных относят:
- BashOperator;
- PythonOperator;
- EmailOperator;
- HttpOperator;
- SQLExecuteQueryOperator;
- DockerOperator;
- S3FileTransformOperator;
- PrestoToMySqlOperator;
- SlackAPIOperator;
- Использование произвольной функции Python в качестве оператора через декоратор @task.
Сенсор
Сенсор представляет собой оператор, ожидающий какое-либо событие. Он может быть привязан к конкретному времени, появлению файла или какого-либо внешнего события — суть в том, что сенсор просто ждет наступления определенного условия, после чего успешно завершается, позволяя запустить последующие задачи. Если же ожидаемое событие не происходит в течение заданного времени, сенсор выбрасывает ошибку, что позволяет получить соответствующую информацию о том, что событие не произошло.
Поскольку сенсоры большую часть времени пребывают в режиме ожидания, для них предусмотрено два различных режима работы — это позволяет использовать их более эффективно:
- poke (по умолчанию): сенсор занимает слот для воркера на все время работы;
- reschedule: сенсор занимает слот для воркера только во время проверки, а в промежутках между проверками находится в режиме ожидания.
Режимы poke и reschedule можно настроить непосредственно при создании экземпляра сенсора. Как правило, выбор между ними — это компромисс, связанный с задержкой. Если проверка выполняется чаще чем раз в пять минут, используйте режим poke, а при более редких проверках — reschedule. Для долгих ожиданий лучше отложенные сенсоры: они вообще не занимают слот воркера и отдают ожидание триггеру.
Как и в случае с операторами, в Airflow имеется обширный набор готовых сенсоров — как в составе самого ядра Airflow, так и в пакетах провайдеров.
К самым используемым сенсорам относятся:
- FileSensor — ожидает появление файла в файловой системе;
- BashSensor — ожидает возврат true от команды bash;
- PythonSensor — ожидает возврат true от вызываемого объекта Python;
- TimeSensor — ожидает наступление определенного времени;
- TimeDeltaSensor — ожидает прошествие заданного промежутка времени;
- ExternalTaskSensor — ожидает завершение задачи из другого графа.
Можно ли развернуть Apache Airflow локально
Apache Airflow можно развернуть локально на собственном физическом оборудовании, в примере ниже будет продемонстрировано, как это сделать на Ubuntu 24.04 в docker. Такая установка отлично подойдет для изучения функционала инструмента.
Установка и запуск
Для развертывания Apache Airflow в контейнере нам понадобится docker и docker-compose, убедиться, что они уже установлены, можно с помощью команд:
docker version
docker compose version
Если данных инструментов еще нет в системе, то их можно установить по инструкции из Академии Selectel: https://selectel.ru/blog/docker-install-ubuntu/.
Далее для развертывания необходимо скачать файл docker-compose.yaml с официального сайта, для этого в нужной нам для работы с Airflow директории выполняем:
curl -LfO ‘https://airflow.apache.org/docs/apache-airflow/3.3.2/docker-compose.yaml’
Данный compose-файл содержит настройки для:
- airflow-scheduler — планировщик, отслеживающий все графы и ход их выполнения;
- airflow-dag-processor — процессор графов, читающий файлы графов;
- airflow-api-server — api-сервер для управления инструментом;
- airflow-worker — работник, выполняющий задачи, которые передал планировщик;
- airflow-triggerer — триггерер, запускающий событийный цикл для отложенных задач;
- airflow-init — сервис инициализации;
- postgres — реляционная база данных;
- redis —redis, используемый как брокер для доставки сообщений от планировщика к работникам.
В официальной конфигурации также монтируются некоторые директории:
- ./dags — файлы графов;
- ./logs — логи исполнения задач и планировщика;
- ./config — конфигурация работы инструмента;
- ./plugins — для кастомных плагинов.
Перед первым запуском Airflow необходимо подготовить окружение: создать нужные файлы и директории, инициализировать базу данных. В Linux для быстрого запуска необходимо указать идентификатор пользователя хостовой системы (переменная AIRFLOW_UID в .env файле, по умолчанию используемом в docker-compose.yaml). В противном случае файлы, создаваемые в директориях `dags`, `logs`, `config` и `plugins`, будут принадлежать пользователю `root`.
Для установки переменной и создания директорий:
mkdir -p ./dags ./logs ./plugins ./config

echo -e "AIRFLOW_UID=$(id -u)" > .env
Далее для прогона миграций и создания пользователя по умолчанию в Airflow необходимо выполнить:
docker compose up airflow-initПосле инициализации запускаем все описанные выше в docker-compose.yaml сервисы:
docker compose upТеперь можем зайти в интерфейс поднятого Airflow через браузер по адресу localhost:8080, по умолчанию пользователь и пароль — airflow:airflow. Их также можно изменить в .env файле через _AIRFLOW_WWW_USER_USERNAME и _AIRFLOW_WWW_USER_PASSWORD:
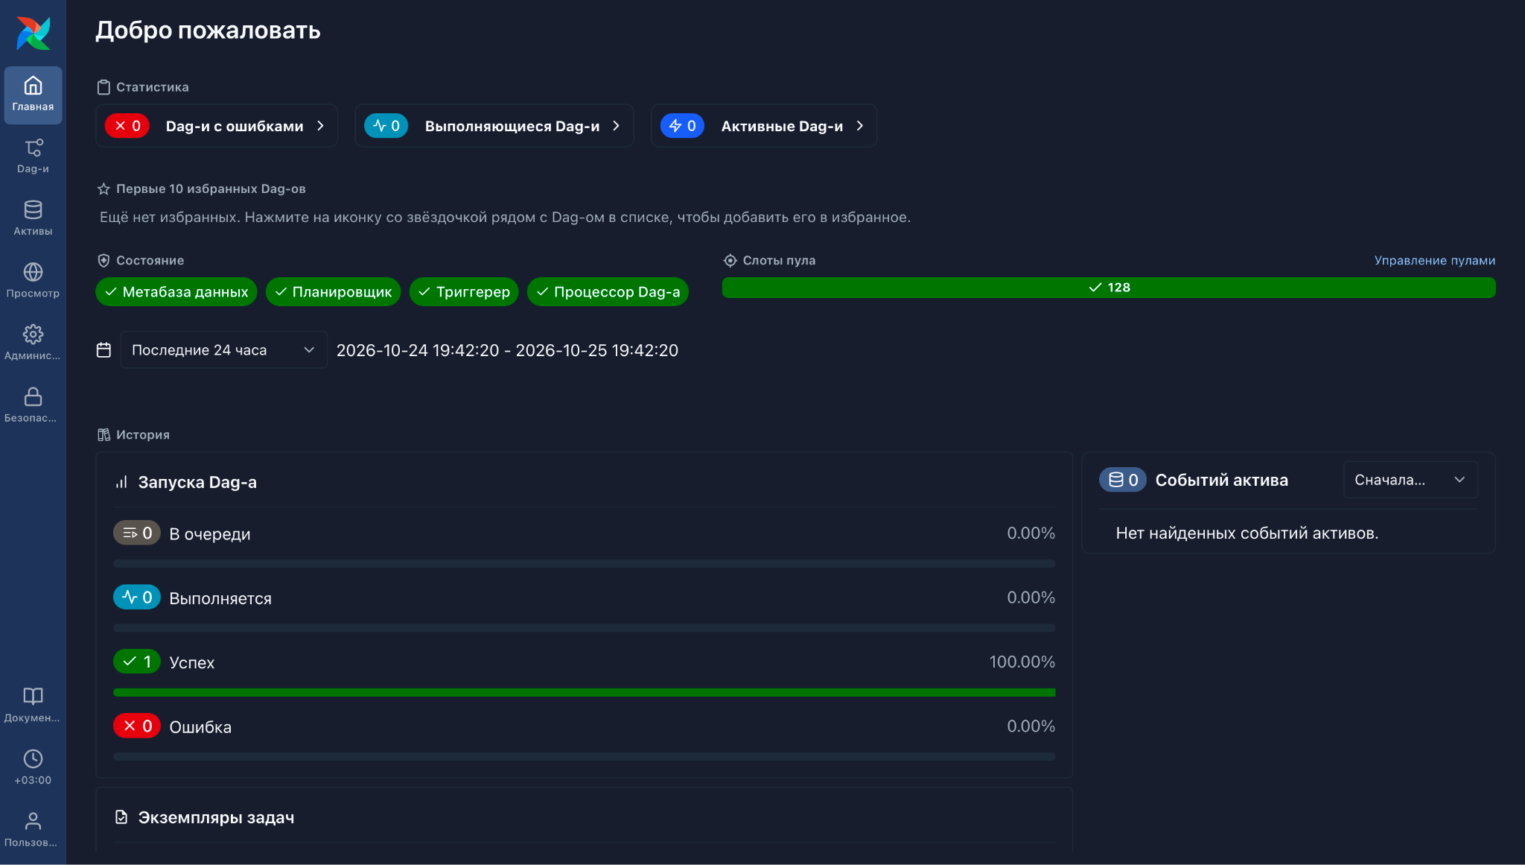
Напишем и запустим граф, который будет имитировать процесс получения, обработки и загрузки данных, для этого создаем .py (mock_etl.py) файл в директории dags, созданной нами ранее, со следующим содержимым:
from datetime import datetime
from airflow.providers.standard.operators.bash import BashOperator
from airflow.sdk import DAG
with DAG(
dag_id=”mock_etl”,
description=”Моковый ETL-процесс на BashOperator”,
start_date=datetime(2026, 1, 1),
schedule=None,
catchup=False,
tags=[“demo”, “bash”],
) as dag:
extract = BashOperator(
task_id=”extract”,
bash_command=(
‘echo “Подключаемся к источнику данных…” && ‘
“sleep 2 && “
‘echo “Получено 100 записей”‘
),
)
validate = BashOperator(
task_id=”validate”,
bash_command=(
‘echo “Проверяем записи на пустые значения и дубликаты…” && ‘
‘echo “Отброшено 3 некорректные записи”‘
),
)
transform = BashOperator(
task_id=”transform”,
bash_command=(
“echo \”Результат извлечения: {{ ti.xcom_pull(task_ids=’extract’) }}\” && “
‘echo “Приводим даты к единому формату и считаем агрегаты…” && ‘
“sleep 2 && “
‘echo “Обработано 97 записей”‘
),
)
load = BashOperator(
task_id=”load”,
bash_command=(
‘echo “Загружаем данные в хранилище…” && ‘
‘echo “Запуск {{ run_id }} успешно завершен”‘
),
)
extract >> validate >> transform >> load
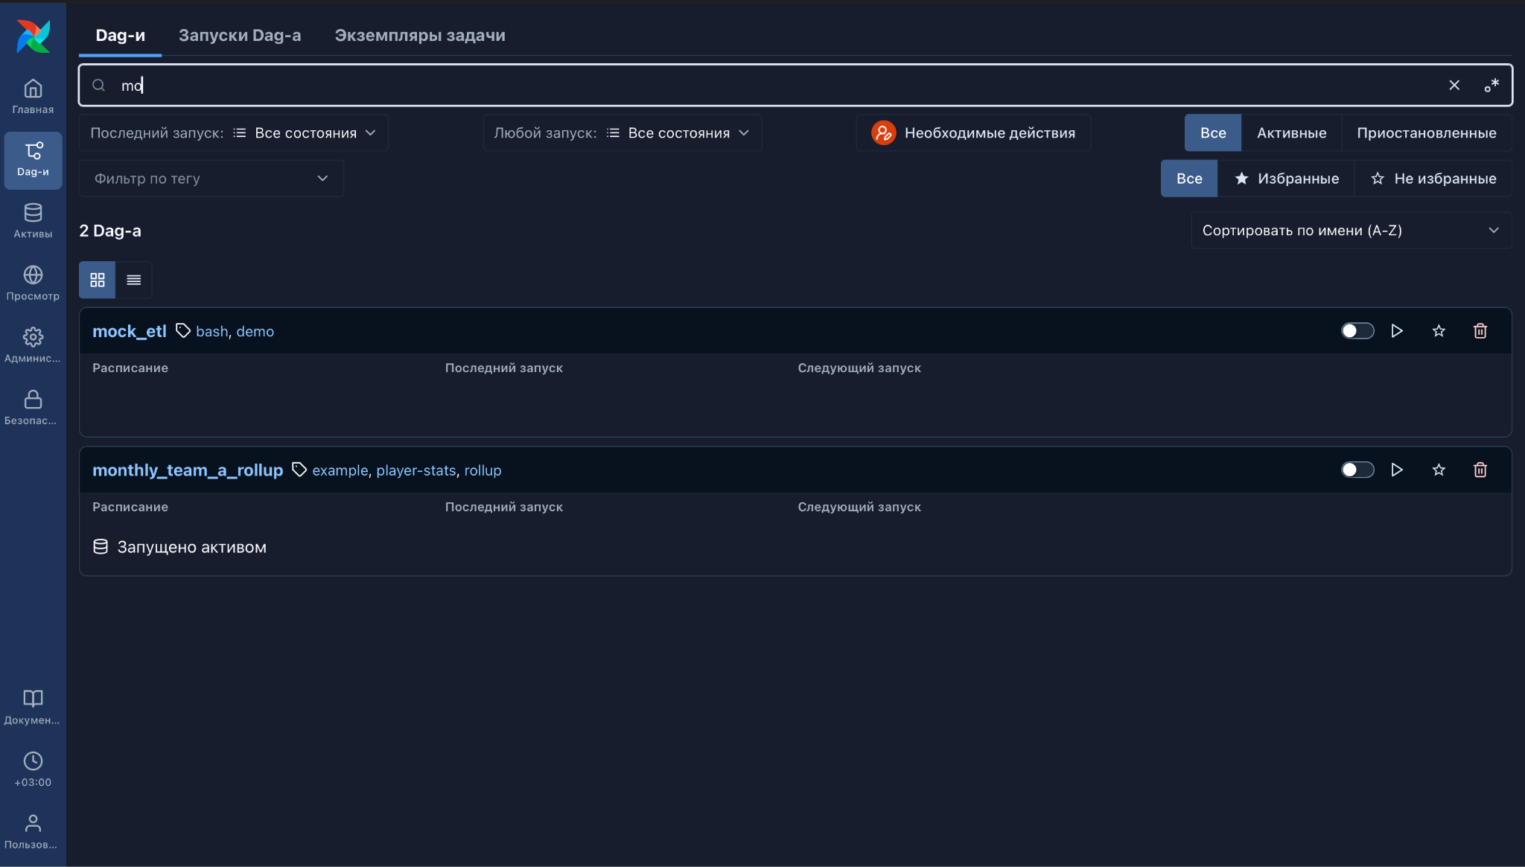
DAG-процессор считывает файл, и он становится виден нам в интерфейсе по идентификатору dag_id, присвоенному в файле графа, откуда мы можем его запустить:
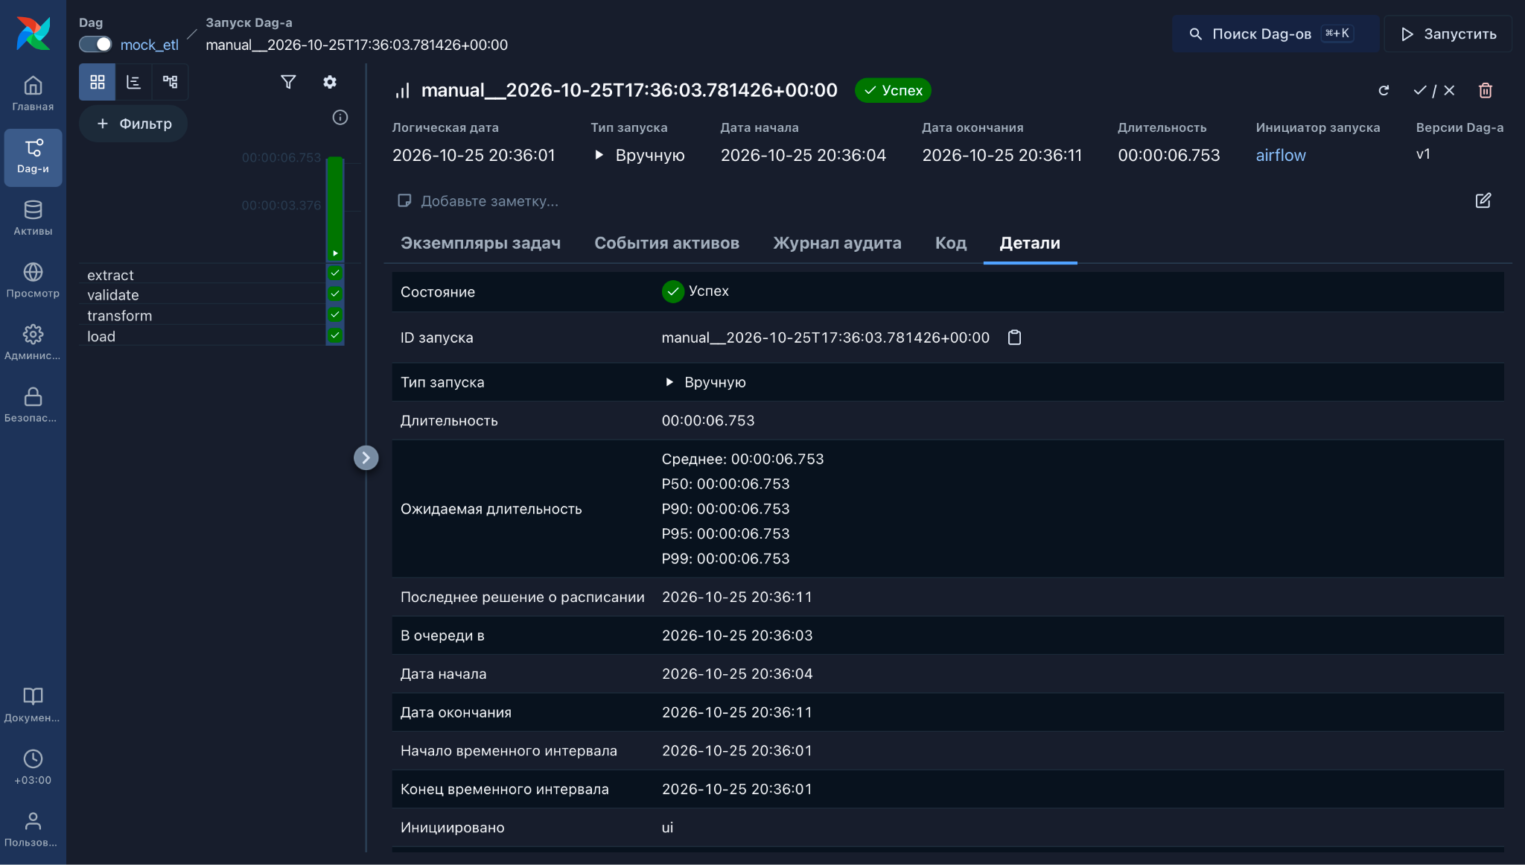
После запуска можно отслеживать ход исполнения через веб-интерфейс:
В Bash-примере данные передаются через вывод команд. В реальных проектах чаще используют TaskFlow API: задачи — обычные Python-функции, а Airflow сам передает возвращаемые значения через XCom.
from datetime import datetime
from airflow.sdk import dag, task
@dag(start_date=datetime(2026, 1, 1), schedule=None, catchup=False)
def taskflow_etl():
@task
def extract() -> list[int]:
return [1, 2, 3]
@task
def transform(rows: list[int]) -> int:
return sum(rows)
@task
def load(total: int):
print(f”Загружено, сумма = {total}”)
load(transform(extract()))
taskflow_etl()
С чем можно интегрировать
Apache Airflow интегрируется с внешними системами через пакеты провайдеров. Это отдельно устанавливаемые библиотеки, которые содержат операторы, хуки, сенсоры и подключения для конкретного инструмента. Открытое сообщество разработчиков Airflow поддерживает около сотни официальных провайдеров, но в случае отсутствия нужной интеграции в списке официальных провайдеров, интеграцию можно написать самостоятельно на Python или вызвать внешний инструмент через BashOperator, PythonOperator или HTTP-запрос.
Из СУБД Airflow из коробки поддерживает PostgreSQL, MySQL, Microsoft SQL Server, Oracle, SQLite, а также аналитические хранилища и движки вроде Snowflake, Google BigQuery, Amazon Redshift, ClickHouse, Trino, Apache Hive и Databricks SQL. Для большинства из них есть общий оператор SQLExecuteQueryOperator, который выполняет запросы через настроенное подключение. Отдельно поддерживаются NoSQL-хранилища, например MongoDB, Redis, Elasticsearch и Apache Cassandra.
Среди инструментов обработки данных Airflow поддерживает Apache Spark, Databricks, dbt, Apache Kafka, Apache Beam и Flink. Чаще всего Airflow в таких связках не обрабатывает данные сам, а запускает задания в этих системах и следит за их выполнением. Для запуска контейнеров есть интеграции с Docker и Kubernetes, а также с инструментами Hadoop-экосистемы (HDFS, YARN).
Есть интеграции и с инструментами вокруг рабочих процессов: системами уведомлений (Slack, Microsoft Teams, Telegram, электронная почта), репозиториями Git, через которые можно поставлять графы с помощью Dag bundles, хранилищами секретов (HashiCorp Vault, AWS Secrets Manager, Google Secret Manager) и системами мониторинга.
Пишите идемпотентные задачи: повторный запуск за тот же период не должен дублировать данные. Не выполняйте тяжелую работу на верхнем уровне файла графа: DAG-процессор разбирает его постоянно. Для долгих ожиданий используйте отложенные операторы вместо сенсоров в режиме poke. Ограничивайте параллелизм пулами. Секреты храните в подключениях и хранилищах секретов, а не в коде графа. Между задачами передавайте ссылки на данные, а не сами датафреймы.
Преимущества и недостатки Apache Airflow
Выделим основные преимущества, из-за которых в качестве инструмента для создания процессов обработки данных часто выбирается именно Apache Airflow.
Интеграции
Платформа предоставляет возможности для использования различного стека при построении архитектуры рабочих процессов, например, исполнители CeleryExecutor и KubernetesExecutor. Airflow также поддерживает интеграции с отечественными и зарубежными системами хранения и анализа данных (например, ClickHouse, MySQL, PostgreSQL, MongoDB, Redis, Apache Hive, Apache Spark, Apache Hadoop, объектное хранилище S3).
Экосистема
Airflow — платформа с открытым исходным кодом, распространяемая по лицензии Apache 2.0 и развиваемая сообществом. Платформа также имеет достаточно подробную документацию, включающую в себя информацию не только об основах, но и тонкой настройке инструмента под свои нужды, а информацию об ошибках и практиках применения легко найти в открытых источниках в силу популярности платформы.
Кастомизация
Публичный интерфейс позволяет расширить и настроить почти любой аспект Airflow, включая собственные операторы, плагины и исполнители.
Масштабируемость
Модульная архитектура и удаленные исполнители (CeleryExecutor, KubernetesExecutor и другие) позволяют распределять задачи по множеству воркеров.
Гибкость процессов
Процессы описываются кодом на Python, что позволяет генерировать их динамически, а параметризация встроена через шаблонизатор Jinja.
Мониторинг
У платформы есть свой веб-интерфейс, который позволяет просматривать, запускать и отлаживать графы и задачи, а также изучать логи и историю запусков, а сам Airflow публикует метрики (например, о работе исполнителей и времени разбора графов). Помимо встроенного интерфейса для интеграции с Prometheus доступен плагин airflow-exporter. При этом несмотря на весомые преимущества, как и любой инструмент Apache Airflow имеет свои недостатки:
Зависимости
Airflow зависит от большого числа Python-библиотек, поэтому устанавливать его рекомендуется с файлами ограничений версий, можно упереться в конфликты зависимостей. Провайдеры для интеграций ставятся и обновляются отдельно, а библиотеки, нужные задачам, должны быть совместимы с окружением самого Airflow на воркерах, если не изолировать задачи через виртуальные окружения или контейнеры.
Потоковая обработка данных
Сам по себе Airflow создан для конечных пакетных процессов и не является решением для потоковой обработки: каждый запуск графа — это ограниченный во времени пакет задач. Для обработки данных в реальном времени его обычно сочетают со стриминговыми системами вроде Apache Kafka, а сам Airflow периодически обрабатывает уже накопленные пакеты.
Развертывание
Даже самая простая установка включает несколько компонентов (планировщик, Dag-процессор, API-сервер, базу метаданных, а при необходимости триггерер и воркеры), и все это нужно разворачивать, настраивать и обновлять самостоятельно, что требует ресурсов и времени.
Написание кода DAG
Графы описываются только кодом на Python, несмотря на то, что данный язык считается простым в освоении, порог вхождения из-за написания кода все равно становится выше.
Аналоги
Несмотря на то, что инструменты для создания централизованных конвейеров данных и автоматизации задач являются новой категорией инструментов, с момента появления потребности в них появилось несколько достойных вариантов.
Чаще всего упоминают Prefect, Dagster, Luigi и рассматриваемый нами Apache Airflow. Сравним эти инструменты по нескольким критериям:
| Apache Airflow | Prefect | Dagster | Luigi | |
| Подход к построению workflows | Подход «workflows as code» — пайплайны определяются кодом, появляется динамическая параметризация и генерация графов. | Рабочие процессы рассматриваются как независимые объекты, которые могут быть запущены в любое время, с любым параллелизмом и по любой причине. | Использует декларативный подход: пользователи описывают не порядок задач, а структуру данных и зависимостей между активами. | В отличие от систем вроде Airflow, где DAG задается явно, в Luigi граф строится «снизу вверх» (от финальной задачи к исходной) на основе цепочки ожидаемых файлов. |
| Масштабируемость | Поддерживает работу с большими объемами данных и задач. | Поддерживает параллелизм задач через TaskRunners. | Поддерживает несколько исполнителей (k8s, celery) для горизонтального масштабирования. | Количество одновременных рабочих процессов ограничено из-за связи DAG-задач с внешним планировщиком, отсутствует возможность автоматически распределять задачи между работниками. |
| Экосистема и интеграции | Открытый исходный код, подробная документация и большое количество плагинов для интеграции с внешними инструментами. | Достаточно молодой проект с открытым исходным кодом, но не таким большим сообществом разработчиков. | Платформа с открытым исходным кодом и небольшим сообществом, подробной документацией. | Разработан изначально в компании Spotify и открыт в виде open source инструмента в 2012 году, имеет подробную документацию и до сих пор поддерживается. |
| Мониторинг | Имеет как встроенные средства мониторинга, так и инструменты для интеграции с внешними сервисами (Prometheus). | Позволяет контролировать рабочий процесс в Prefect Cloud через готовый веб-интерфейс. | Встроенный веб-интерфейс с панелью для мониторинга. | Встроенный веб-интерфейс, менее наглядный и удобный для использования, чем у конкурентов. |
| Входной порог | Требует навыков программирования на Python и понимание концепции DAG. | Требует навыков программирования на Python. | Требует навыков программирования на Python. | Требует навыков программирования на Python и работы с внешними планировщиками. |
Чем может помочь Selectel
Если не хочется разворачивать Airflow на своем сервере, его можно запустить в облачном сервере Selectel. Для этого достаточно создать в панели управления сервер с подходящей конфигурацией и образом ОС. Серверу назначается публичный IP-адрес, а удобно подключаться к нему можно по SSH-ключу. Дальше на сервере можно произвести все манипуляции, описанные ранее и получить работающий и доступный по сети Airflow.
Заключение
Apache Airflow стал одним из самых популярных инструментов управления процессами работы с данными, и это вполне заслуженно. Его главная сила в том, что процессы описываются обычным кодом на Python, поэтому их легко версионировать, тестировать и гибко настраивать под любую задачу. Архитектура платформы позволяет начать с простой установки на одной машине и постепенно перейти к распределенному кластеру, когда объем работы вырастет.
Благодаря огромному числу готовых интеграций Airflow легко встраивается в уже существующую инфраструктуру, будь то базы данных, облачные сервисы или инструменты обработки данных. Для регулярных пакетных процессов, от простых выгрузок до сложных цепочек обработки данных, за время своего существования он стал надежным и проверенным выбором. Развернуть его можно как на собственном сервере, так и в облаке, поэтому попробовать Airflow в деле может практически любая команда.