Pinterest и Intel создали сквозную систему профилирования для распределенных сервисов
Вычислительные мощности Pinterest насчитывают сотни тысяч инстансов, обеспечивающих работу сервиса для 640 млн активных пользователей в месяц. Сервисы компании написаны на языках Java, Python, C++, Go и Node.js. Ранее инженеры применяли разрозненный набор инструментов, куда входили, например, perf, async-profiler и py-spy. Это приводило к фрагментации данных и усложняло сопоставление профилей между разными языками и машинами.
Вместо разработки закрытой внутренней системы Pinterest объединила усилия с Intel, чтобы доработать gProfiler и передать внесенные изменения обратно в open-source проект. Доработки включили динамическое профилирование, сбор телеметрии на аппаратном уровне, wall-time профилирование и построение flame-графиков на основе счетчиков производительности.
Принцип работы
gProfiler служит уровнем оркестрации поверх существующих инструментов. Агент объединяет общесистемные данные о производительности с профилировщиками сред выполнения: async-profiler для Java и профилированием на базе eBPF для Python. На выходе формируется единый flame graph для всех процессов, запущенных на хосте.
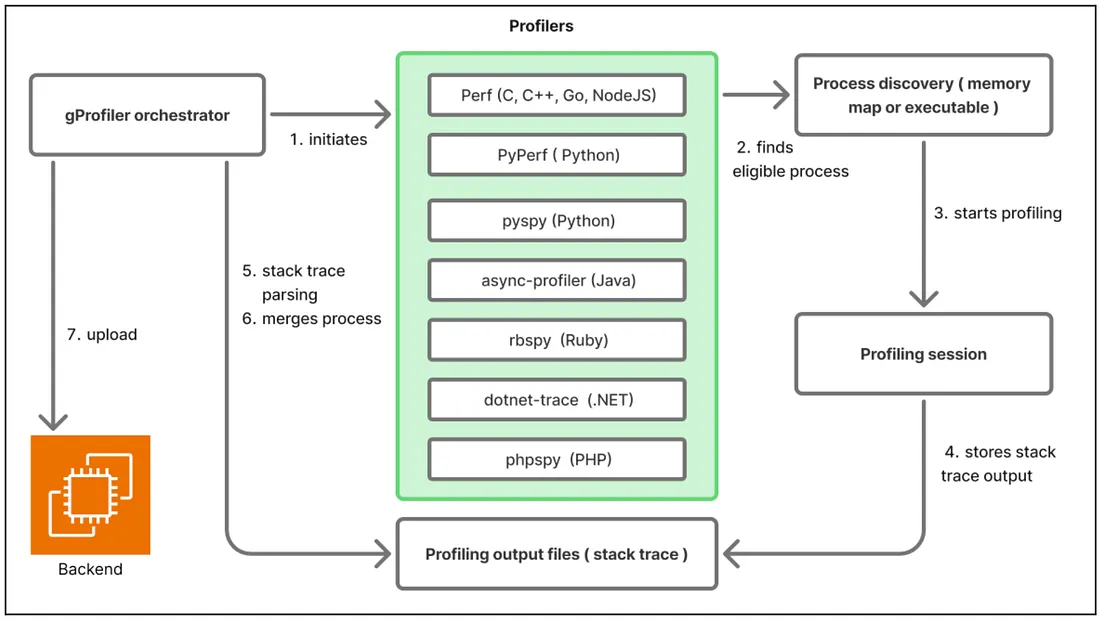
Такой подход решает проблему мониторинга многоуровневых сервисов, когда приложение на Java задействует стек внутри JVM, нативные библиотеки и ядро Linux, а сервис на Python распределяет нагрузку между интерпретатором, нативным кодом и ядром. Агент автоматически обнаруживает процессы, запускает подходящие инструменты профилирования, объединяет трассировки стека и передает готовые профили без изменения исходного кода приложений.
Инженеры могут выбирать отдельные сервисы, хосты или кластеры и запускать профилирование удаленно через интерфейс или API. В режиме ожидания агент потребляет менее 1% ресурсов процессора и до 100 МБ оперативной памяти, получая команды через периодические сигналы проверки связи. Периодичность, длительность и набор используемых инструментов настраиваются без повторного развертывания агента, что избавляет от необходимости подключаться к отдельным серверам через командную строку.
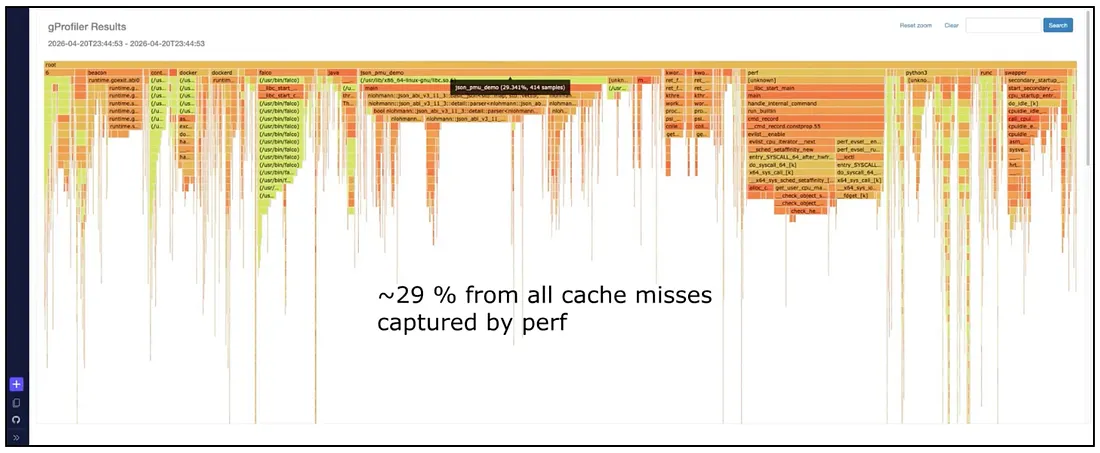
Благодаря интеграции с решением Intel PerfSpect профилировщик собирает метрики на аппаратном уровне. Система фиксирует поведение процессорного кэша, пропускную способность оперативной памяти и задержки конвейера процессора. Для сопоставления функций с событиями оборудования инженеры Pinterest разработали графики PMC flame graph, на которых видны промахи кэша и ошибки предсказания переходов.
Помимо анализа загрузки процессора, в систему добавили wall-time профилирование. Традиционное профилирование фиксирует только время работы процессора, однако сервис может работать медленно и при низкой загрузке CPU, если потоки простаивают в ожидании операций ввода-вывода, освобождения блокировок или завершения удаленных вызовов процедур. Wall-time профилирование делает такие задержки видимыми для инженеров.
Архитектура платформы
Архитектура gProfiler разделяет сбор телеметрии и последующий анализ. Агенты функционируют на отдельных хостах, а компонент gProfiler Performance Studio отвечает за агрегацию и визуализацию профилей.
Собранные профили сохраняются в хранилище S3, проходят через очередь сообщений SQS для асинхронного индексирования и поступают в базу данных ClickHouse для аналитических запросов. Пользовательский интерфейс на React позволяет исследовать flame-графики, а агрегированные данные дают возможность сравнивать профили между разными хостами, сервисами и временными отрезками.
Перед развертыванием системы на всей инфраструктуре компании Pinterest и Intel провели оптимизацию платформы: инженеры ограничили потребление памяти и дискового пространства агентами, а также настроили стабильную обработку входящих потоков данных объемом в несколько терабайт.
При выборе платформы в Pinterest отказались от Intel VTune. Несмотря на детальный анализ архитектуры CPU и кода, VTune проектировался для локальной отладки производительности, а не для сквозного мониторинга распределенных облачных кластеров.