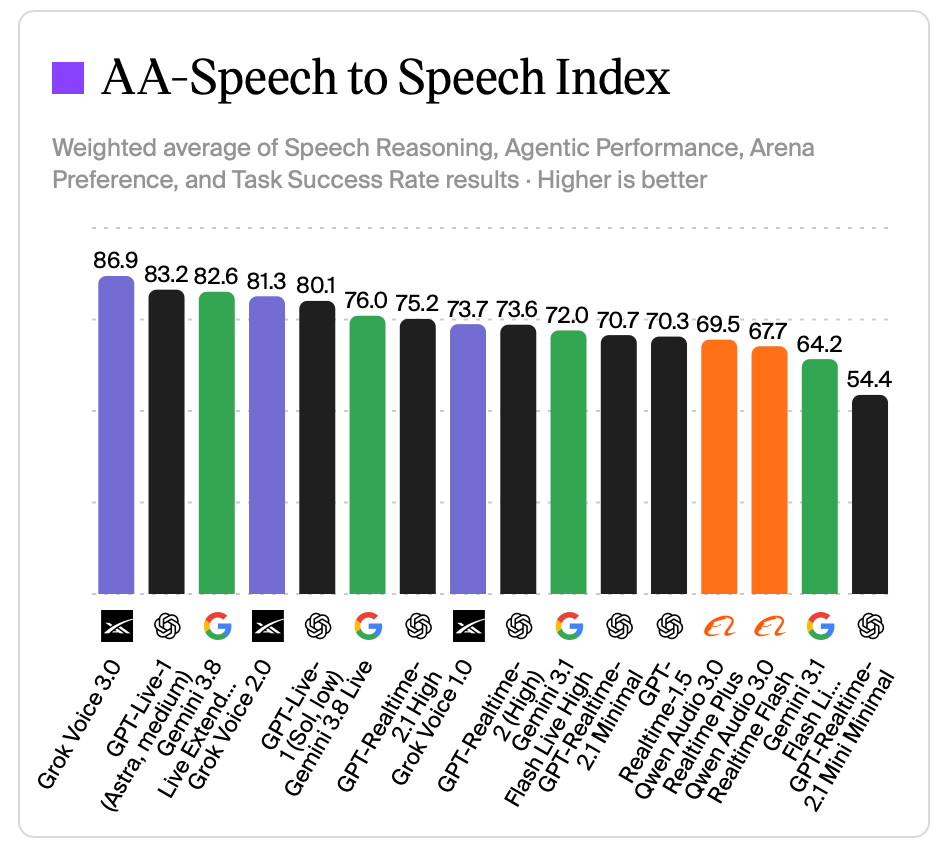
xAI, она же ИИ-компания Илона Маска, 14 октября выпустила Grok Voice 3.0. Это модель, которая принимает речь и сразу отвечает речью, без промежуточного перевода в текст. В рейтинге Speech-to-Speech Index от независимой Artificial Analysis модель набрала 86,9 балла и заняла первое место. Цена в Voice Agent API осталась прежней — 0,08 $ за минуту, или 4,80 $ за час разговора.
Что изменилось по сравнению с 2.0
Прирост равномерный по всем осям. Индекс Artificial Analysis вырос с 81,3 до 86,9. Ближайшие конкуренты — GPT-Live-1 от OpenAI (83,2) и Gemini 3.8 Live от Google (82,6). На Big Bench Audio, тесте рассуждений по голосовому вводу, модель набирает 98,5% против 97,2% у предыдущей версии. На Full Duplex Bench, где проверяют умение держать очередь реплик и реагировать на перебивания, — 97,0% против 95,1%. Рейтинг Эло в Speech Agent Arena, построенный на предпочтениях людей, вырос с 1 011 до 1 070.
Задержка до первого звука составила меньше секунды и на 40% ниже, чем у GPT-Live-1. Архитектуру модели компания не раскрывает, описание ограничивается классическим «speech-to-speech». Измеренных значений задержки в миллисекундах в анонсе тоже нет.
Где Grok Voice проигрывает
На τ-Voice, бенчмарке реальных звонков в поддержку с акцентами, шумом и перебиваниями, Grok Voice 3.0 набирает 71,6%. Собственный график xAI показывает GPT-Live-1 на уровне 74,5%. В анонсе xAI называет точность «сопоставимой», и на этом тесте модель отстает. При этом скачок от предыдущей версии здесь самый большой — с 56,5% до 71,6%. Gemini 3.8 Live с 68,6% остается позади.
Grok Voice быстрее и дешевле, GPT-Live-1 надежнее в самом шумном и сложном сценарии.
Экономика голосового агента
Стоимость одной задачи на Big Bench Audio, по данным Artificial Analysis, — 0,025 $ против 0,030 $ у GPT-Live-1 и 0,055 $ у GPT-Realtime-2.1. Для бизнеса важнее пример внедрения. В колл-центрах Starlink модель обрабатывает около 20 000 звонков в день, примерно 70% закрываются без человека, а каждый четвертый продающий звонок заканчивается покупкой, заявляет xAI. Это цифры внутреннего клиента, Starlink входит в империю Маска, поэтому их стоит воспринимать как демонстрацию возможностей.
Внешняя проверка есть на EVA-Bench, бенчмарке ServiceNow для голосовых агентов на 200+ корпоративных сценариях. Там модель показала 74% точности, лучший опубликованный результат. Нитин Аггарвал из ServiceNow заявил, что Grok Voice 3.0 «задает новую границу Парето» по сочетанию точности и качества обслуживания.
Что это значит
Рынок нативных speech-to-speech моделей стал конкурентным, три вендора идут вплотную, поэтому выбор стоит делать на собственных записях звонков, ориентируясь на τ-Voice и Full Duplex Bench больше, чем на сводный индекс. Агенты на алиасе grok-voice-latest переключились на новую версию автоматически, и тем, кто уже в продакшене, стоит прогнать регрессионные тесты.