Цена осталась на уровне Sonnet 5 — 2 $ за миллион входных и 10 $ за миллион выходных токенов, вдвое дешевле Opus 5.5. По заявлению компании, модель работает более чем на 30% быстрее предшественницы и обходится до 30% дешевле в пересчете на задачу. Внутри делюсь мнением по новости.
Что показывают цифры
Собственные результаты Anthropic выглядят так. На Terminal-Bench 4.0 (агентное программирование в терминале) Sonnet 5.5 набирает 70,6% против 66,4% у Opus 5.5.
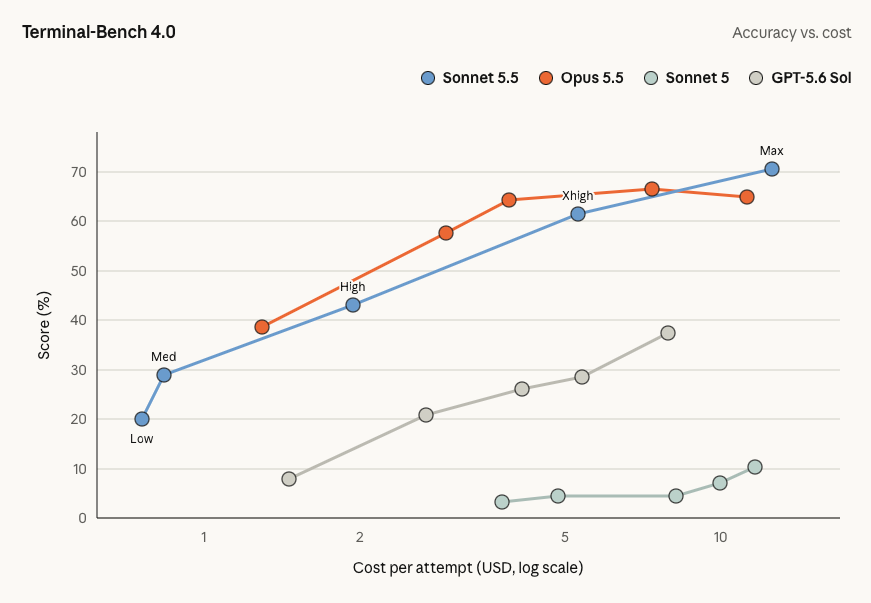
На OSWorld 2.1 (управление компьютером) — 80,1% против 81,8%. В GDPval-AA, тесте на прикладную «офисную» работу, разрыв почти исчез, 1 844 балла у Sonnet 5.5 против 1 846 у Opus 5.5 и 1449 у Sonnet 5.
Независимая лаборатория Artificial Analysis, которая ведет один из самых цитируемых сводных рейтингов моделей, поставила Sonnet 5.5 на второе место своего Intelligence Index с 56 баллами. Выше только Opus 5.5 (58), а GPT-6 Astra от OpenAI с 53 баллами делит третье место с Fable 5.1. Прирост к Sonnet 5 составил 18 пунктов.
Абсолютные значения в замерах расходятся. В прогоне Artificial Analysis на Terminal-Bench 4.0 Sonnet 5.5 получила 63,6%, Opus 5.5 — 59,6%. Порядок моделей совпадает с данными Anthropic, но обе цифры ниже примерно на семь пунктов, что типично для разницы в конфигурации агентной обвязки.
Где подвох
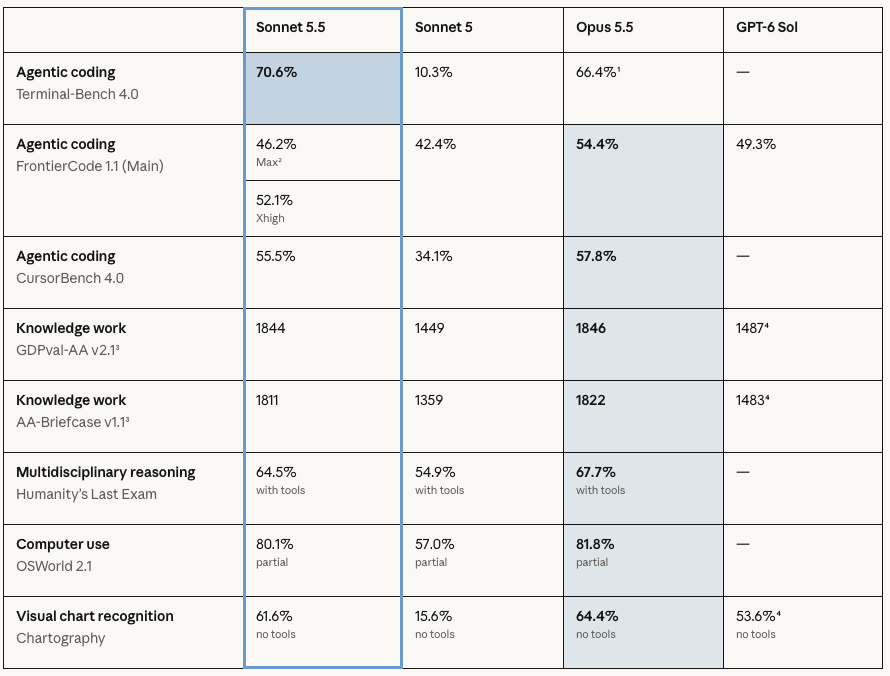
Расхождение касается стоимости. Anthropic обещает до 30% экономии на задачу. Artificial Analysis насчитала, что на максимальном уровне усилий Sonnet 5.5 тратит около 193 000 выходных токенов на задачу. Это примерно на 60% больше, чем у Opus 5.5 или Sonnet 5 на их максимальных настройках, и выливается в 7,60 $ на задачу — примерно на 50% дороже Sonnet 5.
Обе стороны измеряют разные режимы. По данным VentureBeat, Sonnet 5.5 на низком и среднем уровне усилий догоняет лучший результат Sonnet 5 примерно за десятую часть стоимости. Экономия реальна на умеренных настройках, а максимальный режим покупает последние баллы качества очень дорогими токенами.
Слабые места тоже видны. На AA-Omniscience, тесте на фактические знания, Sonnet 5.5 показывает 54% против 66% у Opus 5.5, в научных рассуждениях отстает примерно на шесть пунктов. Модель сильна в действии и слабее в эрудиции.
Безопасность и защита от дистилляции
Sonnet 5.5 стала первой моделью линейки Sonnet с киберзащитами уровня фронтирных моделей. По словам Anthropic, прирост в кибервозможностях достаточно велик, чтобы требовать тех же ограничений, что у Opus 5.5. Появились и классификаторы, блокирующие извлечение цепочек рассуждений. Это ответ на дистилляцию, когда конкуренты обучают свои модели на рассуждениях чужих, и на недавнюю работу исследователей, которые расшифровали 315 320 блоков «мышления» из 6 708 публичных трасс агентов и вытащили оттуда учетные данные и ключи.
Что это дает в перспективе
Для большинства продуктовых сценариев Sonnet 5.5 делает Opus 5.5 избыточной. Разница в два балла индекса не оправдывает двукратной цены токена. Главный рычаг экономии теперь — параметр effort. Запуск на максимуме по умолчанию легко съест весь лимит, поэтому в ближайшие недели стоит прогнать свои eval-тесты на low и medium и повышать уровень только там, где качество действительно проседает.