Языковая модель GPT-6 Astra от OpenAI читает веса другой нейросети, то есть числа, из которых складывается ее поведение, находит в них проблему и исправляет нужные значения напрямую, без обучения на данных.
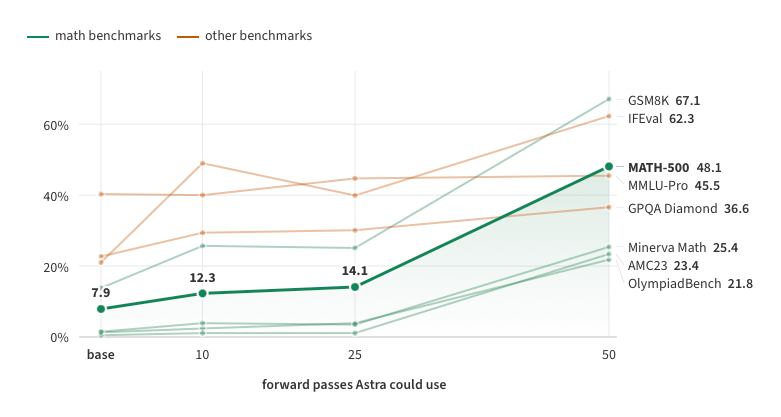
Так, у открытой модели Qwen3.5-0.8B от Alibaba исправили зацикливание в рассуждениях: изменив примерно 0,016% весов, модель подняла результат на MATH-500 с 7,9% до 48,1%.
131 000 весов вместо дообучения
Авторы работы — Рикия Такехи, Джейден Тео, Алекс Чжан и Омар Хаттаб. Хаттаб известен как создатель DSPy и ColBERT, двух широко используемых инструментов для работы с LLM и поиском. Задача формулировалась на естественном языке. Примерно так: улучши математику у Qwen3.5-0.8B, редактируя ее веса. Astra получала промпты и в части экспериментов Python-песочницу, но обучать модель ей было нельзя.
Итог по данным авторов при бюджете в 50 прямых проходов выглядит так:
- параметр MATH-500 поднялся с 7,9% до 48,1%;
- GSM8K — с 13,8% до 67,1%;
- IFEval (следование инструкциям) с 21,0% до 62,3%;
- доля ответов, упершихся в лимит 32 768 токенов, с 93% до 33,1%.
Последняя строка объясняет все остальное. Маленькая Qwen проваливала задачи, потому что зацикливалась в рассуждениях и не доходила до ответа.
Те же результаты Qwen3.5-0.8B до и после правки весов в виде таблицы. Источник.
Как модель нашла поломку
Astra проследила зацикливание до конкретного направления в пространстве активаций, которое записывают MLP-блоки в слоях 15 и 19. Затем она вычла это направление из 64 выходных столбцов в каждом из двух слоев. Получилось 131 072 измененных веса, или те самые 0,016% модели. Для проверки и уточнения правок ей понадобилось до 50 прямых проходов. При бюджете в 10 или 25 проходов петли в основном сохранялись.
Фактически это механистическая интерпретируемость, которую раньше делали люди с ноутбуками и неделями анализа, выполненная моделью за один сеанс. Техника вычитания направлений давно известна по работам о steering-векторах и отключении отказов. Новое в том, что направление модель нашла сама, по задаче, которую ей описали словами.
Где метод упирается в потолок
Авторы уже показали границу, с Gemma 3 270M от Google тот же подход не сработал, потому что эта модель редко зацикливается и чинить в ней было нечего. Их вывод сформулирован с опаской. Правка весов умеет убрать препятствие, которое мешает модели проявить уже имеющуюся способность, но добавить способность, которой у модели нет, не может.
Это важно, так как рост с 7,9% до 48,1% на MATH-500 выглядит как чудо, пока не вспомнишь, что базовая модель почти всегда обрывалась на лимите токенов. Значительная часть прироста — это модель, которой наконец дали договорить. Независимого воспроизведения пока нет, а эксперименты ограничены моделями до миллиарда параметров.
Зачем это нужно знать
Для тех, кто разворачивает маленькие открытые модели на своем железе, открывается дешевая альтернатива дообучению в узком классе задач. Если модель ломается из-за одного поведенческого дефекта вроде зацикливания, повторов или срыва формата, локальная правка нескольких слоев обходится в лишние прогоны на инференсе. LoRA требует датасета и GPU-часов.
Обратная сторона тоже понятна. Если фронтирная модель умеет точечно менять поведение чужих весов, она умеет и встраивать закладки. На прошлой неделе группа с участием Николаса Карлини показала, что 0,1% отравленных данных при претрейне достаточно для бэкдора в CLI-агенте на базе Qwen3-4B с успешностью около 92%. Вместе эти работы делают проверку происхождения весов открытых моделей такой же обязательной процедурой, как проверку контрольных сумм у пакетов.